
Linux. Полное руководство.
Глава 19. Маршрутизация и межсетевые экраны.
19.1. Введение в маршрутизацию.
Маршрутизация является очень ответственным механизмом, отвечающим за то, как будет происходить обмен данными, как будут пролегать информационные потоки. Скорость и эффективность обмена данными во многом зависят от того пути, по которому они следуют от одного компьютера сети к другому.
Маршрутизация имеет смысл в сильно разветвленных сетях и основывается на использовании таблиц маршрутизации. Такая таблица имеется на каждом узле, выступающем в роли маршрутизатора. В ней содержится информация об окружающих узлах и известных маршрутах, на основе которой маршрутизатор будет выбирать оптимальный путь для передачи данных.
При оценке и выборе маршрута используются так называемые метрики стоимости. В качестве такой метрики выступают какие-либо критерии, по которым можно оценить маршрут. Различные протоколы маршрутизации могут использовать различные метрики, то есть выбирать оптимальный маршрут, основываясь на анализе разных параметров. Рассмотрим основные протоколы маршрутизации:
♦ RIP — один из старейших протоколов маршрутизации, разработанный компанией Xerox. Метрикой стоимости у этого протокола является количество переходов, которое должен совершить пакет данных от отправителя к получателю. Этот протокол разрабатывался во времена небольших сетей, поэтому все узлы, находящиеся на расстоянии больше 15 переходов, он воспринимает как недосягаемые. Это значит, что в сетях, в которых в одну цепочку могут быть выстроены более 15 маршрутизаторов, использовать протокол RIP нельзя. Данный протокол использует в своей работе демон routed, который будет рассмотрен чуть позднее.
♦ RIP-2 представляет собой улучшенную версию протокола RIP. Одно из основных улучшений заключается в том, что вместе с адресом следующего перехода передается сетевая маска. Благодаря этому упрощается управление сетями, в которых есть подсети.
♦ OSFP является самым популярным и широко используемым протоколом маршрутизации. В его основе лежит специальный математический алгоритм, который позволяет высчитывать оптимальные маршруты. Этот протокол является топологическим, то есть учитывающим состояние канала. По сравнению с RIP он обладает следующими достоинствами: возможностью управления несколькими маршрутами и возможностью разделения сети на сегменты, которые будут предоставлять друг другу только высокоуровневые данные маршрутизации. Этот протокол рекомендуется использовать в сетях с разветвленной структурой, в которой может возникать большое количество дублирующихся маршрутов.
Следует понимать разницу между маршрутизацией и перенаправлением трафика. Маршрутизация представляет собой сложный процесс просчета и выбора наилучшего на данный момент маршрута. При этом используется большое количество входной информации, основывающейся как на предыдущем опыте работы маршрутизатора, так и на текущем состоянии сети. Значительная часть этой информации предоставляется соседними узлами, поэтому синхронизация таблиц маршрутизации у соседних узлов представляет собой существенную проблему.
Перенаправление трафика же является простой операций, направляющей пакеты данных в соответствии с определенным условием. Никакого выбора и расчета при этом не производится. Можно сказать, что перенаправление — это простейший (статический) метод маршрутизации. Мы рассмотрим его в параграфе, посвященном брандмауэрам.
19.2. Программы маршрутизации в Linux.
19.2.1. Демон routed.
Стандартной программой маршрутизации в Linux является демон routed. Этот демон, как правило, настраивается сам (динамически) и не требует конфигурирования. Обнаруженные маршруты он заносит в маршрутную таблицу ядра.
В своей работе демон routed использует протокол RIP. Чтобы воспользоваться преимуществами протоколов RIP-2 или OSFP, вы должны использовать другой демон — gated. Демон routed может работать либо в режиме сервера (-s), либо в режиме подавления сообщений. Во втором режиме он будет только получать от соседей маршрутную информацию, но сам ее отсылать не будет.
Для добавления статических маршрутов вручную служит команда route. Рассмотрим пример такого маршрута. Пусть у нас есть две сетевые платы eth0 и eth1:
# ifconfig eth0 192.168.1.1 up.
# ifconfig eth0 192.168.2.1 up.
И нам нужно обеспечить маршрутизацию между подсетями 192.168.1.0 и 192.168.2.0. С этой целью объявляем, что машины, которые находятся в вашем локальном сегменте 192.168.1.*, «сидят» на первом интерфейсе и общаться с ними нужно напрямую:
# route add net 192.168.1.0 192.168.1.1 netmask 255.255.255.0 0.
А с машинами с адресами 192.168.2.* будем разговаривать через eth1:
# route add net 192.168.2.0 192.168.2.1 netmask 255.255.255.0 0.
Последний аргумент команды route — это метрика. Ее можно понимать как «расстояние до шлюза назначения» или «сколько пересадок между шлюзами придется сделать пакету по пути туда и обратно». T.к. адреса 192.168.1.1 и 192.168.2.1 являются нашими собственными адресами, то это расстояние равно нулю.
Сетевые пакеты для IP-адресов, которые не лежат в нашей локальной сети, будем отправлять на машину 192.168.1.11, а она сама будет разбираться, что с ними делать:
# route add default 192.168.1.11 1.
Таким образом мы объявили маршрут по умолчанию со значением метрики, равным 1.
Не забудьте только добавить вызовы команды route в загрузочный сценарий, потому что при перезагрузке правила маршрутизации ядра теряются.
Забегая несколько вперед, замечу, что такой статический маршрут представляет собой обычное правило перенаправления трафика, поэтому его можно реализовать и средствами пакетного фильтра IPTables:
# iptables -P FORWARD DROP.
# iptables -A FORWARD -S 192.168.1.0/24 -d 192.168.2.0/24 -j ACCEPT.
# iptables -A FORWARD -S 192.168.2.0/24 -d 192.168.1.0/24 -j ACCEPT.
А вот более сложный пример, приведенный в документации по IPTables. Пусть у нас имеется одно-единственное соединение с Интернетом и мы не хотим, чтобы кто-либо вошел в нашу сеть извне:
## Загрузим модули для отслеживания соединений.
# (не нужно, если они встроены в ядро).
# insmod ip_conntrack.
# insmod ip_conntrack_ftp.
## Создадим цепь block, которая будет блокировать.
# соединения извне.
# iptables -N block.
# iptables -A block -m state --state ESTABLISHED,RELATED -j ACCEPT.
# iptables -A block -m state --state NEW -i ! ppp0 -j ACCEPT.
# iptables -A block -j DROP.
## Весь входящий и маршрутизированный трафик будет.
# проходить через block.
# iptables -A INPUT -j block.
# iptables -A FORWARD -j block.
19.2.2. Демон gated — правильный выбор.
В последнее время демон gated используется чаще, чем стандартный routed. Объясняется это тем, что gated более гибок в конфигурировании и обладает большими возможностями, в частности, им поддерживаются протоколы RIP-2 и OSFP.
Программа gated была разработана группой американских университетов для работы сети NFSNET. Она позволяет организовать многофункциональный шлюз, обслуживающий как внутреннюю, так и внешнюю маршрутизацию. На данный момент gated поддерживает следующие протоколы маршрутизации:
♦ RIP версий 1 и 2.
♦ HELLO.
♦ OSPF версии 2.
♦ EGP версии 2.
♦ BGP версии 2, 3 и 4.
Таблица 19.1 поможет вам сравнить возможности демонов routed и gated.
Протоколы, поддерживаемые gated и routed Таблица 19.1.
| Демон | Протоколы внутренних маршрутизаторов | Протоколы внешних маршрутизаторов | |||
|---|---|---|---|---|---|
| RIP | HELLO | OSPF | BGP | EGP | |
| routed | V1 | – | – | – | – |
| gated, версий 2 | V1 | + | – | V1 | + |
| gated, версия 3 | V1, V2 | + | V2 | V2, V3 | + |
Рассмотрим классическое подключение локальной сети к Интернету. Пусть адрес нашей локальной сети 143.100.100.0, а на шлюзе установлены две сетевые платы с IP-адресами 143.100.100.1 и 143.100.200.1. Пусть в нашей сети есть машина с IP-адресом 143.100.100.5, на которой также установлен gated. Настроим gated сначала на этой рабочей станции, а потом — на сервере. Для настройки может использоваться утилита gdc, поставляемая вместе с самим gated.
Настройка gated осуществляется путем редактирования файла конфигурации /etc/gated.conf. Содержимое этого файла для рабочей станции приведено в листинге 19.1, а для сервера — в листинге 19.2.
Листинг 19.1. Файл конфигурации /etc/gated.conf для рабочей станции.
# Это IP-адрес рабочей станции.
Interface 143.100.100.5 passive;
# используем протокол RIP (Route Internet Protocol).
Rip yes;
Листинг 19.2. Файл конфигурации /etc/gated.conf для сервера.
# Описываем интерфейсы и протокол.
Interface 143.100.100.1 passive;
Interface 143.100.200.1 passive;
Rip yes;
Export proto rip interface 143.100.100.1.
{
proto direct {
announce 143.100.200.0 metric 0;
};
};
Export proto rip interface 143.100.200.1.
{
proto rip interface 143.100.100.1 {
announce all;
};
};
Первая директива export объявляет подсеть 143.100.100.0 (наша сеть) через интерфейс 143.100.100.1, который объявляется шлюзом в данную подсеть, то есть считается, что интерфейс 143.100.100.1 принадлежит узлу, входящему в эту сеть. Директива proto direct говорит о том, что пакеты для подсети нужно посылать непосредственно на интерфейс, а нулевая метрика означает, что интерфейс стоит на шлюзе в подсеть.
Вторая директива export сообщает всем узлам подсети через интерфейс 143.100.200.1 все маршруты, которые данный шлюз получает из подсети 143.100.100.0 через интерфейс 143.100.100.1.
При написании директив export внешняя конструкция всегда определяет интерфейс, через который сообщается информация, а внутренняя — источник, через который эту информацию будет получать gated.
Рассмотрим пример из документации по gated, в котором нашу сеть через подсеть подключают к Интернету (листинг 19.3).
Листинг 19.3. Подключение через подсеть.
Rip yes;
Export proto rip interface 136.66.12.3 metric 3.
{
proto rip interface 136.66.1.5.
{
announce all;
};
};
Export proto rip interface 136.66.1.5.
{
proto rip interface 136.66.12.3.
{
announce 0.0.0.0;
};
};
Первая директива export говорит о том, что gated получает все, что передается в подсеть, связывающую данную сеть с Интернетом, через интерфейс 136.66.12.3 (речь идет о маршрутах, а не о самих данных).
Вторая директива export определяет место назначения — куда по умолчанию нужно отправлять информацию из сети, чтобы она достигла адресата, который расположен за пределами локальной сети. Адрес 0.0.0.0, соответствующий любой машине за интерфейсом 136.66.12.3, определяется через интерфейс 136.66.1.5 для всей локальной сети.
После настройки gated нужно перезапустить:
# service gated restart.
19.3. Расширенные средства маршрутизации. Комплекс iproute2.
19.3.1. Пакет iproute2.
Начиная с версии ядра 2.2, сетевая подсистема Linux была значительно переработана, в нее было добавлено много новых возможностей — управление трафиком, маршрутизация на основе правил и т.п. Доступ к этим возможностям предоставляется пакетом iproute2, входящим в состав большинства современных дистрибутивов.
В случае необходимости можно скачать этот пакет с сайта ftp://ftp.inr.ас.ru./ip-routing.
19.3.2. Утилита ip.
Утилита ip, входящая в состав пакета iproute2, объединяет в себе все возможности команд ifconfig, arp и route. Формат ее вызова такой:
Ip [ключи] объект [команда [аргументы команды]].
Ключи можно указывать следующие:
♦ -s — вывод статистической информации;
♦ -f — выбор протокола:
• -f inet — протокол IPv4;
• -f inet6 — протокол IPv6;
• -f link — сетевое устройство;
♦ -r — разрешать IP-адреса в имена узлов;
♦ -V — печать версии программы.
Аргумент Объект позволяет выбрать объект, с которым будем работать:
♦ адрес — IPv4 или IPv6 адрес устройства;
♦ link — устройство;
♦ neighbour — ARP-адрес;
♦ route — маршрутизация;
♦ rule — база данных правил маршрутизации;
♦ madress — широковещательный адрес;
♦ tunnel — туннель через IP.
Аргумент Команда описывает действие над Объектом:
♦ ip link — конфигурация сетевого устройства;
♦ ip link set — изменение параметров сетевого устройства;
♦ ip link show — просмотр параметров сетевого устройства.
При изменении параметров сетевого устройства вы можете задать следующие аргументы:
♦ up — включить;
♦ down — выключить;
♦ arp on или arp off — изменение флага NOARP на устройстве;
♦ dynamic on или dynamic off — изменяет флаг DYNAMIC на устройстве;
♦ multicast on или multicast off — изменяет флаг MULTICAST на устройстве;
♦ name — изменяет имя устройства;
♦ mtu <Число> — изменяет значение MTU на устройстве;
♦ address <Адрес> — изменяет адрес на устройстве;
♦ broadcast <Адрес> — изменяет широковещательный адрес на устройстве.
19.3.3. Просмотр параметров сетевого устройства.
Команду ip link show лучше всего рассматривать на примерах. Для получения информации о состоянии устройства eth0 введите команду:
# ip link ls dev eth0.
Eth0: mtu 1500 qdisc cbq qlen 100.
Link/ether 00:44:67:91:31:1d brd ff:ff:ff:ff:ff:ff.
Получить статистику устройства eth0 можно командой:
#ip -s link ls dev eth0.
2: eth0: mtu 1500 qdisc cbq qlen 100.
Link/ether 00:44:67:91:31 brd ff:ff:ff:ff:ff:ff.
RX: bytes packets errors dropped overrun mcast.
Xxxxxxxx xxxxxx 0 0 0 0.
TX: bytes packets errors dropped carrier collsns.
Xxxxxxxx xxxxxx 0 0 0 132934.
Вместо xxxxxxxx xxxxxx вы увидите количество принятых(RX)/переданных(TX) байтов и пакетов.
19.3.4. Операции над адресами: команда ip address.
Команда ip address управляет адресами на устройстве. Объект для нее — это IPv4 или IPv6 адрес. Эта команда показывает адреса и их свойства, а также добавляет новые адреса.
Чтобы добавить адрес 192.168.0.1/24 с маской подсети 255.255.255.0 со стандартным широковещательным адресом и именем eth0:Alias, введите команду.
# ip addr add 192.168.0.1/24 brd + dev eth0 label eth0:Alias.
Используются еще следующие варианты команды:
Ip address delete предназначена для удаления адресов. Для удаления адреса 192.168.0.1/24 с устройства eth0 введите команду ip addr del 192.168.0.1/24 dev eth0.
Ip address show выводит информацию об адресе.
19.3.5. Управление таблицей маршрутизации.
Команда ip route управляет таблицей маршрутизации:
Ip route add — добавить новый маршрут;
Ip route change — изменить маршрут;
Ip route replace — заменить маршрут.
Добавим маршрут к сети 192.168.0.0/24 через 192.168.1.1:
# ip route add 192.168.0.0/24 via 192.168.1.1.
19.3.6. Динамическая маршрутизация.
Команда ip route позволяет добавить динамический маршрут; шлюз будет выбираться в зависимости от текущей нагрузки на нега. Всегда будет выбираться шлюз с минимальной нагрузкой.
Пусть у нас есть два устройства — ppp0 и ppp1. Маршрут по умолчанию — через устройство ppp0, но если этот маршрут недоступен, будет использоваться ppp1:
# ip route add default scope global nexthop \
Dev ppp0 nexthop dev ppp1.
Для удаления маршрута используйте команду ip route delete:
# ip route del default scope global nexthop \
# dev ppp0 nexthop dev ppp1.
19.3.7. Управление правилами маршрутизации.
Для решения этой задачи предназначена команда ip rule. Маршрутизация производится в зависимости от:
♦ адреса получателя;
♦ адреса отправителя;
♦ IP-протокола;
♦ транспортного протокола.
По умолчанию используются три таблицы правил маршрутизации:
♦ Local — содержит таблицы для локальных и широковещательных адресов;
♦ Main — самая обыкновенная таблица маршрутизации;
♦ Default — пустая таблица по умолчанию.
Аргументы команды ip rule:
1. адрес отправителя;
2. адрес назначения;
3. имя интерфейса, с которого получен пакет;
4. метка пакета, которая устанавливается брандмауэром;
5. идентификатор таблицы маршрутизации: им может быть номер или строка из файла /etc/iproute2/rt_tables;
6. приоритет таблицы (число).
Вот несколько примеров. Требование пересылать пакеты с сети 192.168.0.0/24 согласно таблице Main:
# ip rule add from 192.203.80.0/24 table main prio 100.
Теперь допустим, что у нас есть два канала в Интернет (два провайдера): ppp1 с адресом 193.168.99.99, который связан с 193.168.99.100, и ppp2 с адресом 193.168.100.99, связанный с 195.1.1.1. Пользователь ivanov хочет, чтобы мы его пакеты отправляли через ppp2 (второго провайдера):
# echo 200 ivanov >> /etc/iproute2/rt_tables.
# ip rule add from 192.168.0.10 table ivanov.
# ip rule ls.
0: from all lookup local.
32765: from 192.168.0.10 lookup ivanov.
32766: from all lookup main.
32767: from all lookup default.
Теперь для этого пользователя назначим маршрут по умолчанию и очистим кэш-таблицы маршрутизации, чтобы наши изменения вступили в силу:
# ip route add default via 195.1.1.1 dev ppp2 table ivanov.
# ip route flush cache.
Рассмотрим еще один практический пример. Направим весь трафик на порт 21 через устройство eth1:
# iptables -A PREROUTING -i eth0 -t mangle -p tcp --dport 21 -j MARK --set-mark 2.
Теперь нужно создать правила для помеченных пакетов.
# echo 202 21,tbl >> /etc/iproute2/rt_tables.
# ip rule add fwmark 2 table 21.tbl.
# ip route add default via 192.168.0.10 dev eth1 table 21.tbl.
# ip route flush cache.
19.4. Что такое брандмауэр.
Брандмауэр (межсетевой экран, бастион, firewall) — это компонент системы, обеспечивающий защиту сети от несанкционированного доступа.
Как известно, весь трафик в сети состоит из пакетов. Каждый пакет состоит из двух частей: заголовка и тела. В заголовке пакета находится информация об источнике, адресате, типе пакета, а также прочая информация, которая характерна для пакетов определенных типов. В теле пакета находится собственно передаваемая информация. Так вот, брандмауэр представляет собой пакетный фильтр: он просматривает заголовок каждого проходящего через него пакета, а потом решает, что с этим пакетом делать: принять, игнорировать или отказать с уведомлением отправителя.
Обычно брандмауэр используется на шлюзах, соединяющих две сети. Например, на шлюзе между локальной сетью и Интернетом можно запретить передавать или принимать пакеты некоторых категорий, отграничив таким образом свою хорошо организованную сеть от всемирного хаоса.
Фильтрация пакетов встроена в ядро ОС Linux. В старых дистрибутивах (ядро 2.2 и ниже) стандартным брандмауэром служит IPChains, в новых (ядро 2.4 и выше) — IPTables. Оба они позволяют защититься от таких распространенных атак, как пинг смерти, атака на отказ, IP-спуфинг, фрагментация пакетов. Возможности пакетного фильтра IPTables значительно шире, чем у IPChains, но на практике дополнительные возможности используются редко — в основном применяются средства, присутствовавшие уже в IPChains. Поэтому я начну изложение принципов и приемов настройки брандмауэра с этого устаревшего фильтра.
19.5. Цепочки правил.
Ядро стартует с тремя списками правил: input, forward, output. Эти правила называются firewall-цепочками или просто цепочками. Цепочка — это набор правил вида «заголовок пакета: действие». Если заголовок пакета соответствует заголовку, указанному в правиле, выполняется заданное в правиле действие. Если первое правило к этому пакету неприменимо, то рассматривается следующее правило в цепочке. Если ни одно правило не применимо к пакету, то пакет, скорее всего, будет отвергнут. Если какой-нибудь пакет отвергается, то сообщение об этом протоколируется службой syslog.
Пакет, поступающий извне, сначала проходит предварительную проверку. Она включает в себя сверку контрольной суммы (не поврежден ли пакет при пересылке) и «санитарную проверку» (не нарушит ли некорректный пакет работу кода проверки правил). Поврежденные и некорректные пакеты отвергаются.
Принятый пакет поступает на входной фильтр (цепочка input). Если входной фильтр пропускает пакет, то код маршрутизации проверяет адрес получателя, после чего пакет либо передается локальному процессу, либо маршрутизируется на другую машину. Пакет, предназначенный для другой машины, должен пройти через цепочку перенаправления forward. Если правила этой цепочки разрешают пакет, он будет маршрутизирован, в противном случае — отвергнут. Пакет также будет отвергнут, если ядро не поддерживает маршрутизации.
Прежде чем пакет выйдет из сетевого интерфейса, он должен пройти цепочку output. Любая программа может отправить пакет, который будет направлен в эту цепочку. Если она пропускает пакет, то он попадет в сеть — станет исходящим пакетом. Отвергнутый пакет не выйдет за пределы компьютера — он будет уничтожен.
Пакет, предназначенный для интерфейса lo (обратная петля или шлейфовый интерфейс), сначала проходит выходную цепочку, а потом попадает во входную цепочку интерфейса lo. Прохождение пакета через цепочки правил схематично представлено на рис. 19.1.
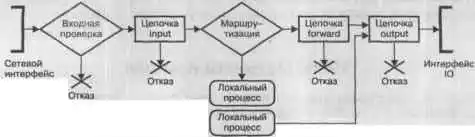
Рис. 19.1. Принцип работы пакетного фильтра.
19.6. IPTables — пакетный фильтр для ядер 2.4.x. и 2.6.x.
Фильтр IPTables, очень похожий на IPChains, называется так потому, что хранит цепочки правил в таблицах. Главной таблицей, в которой хранятся правила обработки всех стандартных типов трафика, является таблица filter. Именно с ней мы и будем работать. К стандартным таблицам относятся также:
♦ таблица nat — используется для построения NAT-преобразователей;
♦ таблица mangle — задает типы преобразования некоторых пакетов.
Для просмотра содержимого таблицы служит следующая команда:
Iptables -L -t <имя_таблицы>
19.6.1. Что изменилось в IPTables по сравнению с IPChains.
♦ Имена стандартных цепочек INPUT, OUTPUT и FORWARD теперь пишутся в верхнем регистре. Имена пользовательских цепочек по соглашению пишутся строчными буквами и могут иметь длину до 31 символа.
♦ Действие «отклонить пакет» теперь называется не DENY, a DROP.
♦ Действие MASQ называется MASQUERADE.
♦ Для перенаправления пакетов на пользовательское устройство используется цель QUEUE (раньше для этого использовалась опция -о).
♦ Опция -i теперь означает входящий интерфейс и работает только в цепочках INPUT и FORWARD. Правила в цепочках FORWARD и OUTPUT, которые использовали опцию -i, следует переписать с использованием опции -о.
♦ Если обнулить встроенную (стандартную) цепочку, то очистятся также и счетчики политик.
♦ Правила для протоколов TCP и UDP должны использоваться вместе с флагами --source-port и --destination-port (--sport и --dport). Эти флаги должны использоваться только с указанием протокола, например, -p tcp.
♦ Опция -y теперь называется --syn и должна указываться после флага -p.
♦ Действия REJECT и LOG реализованы отдельными модулями ядра.
19.6.2. Настройка ядра Linux для поддержки IPTables.
Новые параметры конфигурации ядра, включающие поддержку IPTables, я представил в таблице 19.3. Возможно, в вашем дистрибутиве некоторые из них отключены, тогда вам придется пересобрать ядро. Следующая глава подробно рассказывает о том, как это сделать.
Параметры конфигурации ядра Таблица 19.3.
| Параметр | Назначение |
|---|---|
| CONFIG_IP_NF_IPTABLES | Необходим для работы IPTables. Не включив этот параметр, вы вообще не сможете использовать IPTables |
| CONFIG_ PACKET | Позволяет использовать программы, которые работают непосредственно с сетевым устройством. Примером такой программы может послужить tcpdump |
| CONFIG_NETFILTER | Включите этот параметр, если вы собираетесь использовать ваш компьютер в качестве шлюза. |
| CONFIG_IP_NF_CONNTRACK | Позволяет отслеживать соединений. Этот параметр необходим для работы функций NAT или IP-маскарадинга. На компьютере-шлюзе включите этот параметр |
| CONFIG_IP_NF_FTP | Из-за большого количества FTP-запросов модуль IP_NF_CONNTRACK не в состоянии проследить все FTP-соединения, поэтому в помощь ему добавлен модуль CONFIG_IP_NF_FTP, отслеживающий только FTP-соединения. Включите этот параметр, если на вашем компьютере установлен FТР-сервер |
| CONFIG_IP_NF_MATCH_LIMIT | Необязательный параметр. Позволяет ограничить количество пакетов, передаваемых/принимаемых за определенный промежуток времени |
| CONFIG_IP_NF_MATCH_MAC | Позволяет блокировать пакеты, используя MAC-адрес (а не IP-адрес) |
Все остальные опции, связанные с IPTables, содержат в своем названии слово MATCH, например, CONFIG_IP_NF_MATCH_MAC. Эти опции разрешают выполнять над пакетами определенные действия.
Фильтр IPTables может загружаться как модуль при первом запуске iptables, а может быть встроен в ядро постоянно (что рекомендуется). Модуль фильтра filter называется iptable_filter.o.
У вас может быть установлен модуль ipchains.o и соответствующий ему сервис — ipchains. Этот модуль несовместим с iptables, поэтому вы должны выбрать, какой из них вы будете использовать.
19.6.3. Первичная настройка IPTables. Задание политики по умолчанию.
Если к пакету не может быть применено ни одно правило из стандартной цепочки, то судьбу этого пакета определяет политика цепочки — действие по умолчанию. Значением политики может быть либо ACCEPT (принять), либо DROP (отклонить), либо REJECT (отклонить с уведомлением источника). Первоначально встроенные цепочки не содержат ни одного правила, а политикой имеют ACCEPT, поэтому первое, что нужно сделать, — это установить в целях безопасности действие DROP:
# iptables -P INPUT DROP.
# iptables -P OUTPUT DROP.
# iptables -P FORWARD DROP.
19.6.4. Действия над цепочками.
Рекомендуется создавать отдельные цепочки для различных объектов фильтрации. Это позволяет логически группировать правила. Для создания новой цепочки используется опция -N, за которой следует имя новой цепочки (напоминаю, что имена пользовательских цепочек пишутся строчными буквами):
Iptables -N имя_цепочки.
Ключи программы iptables, предназначенные для манипуляций с цепочками и правилами в них, точно такие же, как у программы ipchains (таблица 19.2).
19.6.5. Правила фильтрации.
Задание правил фильтрации IPTables похоже на задание правил в IPChains. Для создания правила используется опция --append (или -А). После этой опции указывается имя цепочки и критерий выбора пакетов в этой цепочке. Затем указывается опция --jump (или -j), значением которой служит действие (ACCEPT, DROP и т.п.):
Iptables -A INPUT критерий_выбора -j действие.
В качестве критерия выбора обычно указываются либо порты, либо IP-адреса, либо MAC-адрес. По этим параметрам и будет «вылавливаться» пакеты из цепочки. Можно задать сразу несколько критериев выбора, перечислив их друг за другом.
Фильтрация по портам, IP-адресу и MAC-адресу в IPTables задается с помощью следующих критериев выбора:
♦ -p протокол — задает протокол, по которому будет производиться отбор пакетов. Может принимать значение all, что означает «все протоколы»;
♦ -s адрес (или --source адрес) — задает исходный IP-адрес, по которому будет производиться отбор пакетов. В качестве значения может указываться сетевая маска или порт;
♦ -d адрес (или --destination адрес) — задает IP-адрес получателя, по которому будет производиться отбор пакетов. В качестве значения может указываться сетевая маска или порт;
♦ -i интерфейс — задает входной интерфейс (eth0, ppp0 и т.п.), с которого будет производиться отбор пакетов. Этот критерий работает только в цепочках INPUT и FORWARD. При задании интерфейса может использоваться знак «+», означающий «все интерфейсы заданного типа». Например, запись ppp+ означает все интерфейсы ppp (ppp0-pppN);
♦ -о интерфейс — задает выходной интерфейс (eth0, ppp0 и т.п.), с которого будет производиться отбор пакетов. Способ задания такой же, что и для предыдущего случая. Этот критерий работает только в выходных цепочках (OUTPUT);
♦ --sport порт[:порт] (или --source-port порт[:порт]) — задает исходный порт или диапазон исходных портов, по которому будет производиться отбор пакетов. Эта опция может использоваться только после опций -p tcp или -p udp. Диапазон портов задается номером первого и конечного портов, разделенных двоеточием;
♦ --dport порт [:порт] (или --destination-port порт[:порт]) — задает порт назначения или диапазон портов назначения, по которому будет производиться отбор пакетов. Эта опция может использоваться только после опций -p tcp или -p udp. Диапазон портов задается номером первого и конечного портов, разделенных двоеточием;
♦ --port порт [,порт] — позволяет задать порты, которые будут восприниматься и как порты источника, и как порты назначения. Использование этого критерия возможно только после использования -p tcp или -p udp и опции -m multiport;
♦ -m состояние — задает состояние соединения. В качестве состояния возможно указание большого количества вариантов. За подробной информацией обращайтесь к справочной системе. Некоторые варианты использования данного критерия приведены ниже, на практических примерах;
♦ --mac-source мак_адрес — задает MAC-адрес, по которому будет производиться отбор пакетов. Возможно только после использования критерия -m mac.
Рассмотрим теперь практические примеры. Выделить пакеты, приходящие от узла с MAC-адресом 11:12:13:14:15:16, можно с помощью правила:
Iptables -A INPUT --mac-source 11:12:13:14:15:16 -j ...
Потом вы уже сами определите действие после опции -j. Если же нам нужно выделить все пакеты, кроме тех, которые присылает узел с этим MAC-адресом, то нужно использовать символ инверсии «!».
IPTables позволяет указывать несколько портов (не больше 15) через запятую, например:
Iptables -A INPUT -p tcp -m multiport --sport 22,53,80,110 -j ...
Вместо портов источника вы можете указать порты назначения, используя опцию --dport.
Если вы хотите одновременно указать как порты источника, так и порты назначения, используйте опцию --port:
Iptables -A INPUT -p tcp -m multiport --port 22,53,80,110.
19.6.6. Фильтрация по отдельным пользователям.
Если IPChains умел отфильтровывать только пакеты, исходящие от определенного компьютера, то теперь мы можем выделять пакеты отдельных пользователей. Для этого предназначены следующие критерии, которые могут использоваться только для исходящих пакетов в цепочке OUTPUT:
♦ --uid-owner UID — отбор пакетов по UID пользователя;
♦ --gid-owner GID — отбор по группе (GID);
♦ --pid-owner PID — отбор по идентификатору процесса;
♦ --sid-owner SID — отбор по идентификатору сеанса.
Например, выделить все пакеты, исходящие от пользователя с UID 500, можно так:
Iptables -A OUTPUT -m owner --uid-owner 500.
Аналогично мы можем ограничивать исходящие пакеты группы или процесса:
Iptables -A OUTPUT -m owner --gid-owner 0.
Iptables -A OUTPUT -m owner --pid-owner 78.
Естественно, мы можем сделать это только для исходящих пакетов, поскольку мы не знаем, какой UID имеет пользователь другой системы: информация об этом не передается по протоколу TCP.
- 1.
- 2.
- 3.
- 4.
- 5.
- 6.
- 7.
- 8.
- 9.
- 10.
- 11.
- 12.
- 13.
- 14.
- 15.
- 16.
- 17.
- 18.
- 19.
- 20.
- 21.
- 22.
- 23.
- 24.
- 25.
- 26.
- 27.
- 28.
- 29.
- 30.
- 31.
- 32.
- 33.
- 34.
- 35.
- 36.
- 37.
- 38.
- 39.
- 40.
- 41.
- 42.
- 43.
- 44.
- 45.
- 46.
- 47.
- 48.
- 49.
- 50.
- 51.
- 52.
- 53.
- 54.
- 55.
- 56.
- 57.
- 58.
- 59.
- 60.
- 61.
- 62.
- 63.
- 64.
- 65.
- 66.
- 67.
- 68.
- 69.
- 70.
- 71.
- 72.
- 73.
- 74.
- 75.
- 76.
- 77.
- 78.
- 79.
- 80.
- 81.
- 82.
- 83.
- 84.
- 85.
- 86.
- 87.
- 88.
- 89.
- 90.
- 91.
- 92.
- 93.
- 94.
- 95.
- 96.
- 97.
- 98.
- 99.
- 100.
- 101.
- 102.
- 103.
- 104.
- 105.
- 106.
- 107.
- 108.
- 109.
- 110.
- 111.
- 112.
- 113.
- 114.
- 115.
- 116.
- 117.
- 118.
- 119.
- 120.
- 121.
- 122.
- 123.
- 124.
- 125.
- 126.
- 127.
- 128.
- 129.
- 130.
- 131.
- 132.
- 133.
- 134.
- 135.
- 136.
- 137.
- 138.
- 139.
- 140.
- 141.
- 142.
- 143.
- 144.
- 145.
- 146.
- 147.
- 148.
- 149.
- 150.
- 151.
- 152.
- 153.
- 154.
- 155.
- 156.
- 157.
- 158.
- 159.
- 160.
- 161.
- 162.
- 163.
- 164.
- 165.
- 166.
- 167.
- 168.
- 169.
- 170.
- 171.
- 172.
- 173.
- 174.
- 175.
- 176.
- 177.
- 178.
- 179.
- 180.
- 181.
- 182.
- 183.
- 184.
- 185.
- 186.
- 187.
- 188.
- 189.
- 190.
- 191.
- 192.
- 193.
- 194.
- 195.
- 196.
- 197.
- 198.
- 199.
- 200.
- 201.
- 202.
- 203.
- 204.
- 205.
- 206.
- 207.
- 208.
- 209.
- 210.
- 211.
- 212.
- 213.
- 214.
- 215.
- 216.
- 217.
- 218.
- 219.
- 220.
- 221.
- 222.
- 223.
- 224.
- 225.
- 226.
- 227.
- 228.
- 229.
- 230.
- 231.
- 232.
- 233.
- 234.
- 235.
- 236.
- 237.
- 238.
- 239.
- 240.
- 241.
- 242.
- 243.
- 244.
- 245.
- 246.
- 247.
- 248.
- 249.
- 250.
- 251.
- 252.
- 253.
- 254.
- 255.
- 256.
- 257.
- 258.
- 259.
- 260.
- 261.
- 262.
- 263.
- 264.
- 265.
- 266.
- 267.
- 268.
- 269.
- 270.
- 271.
- 272.
- 273.
- 274.
- 275.
- 276.
- 277.
- 278.
- 279.
- 280.
- 281.
- 282.
- 283.
- 284.
- 285.
- 286.
- 287.
- 288.
- 289.
- 290.
- 291.
- 292.
- 293.
- 294.
- 295.
- 296.
- 297.
- 298.
- 299.
- 300.
- 301.
- 302.
- 303.
- 304.
- 305.
- 306.
- 307.
- 308.
- 309.
- 310.
- 311.
- 312.
- 313.
- 314.
- 315.
- 316.
- 317.
- 318.
- 319.
- 320.
- 321.
- 322.
- 323.
- 324.
- 325.
- 326.
- 327.
- 328.
- 329.
- 330.
- 331.
- 332.
- 333.
- 334.
- 335.
- 336.
- 337.
- 338.
- 339.
- 340.
- 341.
- 342.
- 343.
- 344.
- 345.
- 346.
- 347.
- 348.
- 349.
- 350.
- 351.
- 352.
- 353.
- 354.
- 355.
- 356.
- 357.
- 358.
- 359.
- 360.
- 361.
- 362.
- 363.
- 364.
- 365.
- 366.
- 367.
- 368.
- 369.
- 370.
- 371.
- 372.
- 373.
- 374.
- 375.
- 376.
- 377.
- 378.
- 379.
- 380.
- 381.
- 382.
- 383.
- 384.
- 385.
- 386.
- 387.
- 388.
- 389.
- 390.
- 391.
- 392.
- 393.
- 394.
- 395.
- 396.
- 397.
- 398.
- 399.
- 400.
- 401.
- 402.
- 403.
- 404.
- 405.
- 406.
- 407.
- 408.
- 409.
- 410.
- 411.
- 412.
- 413.
- 414.
- 415.
- 416.
- 417.
- 418.
- 419.
- 420.
- 421.
- 422.
- 423.
- 424.
- 425.
- 426.
- 427.
- 428.
- 429.
- 430.
- 431.
- 432.
- 433.
- 434.
- 435.
- 436.
- 437.
- 438.
- 439.
- 440.
- 441.
- 442.
- 443.
- 444.
- 445.
- 446.
- 447.
- 448.
- 449.
- 450.
- 451.
- 452.
- 453.
- 454.
- 455.
- 456.
- 457.
- 458.
- 459.
- 460.
- 461.
- 462.
- 463.
- 464.
- 465.
- 466.
- 467.
- 468.
- 469.
- 470.
- 471.